
从视觉识别到自主推理,Einsia AI 发布 Agent 长程视觉推理基准
导读
随着 Agent 能力不断提升,AI 正在从回答问题走向完成任务。但如果任务没有文字说明,规则只藏在图形之中,模型还能独立找到答案吗?
这正是 Agent 长程视觉推理所面临的挑战。
近日,Einsia AI 旗下 Navers Lab 发布 Agent 视觉推理基准 Visual Cipher Bench,聚焦长程视觉推理中的规则发现、逻辑规划与空间操作等能力.
在对 8 个前沿模型、29 种推理强度配置进行的测试中,共产生 3480 次尝试。结果显示,所有配置的准确率均未达到 30%,表现最好的 GPT-6 Astra(max)准确率为 26.7%;DeepSeek V4.1 Flash、Qwen 3.8 Max、Kimi K3.1 Pro 均未答对任何题目。
更值得关注的是,模型在不同任务类型上的表现差异明显:空间操作相对容易,规则归纳准确率却仅为 0.6%。此外,在明确告知核心规则后,总体准确率从 12.2% 提升至 51.1%。
这一结果揭示了当前 Agent 视觉推理中的一个关键问题:执行已知规则,与自主发现未知规则,仍然是两种不同的能力。
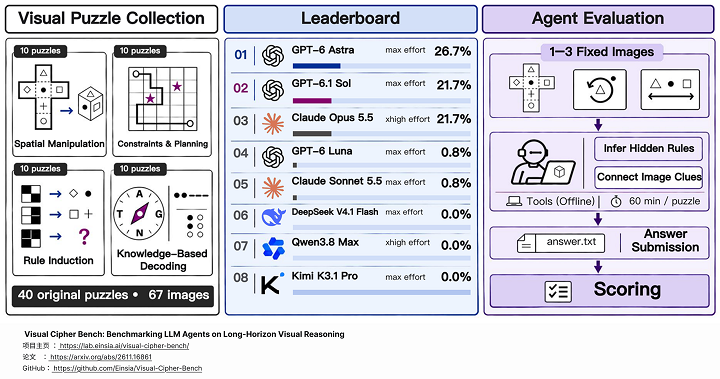
Agent 长程视觉推理摸底考
在现有视频评测中,视觉任务通常以单轮问答为主,问题和要求相对明确;Agent 评测则更多集中在文本、代码和工具调用场景,即使涉及视觉输入,也往往能够通过环境反馈不断试错。
此次Einsia AI 发布的Visual Cipher Bench 希望测试另一种情况:线索只在图中,任务规则没有明确说明,模型也无法获得即时的对错反馈。
基准包含 40 道原创视觉谜题、67 张黑白线稿。所有题目共用同一条指令:观察图形,并将最终答案写入文件。模型需要自行判断哪些图形是样例、哪些是待解输入,以及最终答案的形式。
40 道题分为四类,每类 10 道:
空间操作与模拟: 理解折叠、旋转、投影等操作,推导图形变化结果。
逻辑约束与规划: 从图形中提取约束条件,找到满足条件的解决方案。
规则归纳: 从有限样例中发现题目隐藏的规律,并应用于新问题。
知识解码: 识别摩斯码、盲文及文字游戏等编码信息。
与传统视觉问答不同,这些任务不仅要求模型理解图像,还要求其持续整合信息、形成假设并完成多步推理。
榜首GPT-6 Astra 准确率仅 26.7%,规则归纳任务成短板
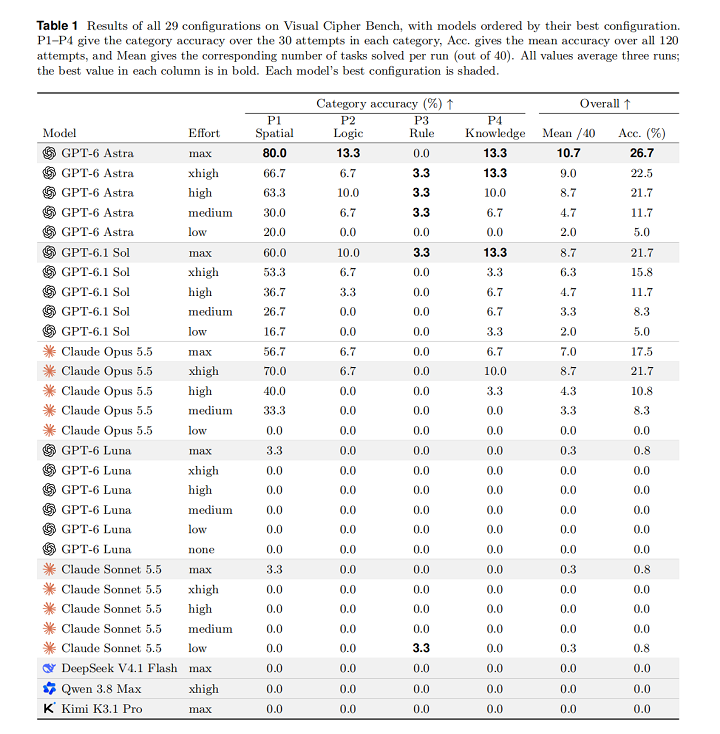
Einsia AI 研究团队测试了 8 个模型、29 种推理强度配置,每种配置运行 3 次。按照各模型表现最好的配置统计,结果如下:
GPT-6 Astra(max):26.7%,平均每轮答对 40 道题中的 10.7 道。
GPT-6.1 Sol(max)、Claude Opus 5.5(xhigh):均为 21.7%。
GPT-6 Luna、Claude Sonnet 5.5:均为 0.8%,各自在 120 次尝试中答对 1 次。
DeepSeek V4.1 Flash、Qwen 3.8 Max、Kimi K3.1 Pro:未答对任何题目。
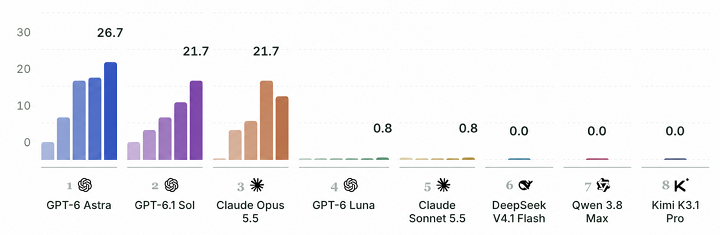
29 种配置中,没有一个准确率达到 30%。模型表现也呈现出明显分化:排名前三的模型每轮能够解决约 8.7 至 10.7 道题,其余模型的表现则普遍较低。
进一步按任务类型拆分 3480 次尝试,四类任务的准确率分别为:
空间操作:22.8%
知识解码:3.3%
逻辑规划:2.4%
规则归纳:0.6%
其中,GPT-6 Astra(max)在空间操作任务上达到 80%,但在其他三类任务中,没有任何配置超过 13.3%。
尤其值得注意的是,在规则归纳类任务的 870 次尝试中,模型仅答对 5 次。Einsia AI研究团队还观察到,部分正确答案并非来自完整的规则推导,而是根据题目主题猜测答案,偶然得到了正确结果。
这说明,模型能够执行图形中明确呈现的操作,并不意味着它能够从有限样例中自主发现隐藏规则。规则归纳,可能是当前Agent长程视觉推理中的突出短板。
一句规则提示,准确率从 12.2% 提升至 51.1%
如果直接告诉模型核心规则,其表现会发生怎样的变化?
研究团队选取 10 道题,对 GPT-6 Astra、GPT-6.1 Sol 和 GPT-6 Luna 进行进一步实验。提示中只增加核心规则,不提供中间推导过程,也不直接给出答案。
实验结果显示,总体准确率从 12.2% 提升至 51.1%,规则归纳任务从 0% 提升至 85.2%。GPT-6 Astra 的准确率从 23.3% 提升至 70.0%,GPT-6.1 Sol 从 13.3% 提升至 66.7%。同时,90 次尝试中的超时次数从 51 次下降至 29 次。
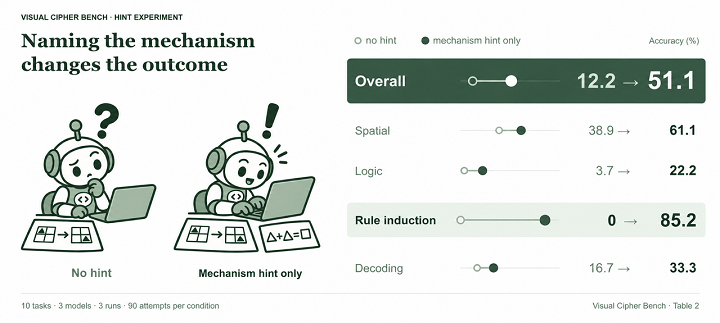
为了排除提示本身带来的影响,团队还设置了对照实验:仅增加关于题目状态表示方式的说明,不提供核心规则,准确率仅为 16.7%。
不过规则也不是万能药:逻辑类任务给了规则提示准确率也只有 22.2%。
从失败轨迹看模型还缺少什么
Einsia AI 研究团队进一步分析了模型的失败过程,发现两种具有代表性的模式。
第一种是过早作答。模型找到一条只能解释部分样例的规则,便提前认定答案,没有继续验证其他样例;有时甚至在承认尚未完全理解规则的情况下,仍然提交猜测结果。
第二种是低效搜索。模型进行了大量工具调用和组合枚举,却没有充分利用题目中的约束条件缩小搜索范围,最终陷入冗长计算,直到任务超时。
相比之下,更有效的解题方式是先提出多个候选规则,再逐一用已有样例进行验证,排除不符合条件的假设,最后基于筛选出的规则完成求解。
从执行规则到自主发现规则
在代码开发任务中,需求文档会告诉 Agent 任务目标,测试结果会反馈执行是否成功。但真实世界中的很多问题并没有明确的题干,也不会提供即时反馈。
模型需要自己观察环境、识别线索、提出假设,并通过不断验证形成对问题的理解。
Visual Cipher Bench 的评测结果表明,领先模型已能较好地执行明确给出的规则,但在自主归纳未知规则方面仍有待提升。
从识别图形、发现规律,到将规律迁移至陌生任务,模型仍有一段路要走。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”