MOSS-Live 是什么?一文看懂模思智能的全双工实时交互系统
电影《流浪地球》中,主角和 MOSS 对话几乎没有 "机器感":想到哪说到哪,打断、附和、改口都被自然接住。对照之下,现实里的语音助手还常露出生硬的痕迹:你话没说完它就抢答,随口应个 "嗯" 它反倒沉默,聊到别的再绕回来,它又接不上之前的话题。
这些问题的根源在于交互方式。目前不少语音 AI 仍接近半双工:用户说完、它再说,双方轮流发言,听和说很难同时进行。而真实对话并不整齐划一,人会停顿、插话、改主意,交流的同时还在接收周围环境的信息。有没有一款语音智能体能把对话做得更接近电影里的样子?
2026 年 11 月 2 日,模思智能发布了 MOSS-Live(全双工实时交互系统)。它在说话的同时持续倾听,实时理解用户的对话意图和交流节奏,判断何时回应、何时等待、何时保持沉默。它还具备持续的多模态感知能力,支持视频通话、屏幕共享和环境声音理解,并能在实时对话中调用工具、异步执行复杂任务,做到边看、边听、边聊、边做事。
MOSS-Live 官方宣传片画面
技术架构:让实时对话与复杂任务并行
什么是全双工?
全双工原本是通信术语,指通信双方可以同时进行双向传输。电话是全双工的,两头能同时听、同时说;对讲机是半双工的,同一时刻只有一方能讲话。
放到语音交互上,全双工的要求比边听边说更高:AI 要在持续倾听的过程中实时理解语义、说话意图和对话状态,判断何时回应、何时等待、何时接受打断、何时保持沉默。MOSS-Live 要解决的核心问题就在这里:让 AI 更自然、更智能、更主动地参与实时交流。
前后台协同架构
为了兼顾实时交互对响应速度的要求和复杂任务的处理能力,MOSS-Live 采用前后台协同架构,把实时交互和复杂任务执行交给不同的模型分工处理,再通过记忆、上下文和任务状态管理实现协同。实时对话与复杂任务可以并行开展,在保持交互流畅的同时,兼顾深度推理与任务执行能力。
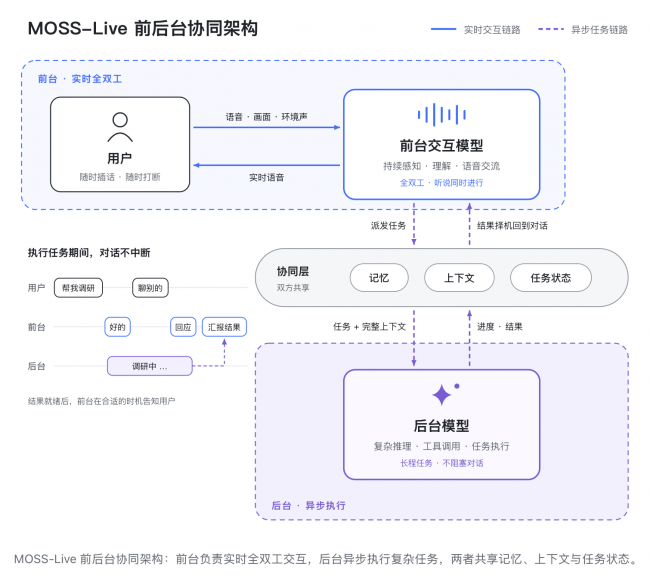
前台交互模型负责实时交互:持续接收语音、画面及环境声音,理解当前对话状态,并决定何时倾听、何时回应、何时等待。
后台模型负责复杂推理与长程任务执行:当用户提出需要更深度思考或长程复杂任务的请求,前台可以将任务连同对话上下文交给后台模型,由后台异步执行。在此期间,前台仍然可以继续与用户交流,而不必等待后台任务完成。
两者通过记忆、上下文和任务状态管理保持协同:前台可以掌握后台任务的进展,并在合适的时机将结果带回对话。随着用户不断提供新的语音、画面和环境信息,交互过程也可以相应调整。
六项全双工交互指标上,MOSS-Live 排在所列 6 个系统第一
MOSS-Live 官方公布的评测覆盖全双工交互、语音理解、多轮对话及工具调用等关键维度,包含 6 个评测集、36 项指标。参与对比的有 6 个系统:MOSS-Live、OpenAI 的 GPT Realtime 2.1 和 GPT-Live-1、豆包的 Seeduplex,以及通义的 Qwen Audio 3.0 Plus 和 Qwen Audio 3.0 Flash。
6 个评测集分别是 Full-Duplex-Bench 系列的 FDB v1、v1.5、v2、v3,以及 Big-Bench Audio 和 τ-Voice,都是研究机构和企业公开发布的评测集。36 项指标中,MOSS-Live 有 14 项排在所列 6 个系统第一,其中 2 项为并列。
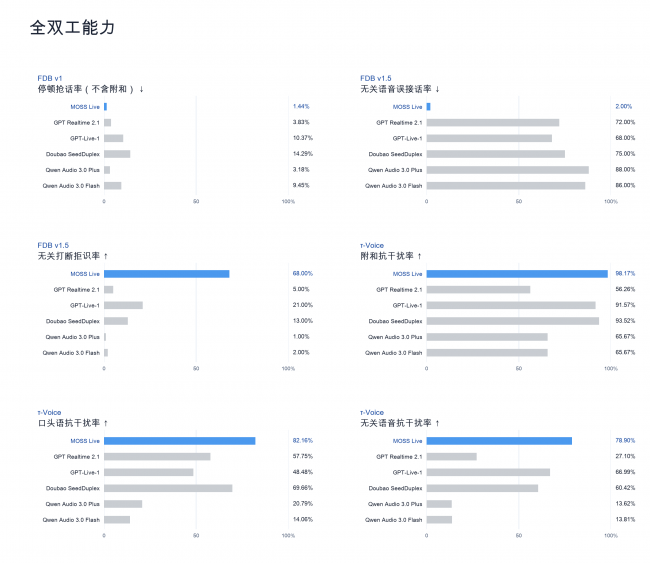
全双工能力评测图
上图比的是全双工能力:六项交互指标各用一组横向柱状图比较 6 个系统,蓝色柱是 MOSS-Live,六项都排第一。
在 FDB 系列测试中,MOSS-Live 展现出较强的对话节奏控制与无关声音拒识能力。其中,停顿抢话率仅为1.44%,无关语音误接话率低至2%,无关打断拒识率达到68%,均为参评模型中的最佳表现。
在 τ-Voice 测试中,MOSS-Live 的附和抗干扰率达到98.17%,口头语抗干扰率达到82.16%,无关语音抗干扰率达到78.90%,三项指标均领先于其他参评模型。这意味着 MOSS-Live 能够更准确地区分有效打断与无关声音,减少因停顿、附和或环境干扰造成的交互中断。
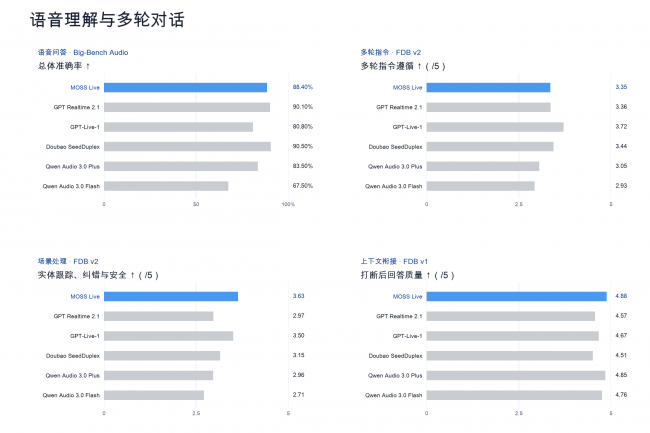
语音理解与多轮对话评测图
在 FDB v1 的打断后回答质量指标上,MOSS-Live 获得 4.88 分(满分 5 分);在 FDB v2 涵盖实体跟踪、纠错与安全的综合指标上,得分为 3.63 分(满分 5 分),两项均为本次对比中的最高分。
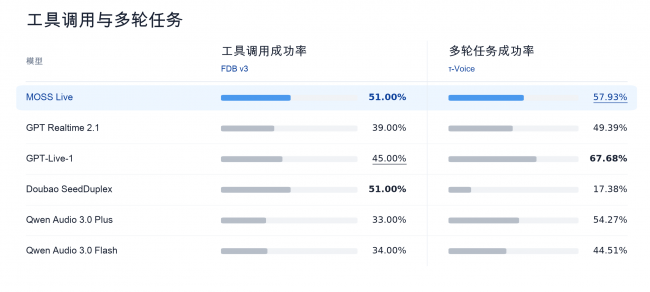
工具调用与多轮任务评测图
在工具调用和多轮任务成功率这两项测试中,MOSS-Live 的成绩也位居前列。在 FDB v3 工具调用评测中,MOSS-Live 的成功率为 51%,和 Doubao SeedDuplex 并列最高,在τ-Voice的多轮任务评测中,MOSS-Live 的成功率为 57.93%,仅次于 GPT-Live-1。
真实场景演示:MOSS-Live 如何参与日常生活
为了直观呈现实际使用中的交互表现,官方选了几个有代表性的场景,展示 MOSS-Live 在全双工对话、多人讨论和复杂任务执行方面的综合能力。公开的三段各有侧重:会议室看多人讨论,车里看抗干扰和话题切换,街头看边看边聊。
会议室里的 AI 参会者
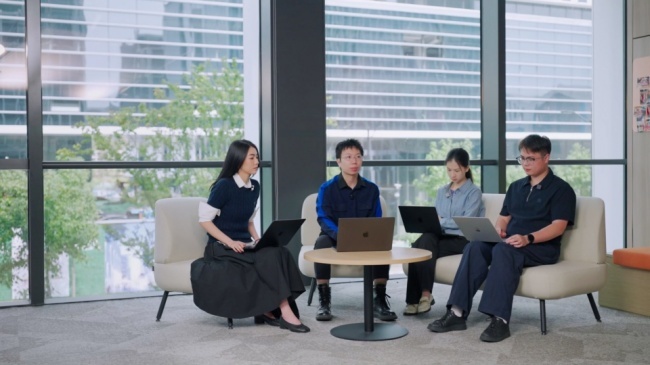
多人会议演示画面
会议是多人同时说话的场合:有人发言,有人附和,有人随时插进新问题。这段演示看的是 MOSS-Live 能不能像一位参会者那样跟上讨论,分清附和与打断,查资料时对话不断,隔了几轮还接得上之前的上下文。
演示中的会议在讨论活动方案,MOSS-Live 以 AI 参会者的身份接入。有人请它查上海、杭州的天气和同期的大型活动,查的过程中被打断,它按新增的信息调整查询范围,查完后主动加入讨论。有人随口附和,它没有中断发言;另一位同事提出新问题,它及时停下来回应;几轮之后有人重新问起先前提到的杭州活动,它依然接得上。会议结束时,它根据讨论内容整理出初步结论和后续待办。
放到日常的会议里,AI 的角色可以从会后整理纪要,变成会上就能出力的参与者:讨论到哪里,资料查到哪里;有人提出新想法,查询范围跟着调整;散会时结论和待办已经整理好。团队讨论、项目评审、远程协作这类多人场合,今后都可以有这样一位随时接得上话的 AI 参会者。
开车途中的 AI 助理
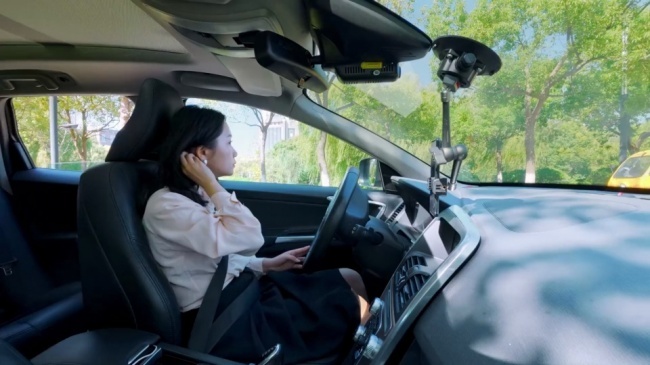
自驾游演示画面
车里是语音交互的典型环境,也是容易出错的环境:驾驶者腾不出手和眼,想法随时会变,导航的声音还不时插进来。这段演示看的是 MOSS-Live 在这种环境下能不能稳定地陪用户把一件事办完。
用户边开车边让 MOSS-Live 规划一次去舟山的两天自驾游,中途把计划从爬山改成海边放松,MOSS-Live 随即调整行程,后台接着查酒店。之后用户多次打断,穿插着问船票、停车费用和住宿选择;话题来回切换,等用户需要时,它仍能从之前中断的位置接着介绍路线。车载导航的声音响了好几次,它都判断为无关声音,没有中断回复。
对驾驶者来说,好处是全程不用动手,也不用为了让 AI 听懂而把话一次说完整:计划可以边想边改,问题可以想到就问,被打断的内容随时接得回来。行程规划、沿途订房、临时改道这些事,都有机会在开车途中靠说话办完。
让 AI 当个随身向导
上海旅行演示画面
街头的对话离不开眼前的画面:游客想问的那栋楼就在面前,光靠语言却很难说清是哪一栋。这段演示看的是 MOSS-Live 能不能结合摄像头里的实时画面,和用户聊眼前的东西,讲解被打断后还接得上。
一位外国游客用英语让 MOSS-Live 规划上海的游览路线,然后举起手机问眼前的建筑,MOSS-Live 结合实时画面认出和平饭店,讲起它的历史。讲到一半,游客想了解酒店的房价和餐饮,它转去查询并回答;等游客问起刚才被打断前说到哪里了,它接着往下讲。
旅途中的问题大多是看到了才想起来问的:这栋楼是什么,附近哪里吃饭,刚才讲到哪了。MOSS-Live 把看、听、查、讲放在同一次对话里,讲解跟着游客的视线和兴趣走。逛展、认路、接待外国访客,这类需要边走边看边问的场合,都适合有一位随身的向导。
从轮流说话,走向更自然的全模态实时交互
全模态实时交互代表了下一代 AI 交互的演进方向,模型不仅要同时「看见」和「听见」,还要在交互过程中持续感知、理解、表达与行动。围绕这一方向,MOSS-Live 将全双工对话、多模态感知、主动交互与任务执行能力相结合,探索更加自然、流畅的实时交互体验。
自然流畅的全双工对话
-语义打断:分得清附和与主动打断,用户简短应一声时不中断输出,明确打断时及时响应。
-语义判停:按语义判断用户有没有把话说完,句中停顿或思考时先等着,不过早接话。
-区分说话对象与无关拒识:分得清哪些话是对它说的,旁人闲聊、自言自语和设备播放的声音不会误触发它。
-自然附和:根据对方说的内容和对话节奏,在合适的时候给一句简短回应。
-断点续说与记忆:被多次打断、换过话题之后,仍记得被打断时讲到哪里,可以接着说。
主动交互
MOSS-Live 可以按用户的要求主动开口。官方举了两个例子:让它在背诵过程中及时纠错;让它在会议讨论中留意某些重要事项,在合适的时机提醒。它会持续关注对话内容,满足事先说好的条件时再介入。
边聊边做事
MOSS-Live 能在对话中调用工具、执行后台任务。官方列举的任务有天气查询、股价查询、餐厅推荐和行程规划。这些任务在后台执行时,前台的对话不断,任务完成后它主动反馈结果。
边听边译
MOSS-Live 支持流式同声传译,一边接收源语言语音,一边输出目标语言,说话者持续发言时翻译也保持连贯。原文文本、译文文本和译文语音以流式方式同步返回,支持 14 种语言、双向互译,适合会议、出行、跨语言客服等场景。
不只能听,还能看
MOSS-Live 支持视频通话和屏幕共享,结合画面信息理解场景并交互。它还能理解非语言的声音:识别环境里的声音,感知说话者的音色等声学特征,把视觉、语音和环境信息放在一起理解。
让 AI 走进真实生活里的对话
MOSS-Live 做的事情可以归成三层:交互上,它边听边说,按语义判断何时回应、何时等待、何时保持沉默;感知上,它能听、能看,把语音、画面和环境声音放在一起理解;任务上,它用前后台协同架构把对话和复杂任务分开,边聊边办事。
三层能力合在一起,改变的是人和 AI 说话的方式。以往是人适应机器:等它说完再开口,把话一次说完整,周围尽量保持安静。全双工实时交互让机器来适应人:可以停顿、插话、改主意,旁边有人说话时它会分辨这些话是否在对它说,查资料和办事情也不用停下交流。对做语音助手、会议协作、车载和导览这些方向的团队来说,语音交互可以从一问一答扩展到更长、更复杂的任务。
沿着这个方向,AI 可以从“问一句、答一句”走向持续在场:一直在听、在看,知道什么时候该开口、什么时候该安静,需要时主动提醒,办完事再回来汇报。会议室、车里、街头只是开始,家里、课堂、客服热线、跨语言的交流,凡是人与人靠说话沟通的地方,都可能有这样一位能自然对话的 AI 参与进来。这也正是官方给 MOSS-Live 配的那句话想说的:AI that's with you, wherever life happens.
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”