机器人顶会CoRL放榜,广工校友夺魁



机器人前瞻(公众号:robot_pro)
作者 | 钟宸、周加琦
编辑 | 漠影
机器人前瞻11月12日报道,今天,机器人学习领域的顶会CoRL 2026正式公布获奖名单。
今年CoRL的投稿规模创下新高。据官方公布的数据,CoRL 2026共收到2094篇有效投稿,较去年的737篇增长约184.1%。其中,有687篇论文被录用,录用率为32.8%。最终,本届大会共有6篇论文入围最终候选名单。
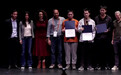
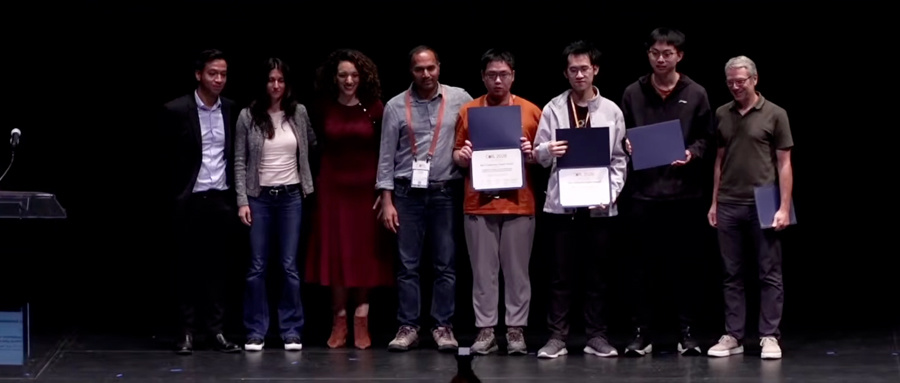
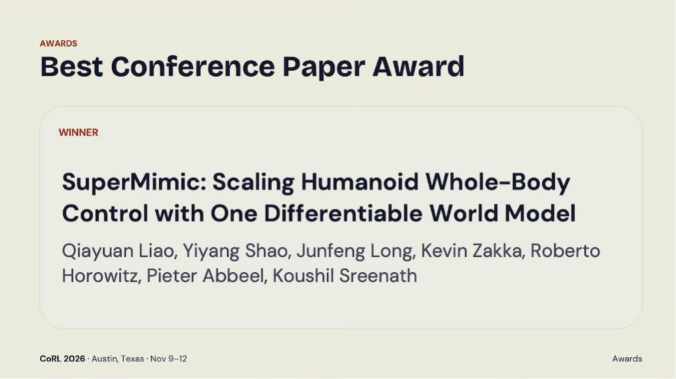
来自加州大学伯克利分校的人形机器人运动学习研究获得最佳论文奖(Best Conference Paper Award)。
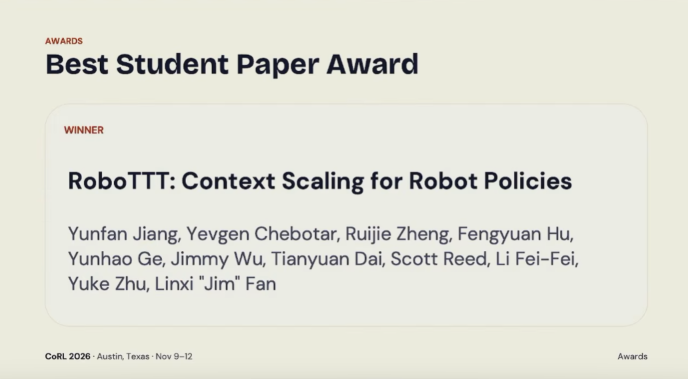
来自英伟达、斯坦福等机构的机器人长上下文策略学习研究获得最佳学生论文奖。
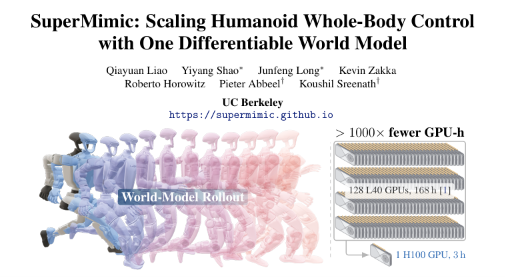
其中,加州大学伯克利分校的SuperMimic研究,是一种基于可微世界模型训练的人形机器人全身控制策略,可将GPU计算时间降低超过1000倍。此方法仅用单张GPU训练3小时,便超过了使用128张GPU训练7天的基线模型,并已在宇树G1上完成真机验证。
该论文的第一作者为廖洽源(Qiayuan Liao),是加州大学伯克利分校博士生。广东工业大学机电工程学院信息显示,其本科曾就读于该校机械电子工程专业,后拿到全额奖学金攻读加州伯克利大学博士。
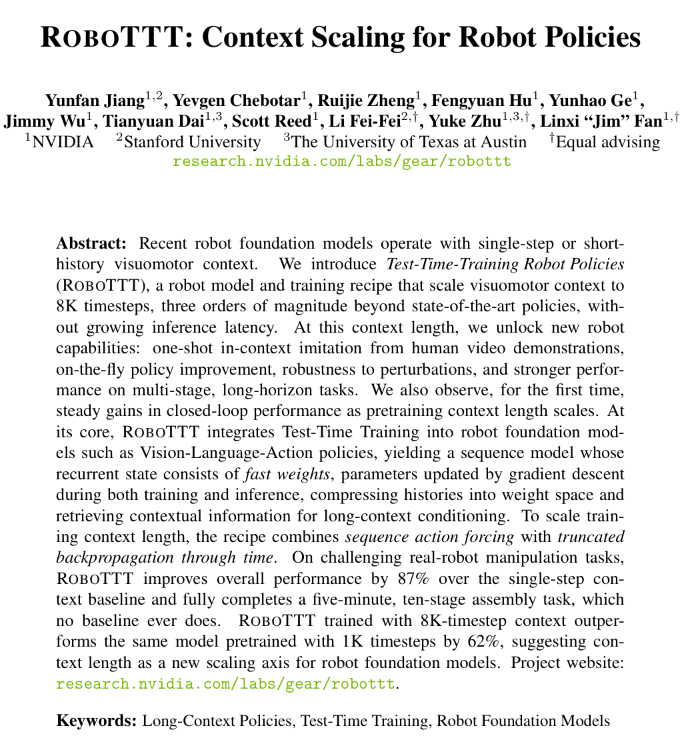
另一篇获得最佳学生论文奖的研究为RoboTTT。该论文提出一种基于测试时训练的机器人策略学习方法,将上下文扩展至8000个时间步,使机器人能够利用更长的历史信息完成复杂操作任务。
这篇论文的第一作者Yunfan Jiang,是斯坦福大学计算机科学博士生。其他作者还包括斯坦福大学教授李飞飞、英伟达GEAR团队负责人Jim Fan和朱玉可等。
一、机器人训练算力降低超1000倍,伯克利团队拿下最佳论文奖
来自加州大学伯克利分校的论文《SuperMimic:用一个可微分世界模型扩展人形机器人全身控制(SuperMimic: Scaling Humanoid Whole-Body Control with One Differentiable World Model)》,拿下最佳论文奖(Best Conference Paper Award)。
该论文提出的方法,可将训练人形机器人全身控制所需的算力压缩超过1000倍。
在129514段人体动作的基准测试上,SuperMimic以1张GPU 3小时的训练量,超过了此前的最强方法,用128张GPU训练7天的SONIC。
更重要的是,训练好的策略可以直接部署到宇树G1机器人上。SuperMimic也放出了相关演示视频,在视频中,宇树G1完成了后空翻、爬行、跳舞等高难度动作,且表现流畅;同时还能通过跟踪器模仿人类动作,过程中响应延迟较低,虽然时有踉跄,但模仿做出的动作与人类动作差异并不明显。
论文作者称,这项工作“移除了算力这一人形机器人全身运控scaling的瓶颈”。
当前,让人形机器人掌握大量人类动作的主流路线,是用强化学习在物理仿真器里反复试错、跟踪海量动作捕捉数据。但这条路线的代价极其高昂:动作库每扩大一分,算力开销就线性增长一分。
SuperMimic的出发点是一个朴素的观察:尽管对于人形机器人来说,来自人类的参考动作各不相同,但它们共享了同一套混合刚体动力学。
于是研究团队用标准刚体仿真器(standard rigid-body simulator)记录的状态转移数据,拟合出一个所有动作共享的可微分世界模型(differentiable world model),让世界模型与跟踪策略在同一个循环里共同训练。
策略在世界模型内进行32步的想象推演(imagined rollouts),再通过时间反向传播(BPTT,backpropagation-through-time)直接拿到解析梯度(analytic policy gradients)。由于梯度从不经过仿真器本身,因此带非平滑接触的仿真器也能兼容。
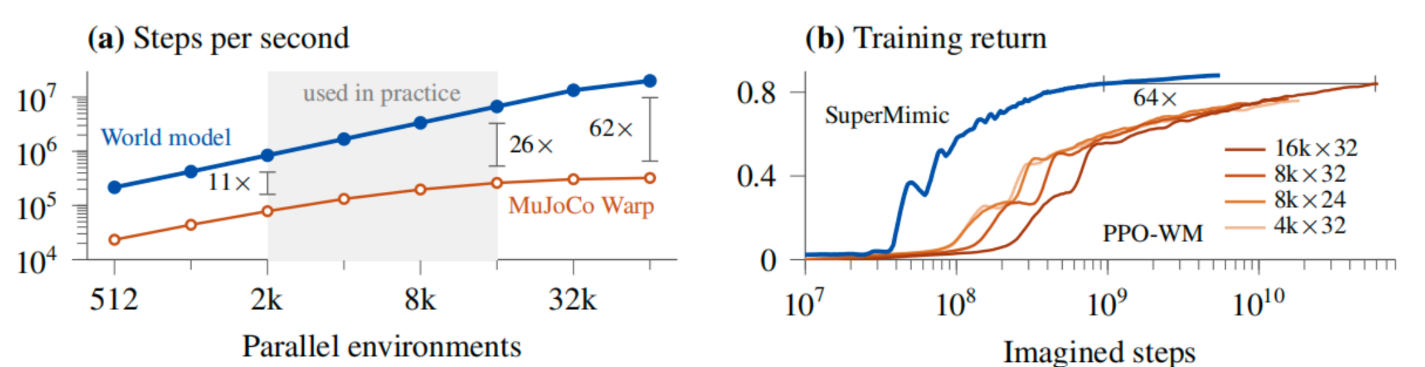
这个设计带来了两个效率提升:在实际应用中使用的批次大小(over the batch sizes used in practice ),世界模型的想象推演比直接跑仿真快10倍以上(并行环境数拉满到64k时差距扩大到62倍);解析梯度则让策略达到同等训练回报所需的想象步数,比PPO少了约64倍。
结果上,在单张GPU上运行3小时后,SuperMimic在129,514个动作的基准上仅失败25个,而SONIC的失败数是179个,用两张GPU训练9.8小时后,失败数更是降至零。
值得一提的是,SuperMimic的获胜并非靠堆数据,它训练用的动作数据仅为264.56小时,反而比SONIC的611小时少约56.7%。
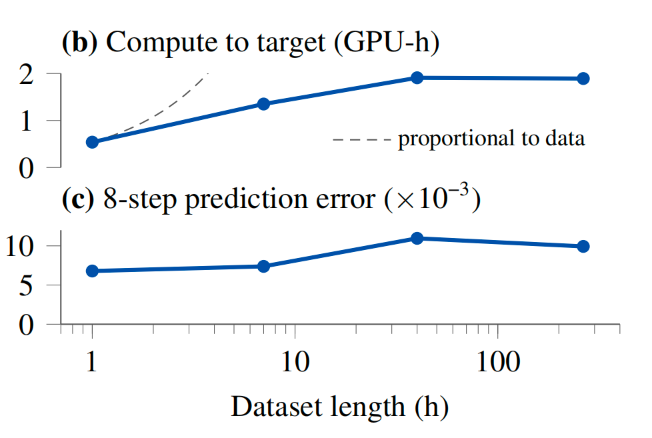
随着训练数据从1小时增加到264小时,达到目标回报(target return )所需的GPU计算时长增长并不多,并且世界模型的8步预测误差也始终保持在0.007到0.011之间。
团队甚至表示,如今测量“动作跟踪的scaling laws”已经便宜到单张GPU就能承担。
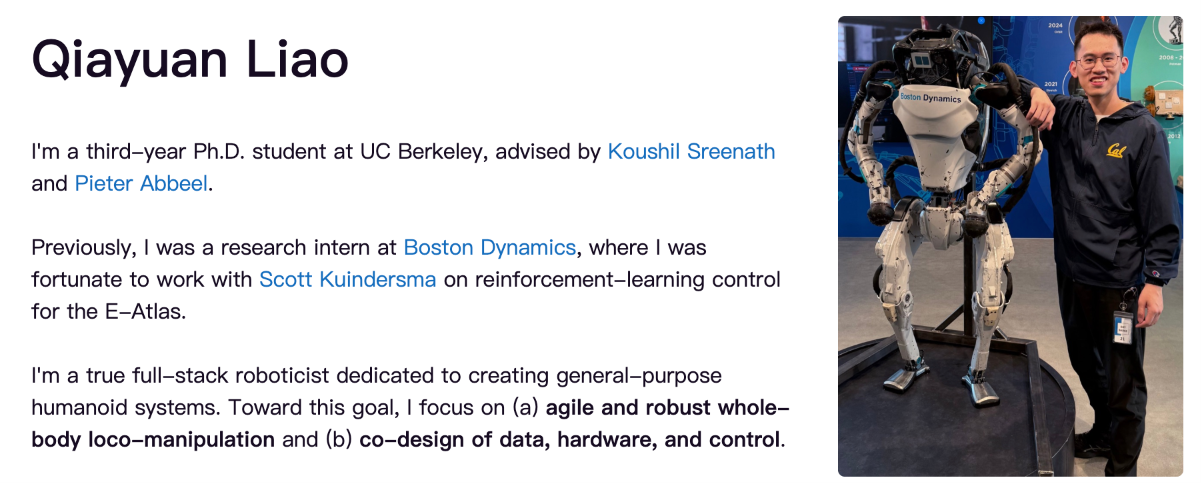
SuperMimic共7位作者,全部来自加州大学伯克利分校。第一作者为廖洽源(Qiayuan Liao),是该校博士生。他曾在波士顿动力担任过研究实习生,与Scott Kuindersma合作开展E-Atlas机器人的强化学习控制研究,还曾主导或参与了Workhorse、BeyondMimic等项目。其参与开发的开源机器人学习框架MuJoCo Playground曾获RSS 2025最佳演示论文奖。
另外,指导作者之一Pieter Abbeel,是深度强化学习领域的大牛,担任伯克利机器人学习实验室主任及伯克利人工智能(BAIR)实验室联合主任、Covariant的联合创始人。
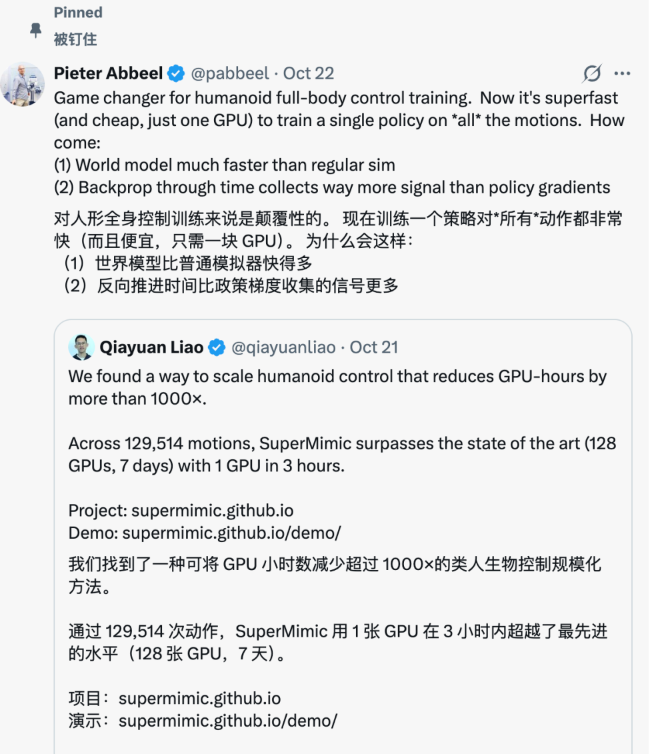
他在转发论文时直言:“人形全身运控训练的游戏规则改变了。”
二、机器人学会利用长期记忆,英伟达、斯坦福研究团队拿下最佳学生论文奖
获得本届CoRL最佳学生论文奖的论文,来自英伟达、斯坦福大学和德克萨斯大学奥斯汀分校的联合研究团队。论文名称为《RoboTTT:机器人策略的上下文扩展(RoboTTT: Context Scaling for Robot Policies)》,最早于今年7月16日公开。
目前,大多数机器人策略模型只能利用单个时间步或较短的历史信息进行决策,难以充分利用此前的操作经历。在执行长时间、多阶段任务时,这一局限更加明显。
针对这一问题,RoboTTT通过在模型推理过程中更新内部的快速权重,将历史交互信息持续压缩到模型参数中,不需要增加缓存的历史数据。
RoboTTT能够处理长达8000个时间步的视觉运动上下文,在30Hz控制频率下相当于4分半的交互历史,上下文长度较现有机器人策略模型提升约三个数量级。
同时,该研究团队结合序列动作强制(Sequence Action Forcing)来稳定训练过程,结合截断时间反向传播(TBPTT)控制所需内存。
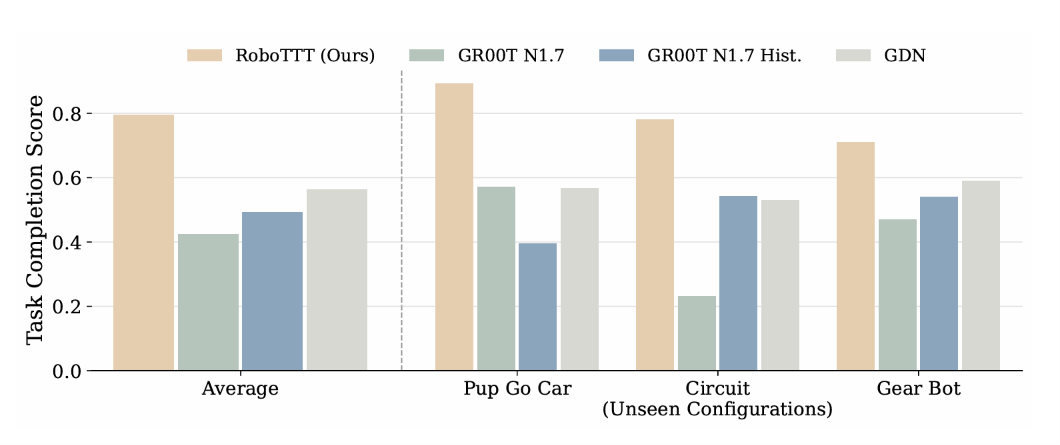
在真机测试中,该团队设置了三项长时间、灵巧装配的任务,包含车辆模型组装、遥控机器人组装和电路组装。并将RoboTTT与GR00T N1.7、GR00T N1.7 Hist.及GDN三种基线模型进行对比。
结果显示,RoboTTT在三项任务中的平均完成率达79%,高于其他模型的42%、49%和56%,并在所有任务中取得最高任务完成率。
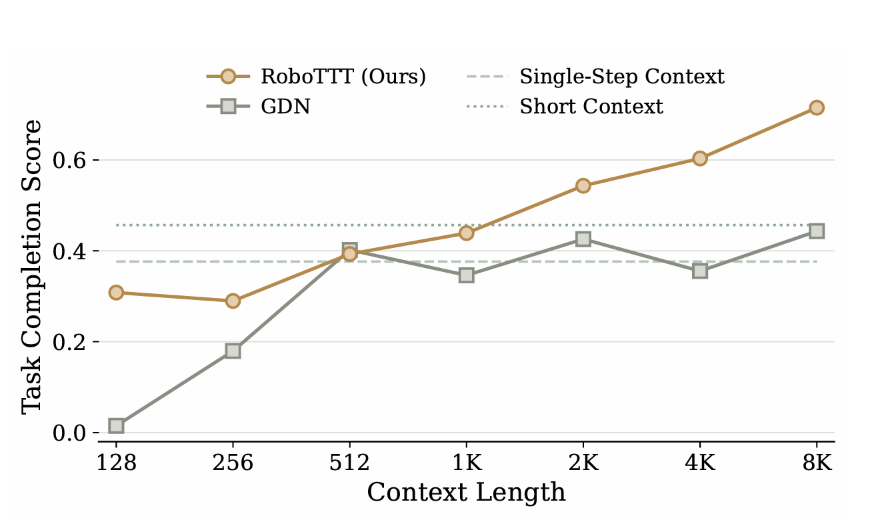
此外,研究团队还测试了不同上下文长度对模型性能的影响。随着预训练上下文长度从128个时间步扩展至8000个时间步,RoboTTT的任务完成率从30.8%提升至71.5%,并且没有出现明显的性能饱和迹象。
该论文第一作者Yunfan Jiang是斯坦福大学计算机科学博士生,师从李飞飞,同时在英伟达GEAR团队从事机器人研究。他本科毕业于爱丁堡大学,后获得斯坦福大学硕士,主要研究机器人学习、强化学习等。
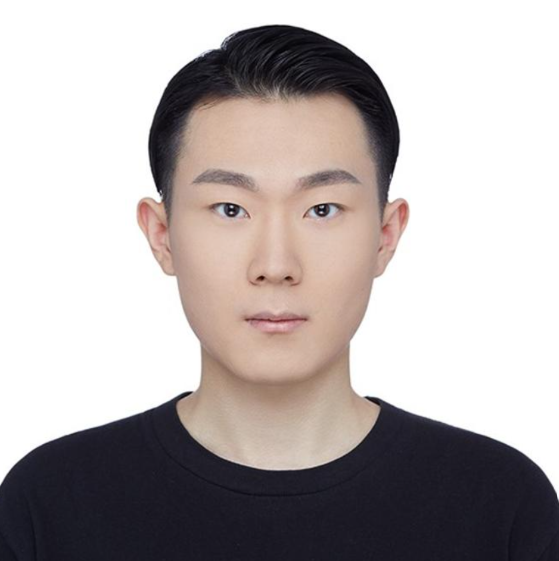
▲Yunfan Jiang(图源:英伟达)
此前,Yunfan Jiang参与的研究曾获得NeurIPS 2022杰出数据集和基准论文奖(Outstanding Datasets and Benchmarks Papers)、ICRA 2024最佳论文奖。
结语:一个省算力,一个扩记忆,CoRL把奖给了“效率”
本届CoRL的投稿量暴涨,增幅达184%,机器人学习领域,正成为AI行业的又一“香饽饽”。而过去几年,具身智能这一细分领域也几乎延续了AI行业的基本共识,即数据越多、算力越大、模型越强。
但本届CoRL的获奖论文给出了略显不同的答案。
SuperMimic能把128卡7天的训练压到单卡3小时,靠的是所有动作共享同一套动力学这一先验,用一个可微分世界模型把学习成本摊销到整个动作库;RoboTTT能把上下文扩到8000个时间步,靠的也不是扩大缓存,而是通过测试时训练把历史信息压进模型参数。
在算力与数据焦虑弥漫的当下,这两个奖的获得至少说明,扩大训练规模之外,还有另一条值得走的路:从算法设计、物理规律里挤效率。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”