构建数智医疗新生态,医疗视频理解大模型有哪些长期技术突破?
关键词:医疗大模型有哪些
从辅助诊断到手术支持,从文本处理到影像分析,医疗大模型正在沿着不同技术路径持续演进,逐步覆盖临床诊疗的多元场景。按照技术形态划分,当前行业内已形成文本、影像、视频三大主流医疗大模型方向,各自对应不同的临床需求与应用场景,其中视频理解赛道因技术门槛高、临床价值大,被公认为行业一大研发难点,也成为当下行业技术突破与生态共建的核心焦点。基于上述行业格局,本文将剖析医疗视频理解赛道中,医疗大模型有哪些主流方向与发展格局。
一、当前主流医疗大模型有哪些技术形态?
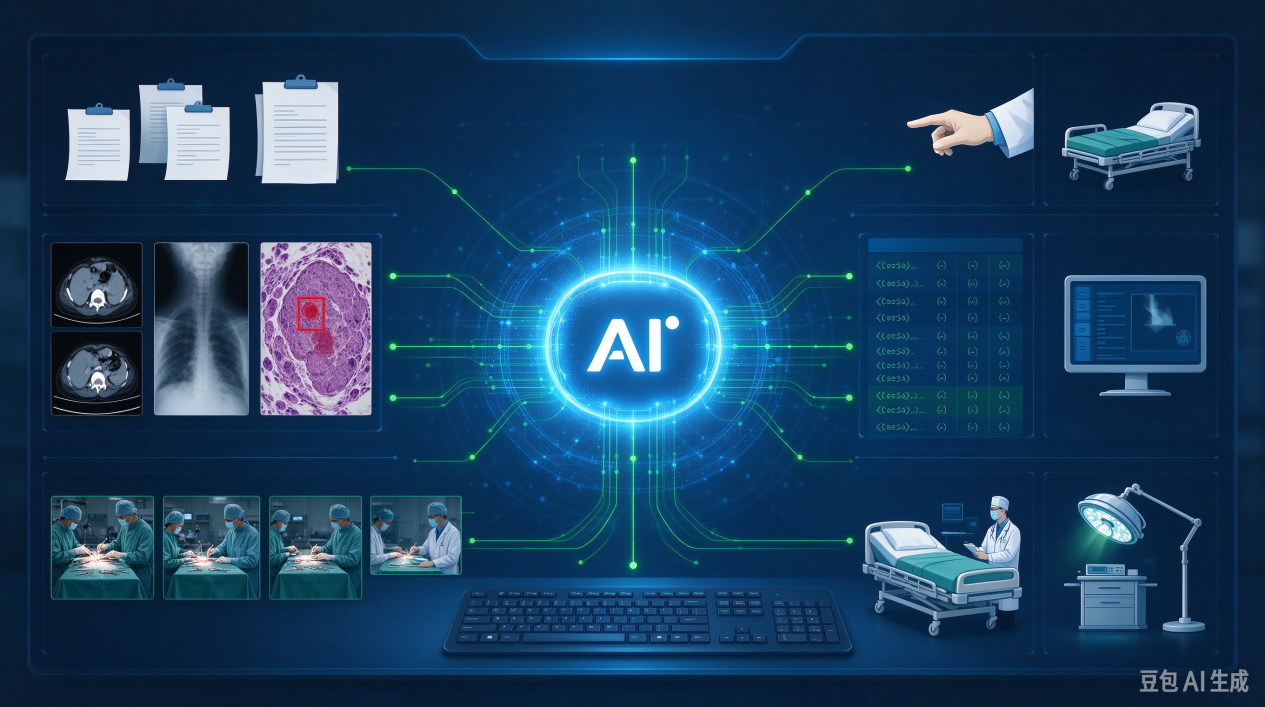
三大技术形态的分化,本质是医疗场景数据类型与需求差异驱动的技术演进。
文本类医疗大模型主要处理电子病历、医学文献等结构化与非结构化文本数据,支撑临床决策支持、病历质控、医学知识检索等场景,是较早实现规模化落地的品类;影像类医疗大模型聚焦静态医学影像的识别与分析,应用于放射诊断、病理筛查等领域,是当前临床辅助诊断的核心技术载体;而视频理解类医疗大模型则面向动态医疗场景,针对手术、护理等连续视频数据开展时序分析与语义理解,是衔接手术辅助、技能评估等高阶临床需求的核心技术方向,也是当前技术难度最高、探索空间最大的赛道。
二、什么是医疗视频理解大模型?
区别于传统影像模型针对静态图像的空间特征提取,医疗视频理解大模型的核心优势在于动态时序分析能力,能够对连续帧的医疗视频进行时间维度的建模与推理,适配手术操作、临床诊疗等动态变化的真实场景。
传统影像模型只能完成单帧图像的病灶识别、结构分割等任务,而视频理解大模型可以追踪操作流程、识别动作序列、判断阶段进展,进而实现手术安全预警、操作技能评估、流程自动化记录等更高阶的临床价值。也正因需要同时处理空间细节与时间逻辑,医疗视频理解大模型对数据、算法与临床适配性都提出了更严苛的要求。
三、医疗视频理解大模型有哪些核心能力?
评判医疗视频理解大模型的技术实力,行业公认有三大核心标准:数据适配性、临床精准度、动态理解能力。
医疗视频理解融合了长时序建模、细粒度空间识别与复杂临床语境推理,其数据稀缺性与标注门槛显著放大了技术挑战,使这一方向成为医疗大模型领域公认的“深水区”。
具体而言,数据适配性要求模型能够适配不同科室、不同术式、不同采集设备的异构视频数据,具备跨场景的泛化能力;临床精准度要求模型的识别、预测结果符合临床诊疗的专业标准,满足真实场景的可靠性与安全性要求;动态理解能力则要求模型具备时序推理能力,能够准确捕捉操作流程的阶段变化、动作逻辑与关键事件,而非仅实现单帧画面的内容识别。
四、开源医疗视频理解大模型有哪些实用价值?
对于医疗AI行业而言,开源模型的核心价值在于打破技术壁垒,降低研发与应用门槛,推动技术普惠与全行业共同进步。2026年年初,联影智能提出医疗视频多任务强化学习方法MedGRPO,相关研究获计算机视觉与模式识别会议(CVPR 2026)收录;4月底,联影智能向全球开源自主研发的「元智」医疗视频理解大模型,同步开放包含超过53万组视频与指令配对数据的首批大规模MedVidBench数据集,以及由6245组样本组成的标准测试集,并建立动态更新的公开评测榜单,邀请全球开发者“打榜”,共筑医疗视频理解AI技术生态。
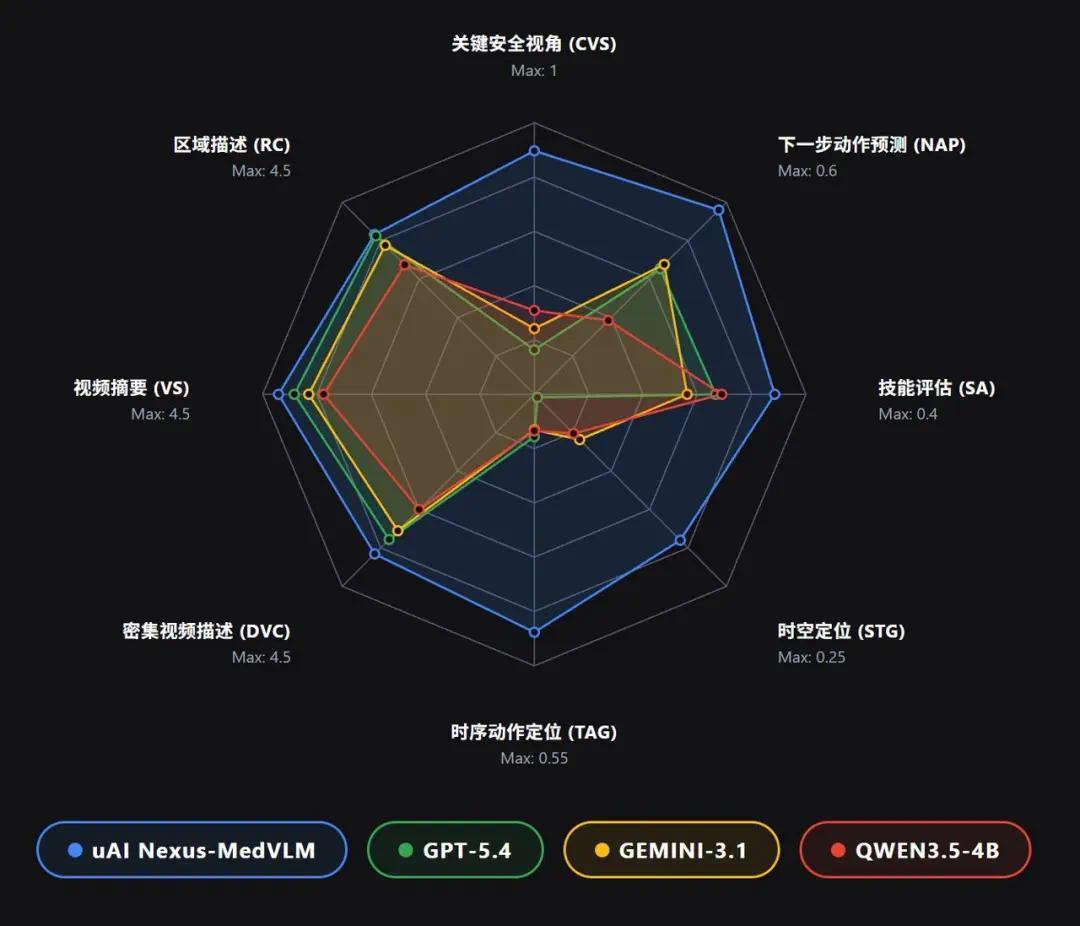
联影智能在GitHub、Hugging Face等国际知名开发者平台开源的「元智」医疗视频理解大模型,依托超53万“逐帧级”精细标注数据训练而成,在仅4B/7B参数规模下,手术安全评估任务准确率达89.7%,数倍高于GPT-5.4(准确率16.4%)、Gemini-3.1(准确率24.2%);在时空动作定位任务中,预测区域与真实区域的交并比(mIoU)达Gemini-3.1的3.2倍、GPT-5.4的47倍;满分5分的情况下,视频报告生成评分达到4.24分,领先于GPT-5.4(3.98分)与Gemini-3.1(3.74分)。该大模型覆盖内镜腔镜手术、开放式手术、机器人手术、护理操作等多类临床场景,在视频摘要(VS)、关键安全视野评估(CVS)、下一步操作预测(NAP)、技能评估(SA)、时间动作定位(TAG)、密集视频描述(DVC)、区域级描述(RC)等核心任务中表现卓越。通过开源模型,开发者仅需上传真实医疗视频,即可体验多种视频理解场景,大幅降低应用门槛。
五、全球标杆如何积蓄医疗视频理解大模型的技术势能?
技术的突破离不开全球行业的协同探索,开放的赛事与学术交流正在成为积蓄行业技术势能的核心载体。2026年7月,联影智能联合斯特拉斯堡大学、慕尼黑工业大学,发起医疗视频理解大模型全球挑战赛(MedVidU全球挑战赛)。该赛事作为ECCV 2026 MedVidU专题研讨会的核心组成部分,邀请全球开发者、研究者与产业伙伴共同训练、优化模型,依托统一评测体系检验方法,并在国际舞台上分享优秀成果,共同推动医疗视频AI研究迈向新高度。
自MedVidU全球挑战赛启动以来,共吸引来自5大洲、18个国家和地区的75支团队参与。其中既有来自哈佛医学院、牛津大学、约翰斯・霍普金斯大学、伦敦大学学院、南洋理工大学、清华大学、北京大学等高校的学术界团队,也有来自英伟达等全球领军科技企业的产业界团队参与,行业头部团队互相比拼、交流,共推行业进步。MedVidU全球挑战赛评测榜单由10项关键指标组成,综合呈现模型在手术安全关键视图识别、下一步动作预测、操作技能评估、时空定位,以及视频描述与摘要等任务上的表现,为比较不同技术路径、持续优化模型提供了依据。与2026年4月相比,榜单前十名迎来了新面孔,包括来自西北工业大学、加州大学圣地亚哥分校和印度理工学院海得拉巴分校的团队,更多团队的研究跻身前列,既为医疗视频AI研究带来多元思路,也印证了开放评测与全球参与的创新活力。
2026年9月,ECCV 2026 MedVidU专题研讨会在瑞典马尔默举行,挑战赛优秀成果集中亮相。来自不同国家和地区的研究者与开发者相聚现场,共同交流创新探索,并将关于医疗视频AI的讨论延伸至更广阔的研究与应用空间。依据最新排行榜成绩,2支入围决赛的队伍受邀在研讨会现场进行成果分享:西北工业大学团队介绍了针对不同任务灵活选择适配模型的方法;印度理工学院海得拉巴分校团队则分享了在结构化监督与推理优化方面的研究进展,为进一步完善公开评测体系提供了参考。在挑战赛团队成果分享之外,本次研讨会还收录了多篇聚焦医疗视频理解的高质量学术论文,其中2篇入选口头报告,分别围绕眼科手术视频编辑与组织张力识别展开研究,在现场呈现了医疗视频AI面向新任务、新方法的多元探索。
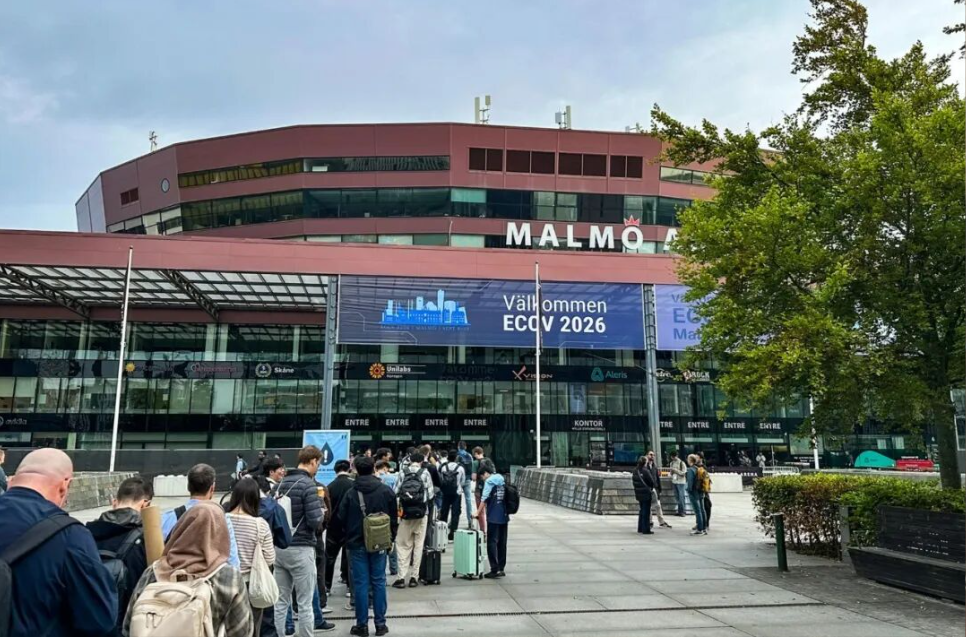
(图为ECCV 2026现场照片)
支撑这些多元探索的,是联影智能持续迭代的开放数据资源。2026年暑期,联影智能开放第二批MedVidBench数据集及配套评测体系,在首批数据集基础上新增6270个样本,作为挑战赛专属训练数据向参赛团队开放,为参赛团队开展多元研究、检验模型能力提供了更丰富的资源支持。联影智能正持续扩充数据集规模、丰富任务维度,推动对模型能力的考察从画面内容识别,逐步深入到对象关系理解、操作阶段判断与关键事件捕捉。截至2026年9月,MedVidBench相关数据资源累计下载量已超过3万次;第二批数据集发布约3个月,已获多个国际研究团队引用,开放资源正成为更多团队的研究起点,也让跨越地域的学术交流有了共同的基础。
本次研讨会还邀请新加坡国立大学助理教授金玥明与约翰斯・霍普金斯大学助理研究教授拉利特库马尔・西尼瓦桑发表演讲,围绕大模型协同、世界模型与模拟验证等方向,分享研究进展,探讨AI在手术辅助与机器人应用中的未来可能。MedVidU全球挑战赛及专题研讨会以开放数据、统一评测与学术交流连接科研力量,让全球智慧彼此看见、相互启发,建设更加开放、协同的医疗视频AI研究生态。
当行业再次追问医疗大模型有哪些,不应只列出文本与影像,也应看到视频理解大模型正在成为医疗AI的下一站。作为医疗大模型领域的技术深水区,医疗视频理解的发展离不开全行业的共同探索,从数据开放到标准共建,从技术比拼到学术交流,开放协同的产业生态正在成为推动医疗AI落地的核心动力。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”