会干活不等于懂协作,Einsia AI发布行业首个多智能体编排基准WorkflowArena
随着大模型能力的提升,企业需求不再满足于简单任务,越深入企业工作流,对复杂任务的需求越多,智能体从单打独斗走向多智能体协同,多智能体编排由此成为 AI 时代的“组织操作系统”。
但现有评测大多关注最终任务是否完成,或在预设的协作结构中测试模型,都未能回答一个关键问题:面对真实的长程任务,大模型能否自主组织好一个多智能体系统?
近日,Einsia AI 旗下 Navers Lab 发布行业首个多智能体编排基准 WorkflowArena,专门评测大模型的多智能体编排能力。基准包含145项长程任务,覆盖软件工程、企业运营、科学研究、数学推导、金融、法律、内容设计与3D制作八大专业领域,对9个主流前沿模型的25种推理配置进行了评测。
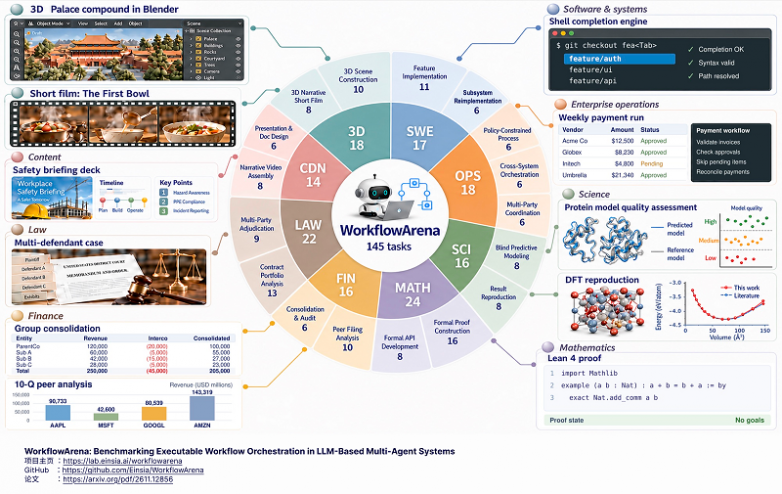
WorkflowArena 的 145 项任务分布在 8 大领域、17 种任务形态
145项真实任务,模型自主决定如何协作
WorkflowArena 的核心设计,是不预设智能体之间的协作方式,让模型自主按任务决定如何组织团队。
145项任务均对应真实的专业交付,包括修改开源代码库、复现科学实验、完成 Lean 形式化证明、编制多主体合并报表、分析一起多被告案件,以及在 Blender 中搭建完整建筑群等。这些任务可以拆分,却又彼此耦合。
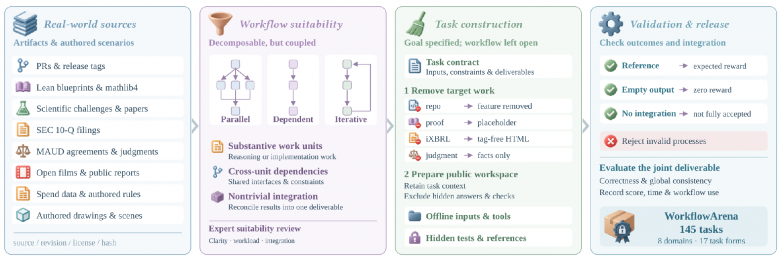
WorkflowArena 构建流程:真实素材 → 筛选「可拆分但相互耦合」的工作 → 只规定目标、不规定工作流 → 校验结果与整合。
在评测中,模型可以自主决定是否调用 Workflow 工具、创建多少子智能体、如何分配任务和上下文,也可以随时查看、修改或终止工作流。主智能体与所有子智能体共享推理预算,规划、调度和返工都计入成本。
与此同时,判题器和标准答案对模型隐藏,评分只看最终交付物是否满足全部验收标准,与调用了多少子智能体无关。每一次调度行为则被完整记录。
如此,WorkflowArena 不仅能评估模型「做得怎么样」,还能分析它「是怎么组织起来做的」。
评测结果:最强配置完全解决率仅36.95%
评测采用严格的完全解决率:只有交付物通过全部验收标准,才算真正完成任务,部分完成或整合失败均不计为成功。
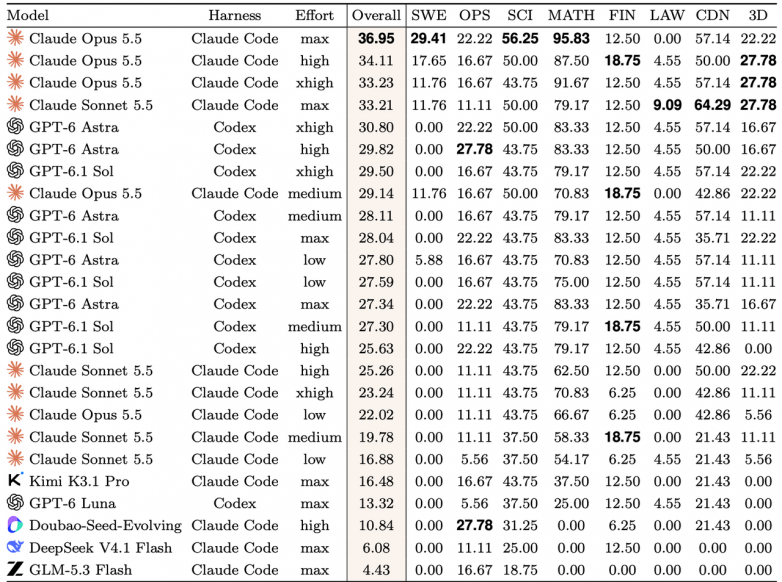
结果显示,Claude Opus 5.5(max)以36.95%的完全解决率排名第一。这意味着,即使是榜首配置,也未能完整解决六成以上的任务。
不同领域的表现差距更加明显:Claude Opus 5.5 在形式化数学领域达到95.83%,但软件工程最高完全解决率仅29.41%,金融最高18.75%,法律最高仅9.09%。
同时,没有任何一个系统能够通吃所有领域。Claude Opus 5.5 领跑软件工程、科学研究和数学,Claude Sonnet 5.5 在法律与内容设计领域领先,GPT-6 Astra 与 Doubao-Seed-Evolving 则在企业运营领域并列第一。
这表明,多智能体系统的能力不仅取决于模型本身,还受到任务类型与协作方式的显著影响。
Claude偏向"谋定后动",GPT更倾向"小步快跑"
由于完整记录了工作流,WorkflowArena 揭示了不同模型的编排风格。
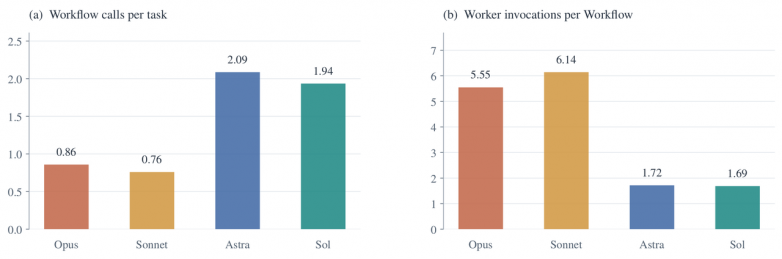
Claude 系模型更倾向于「谋定后动」,调用workflow 频次较少,但是一旦调用,调用的智能体数量较多。而GPT 系则更倾向于「小步快跑」,调用workflow 频次较多,但是平均调用智能体的数量偏少,约99%的工作流不超过4个子智能体。
这种差异在具体任务中更加突出。例如,在法律任务中,Claude Opus 5.5 每个工作流平均调度14.29个子智能体,而 GPT-6 Astra 仅为1.73个。表明调用频率高不等于协作规模大,不同任务也需要不同的编排策略。
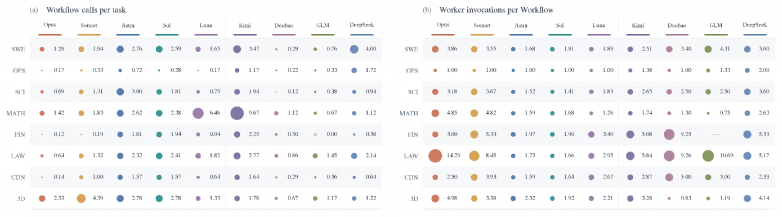
9 个模型在 8 大领域的委派频率(左)与委派规模(右)
圆圈越大数值越高
会干活不等于懂协作
为了验证多智能体系统的表现究竟有多少来自编排能力,研究团队进一步设计了工作流迁移实验:固定执行模型,只更换负责设计工作流的模型。
实验中,Claude Opus 5.5 和 GPT-6 Astra 担任编排者,其他模型负责实际执行。编排者不能直接修改文件,只能设计工作流、分配任务和提供指令。实验还设置了静态与动态两种模式,分别对应编排完成后退出,以及根据执行反馈持续调整。
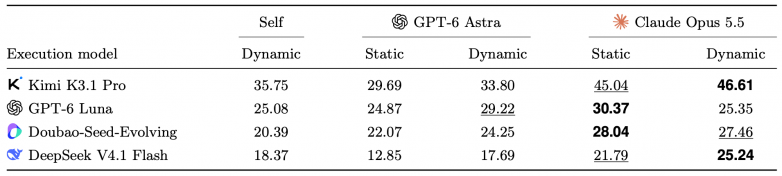
核心子集上的工作流迁移结果。Self 为执行模型自己编排;加粗与下划线分别为每行最高与次高分。
注:这里比较的是连续得分(部分完成也计分)。子集难度明显更高,Kimi K3.1 Pro 在全部任务上平均 62.73 分,在这里只有 35.75 分。
结果显示,Claude Opus 5.5 设计的工作流能够显著提升不同执行模型的表现,四个执行模型平均提升6.41分(静态)和6.27分(动态)。
值得注意的是,GPT-6 Astra 虽然自身系统表现更强,但将其工作流迁移给其他模型后,静态模式平均分反而下降2.53分,动态模式平均仅提升1.34分。
这说明,模型自身的任务执行能力,并不必然转化为优秀的多智能体编排能力。如何拆解任务、分配上下文和组织协作,本身就是一项值得独立评测与优化的能力。
此外,WorkflowArena 还对比了不同配置的完全解决率与单题平均推理成本。结果显示,不同系统的编排成本相差数十倍,最省的配置每题不到1美元,最贵的则达到数十美元。但更高的推理成本并不必然带来更好的结果。部分配置消耗了更多推理预算,最终解决率却没有相应提升。
多智能体编排能力仍有待提升
WorkflowArena 的评测表明,当前大模型在多智能体编排方面仍有很大提升空间,而优秀的工作流设计,甚至能够让相同的执行模型交出明显更好的成果。
研究团队也指出,未来值得探索的方向之一,是由强模型负责规划与编排、不同能力的模型负责具体执行的异构多智能体系统。
当 AI 的能力边界从单体执行延伸至系统协作,真正决定复杂任务交付上限的,或许不再只是拥有多强的模型,而是能否将不同智能体组织成一个高效协同的整体。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”