Jim Fan直呼太棒了!英伟达GR00T 2来了,用40万小时人类视频训练



机器人前瞻(公众号:robot_pro)
作者 | 钟宸
编辑 | 漠影
机器人前瞻11月10日报道,昨日,英伟达在机器人学习领域的国际顶级会议CoRL 2026 上推出开源世界—动作模型GR00T 2系列,包含 GR00T 2和GR00T 2 Turbo两个版本。
GR00T 2主打泛化能力与精细操作,可用于平行夹爪、灵巧手和人形机器人;GR00T 2 Turbo则通过更小的参数提升运行速度,能够直接部署在宇树G1上,每次推理仅耗时124毫秒,可以控制机器人行走、弯腰、伸手和搬运。
在英伟达展示的视频里,搭载GR00T 2的灵巧机器人,可以通过仅由佩戴手套、头戴式相机和腕部相机的人员做化学实验的演示,学会实验操作,总体来看动作较为流畅。
接入推理模型(System 2)后,GR00T 2则可让YAM机械臂连续组装三种玩具,每种玩具的100次试验均至少成功97次。
不过,从视频来看,虽然机械臂完成了任务,但操作过程以16倍速播放,整段视频的时长仍超过30分钟,实际执行效率仍有提升空间。
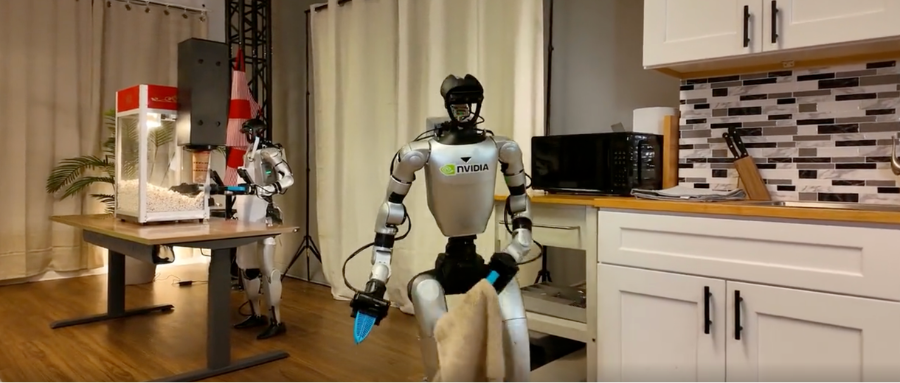
搭载GR00T 2 Turbo的宇树G1完成了用毛巾清理地面的操作,随后将毛巾放入洗衣篮。机器人并没有直接拿毛巾擦污渍,而是用脚踩住毛巾进行擦拭,整个流程也较为流畅。
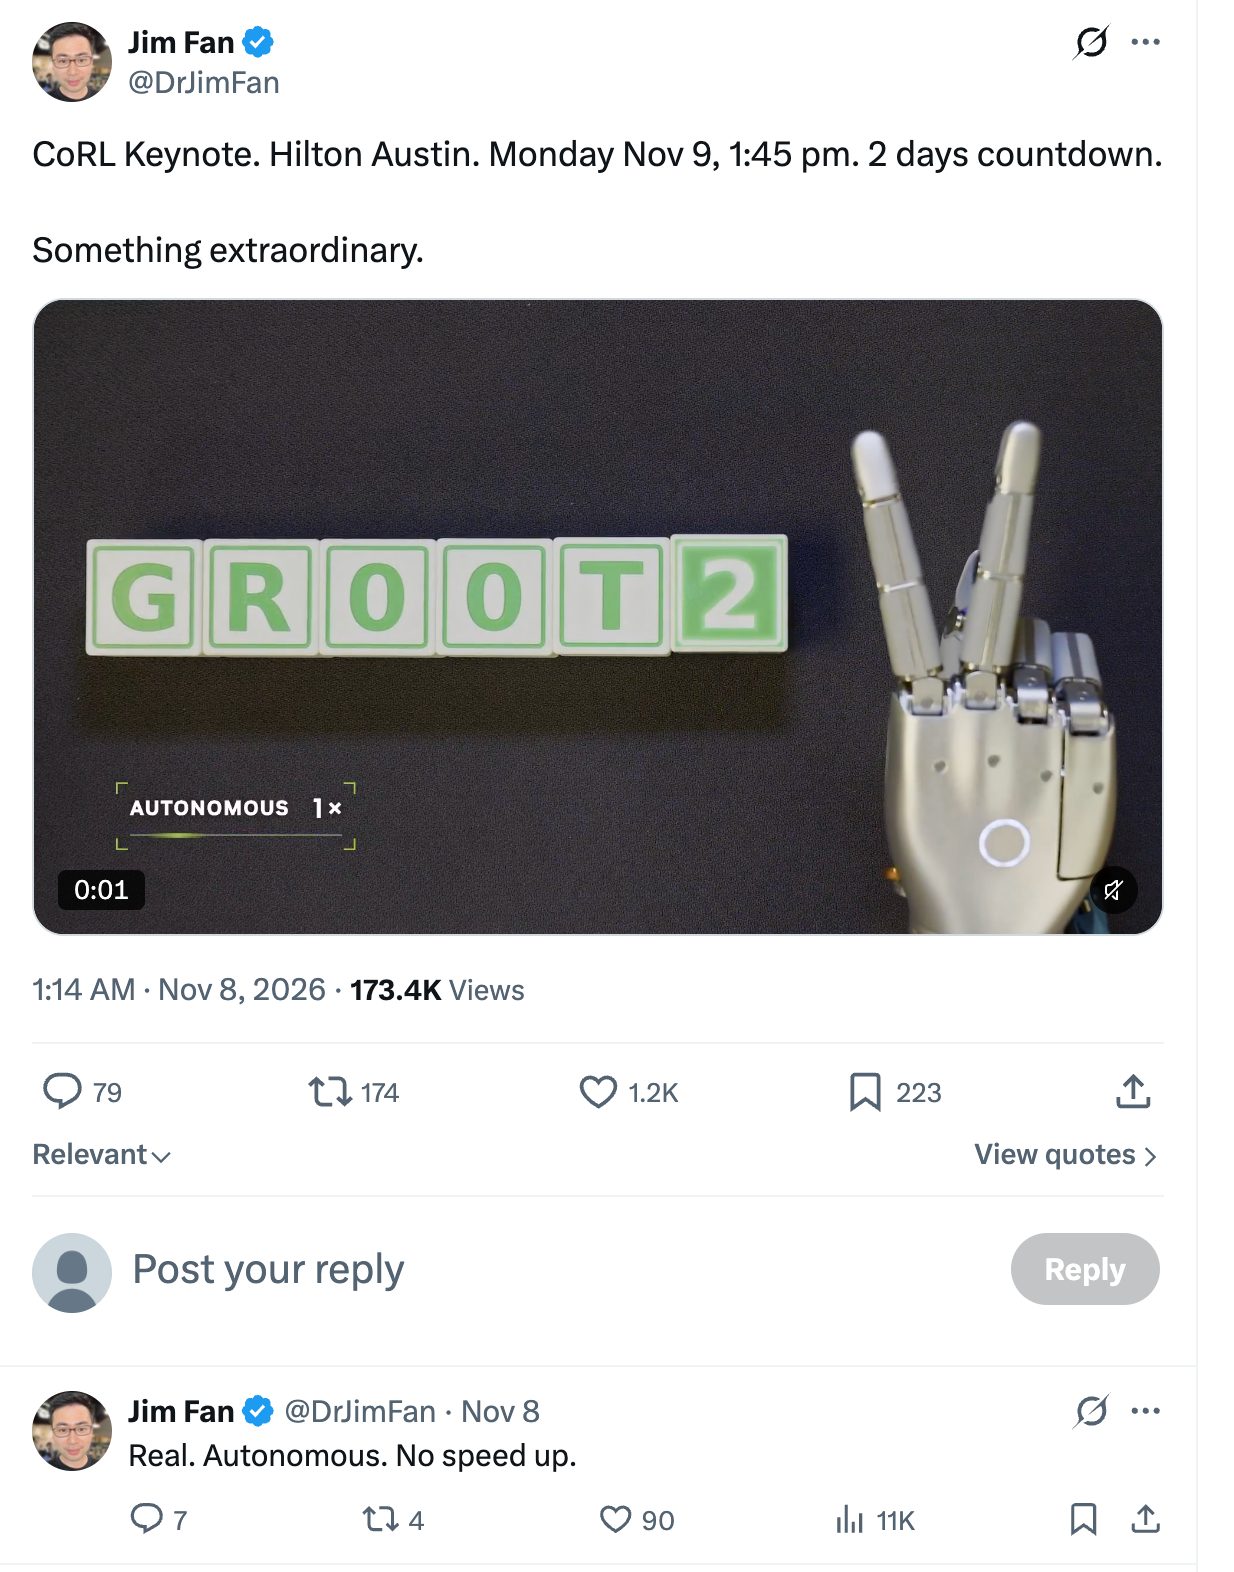
而Jim Fan在X(原推特)上发帖称,GR00T 2是杰作,特意强调视频为真实、自主操作,没有加速(Real. Autonomous. No speed up.)。
在宣告这项成果发布的帖子底下,有网友认为,人形机器人的技术发展令人印象深刻。
还有网友表示,“灵巧致胜”。
但也有人期待英伟达透露更多关键信息,例如用于提高模型任务成功率演示的数据,是来自同一机器人还是人类数据。
还有人认为,其开源的做法有利于小型机器人团队节约成本。
Jim Fan在CoRL2026介绍这一模型时,也用了一句颇为自信的话做了结尾:“你们眼前的,就是希望的火焰。”他认为,从现在起,任何人都可以成为机器人开发者,一切会动的东西,都将拥有自主能力,“在那簇火焰里,夏天要来了”。
据英伟达的技术博客,GR00T 2主要有四项能力,可以实现跨本体迁移(X-Adaptability)、少样本适应(Fast Adaptation)、智能体控制(Agentic Control)和视觉引导(Visual Steering)。
一、实现三种方式跨本体迁移,能少样本适应新任务
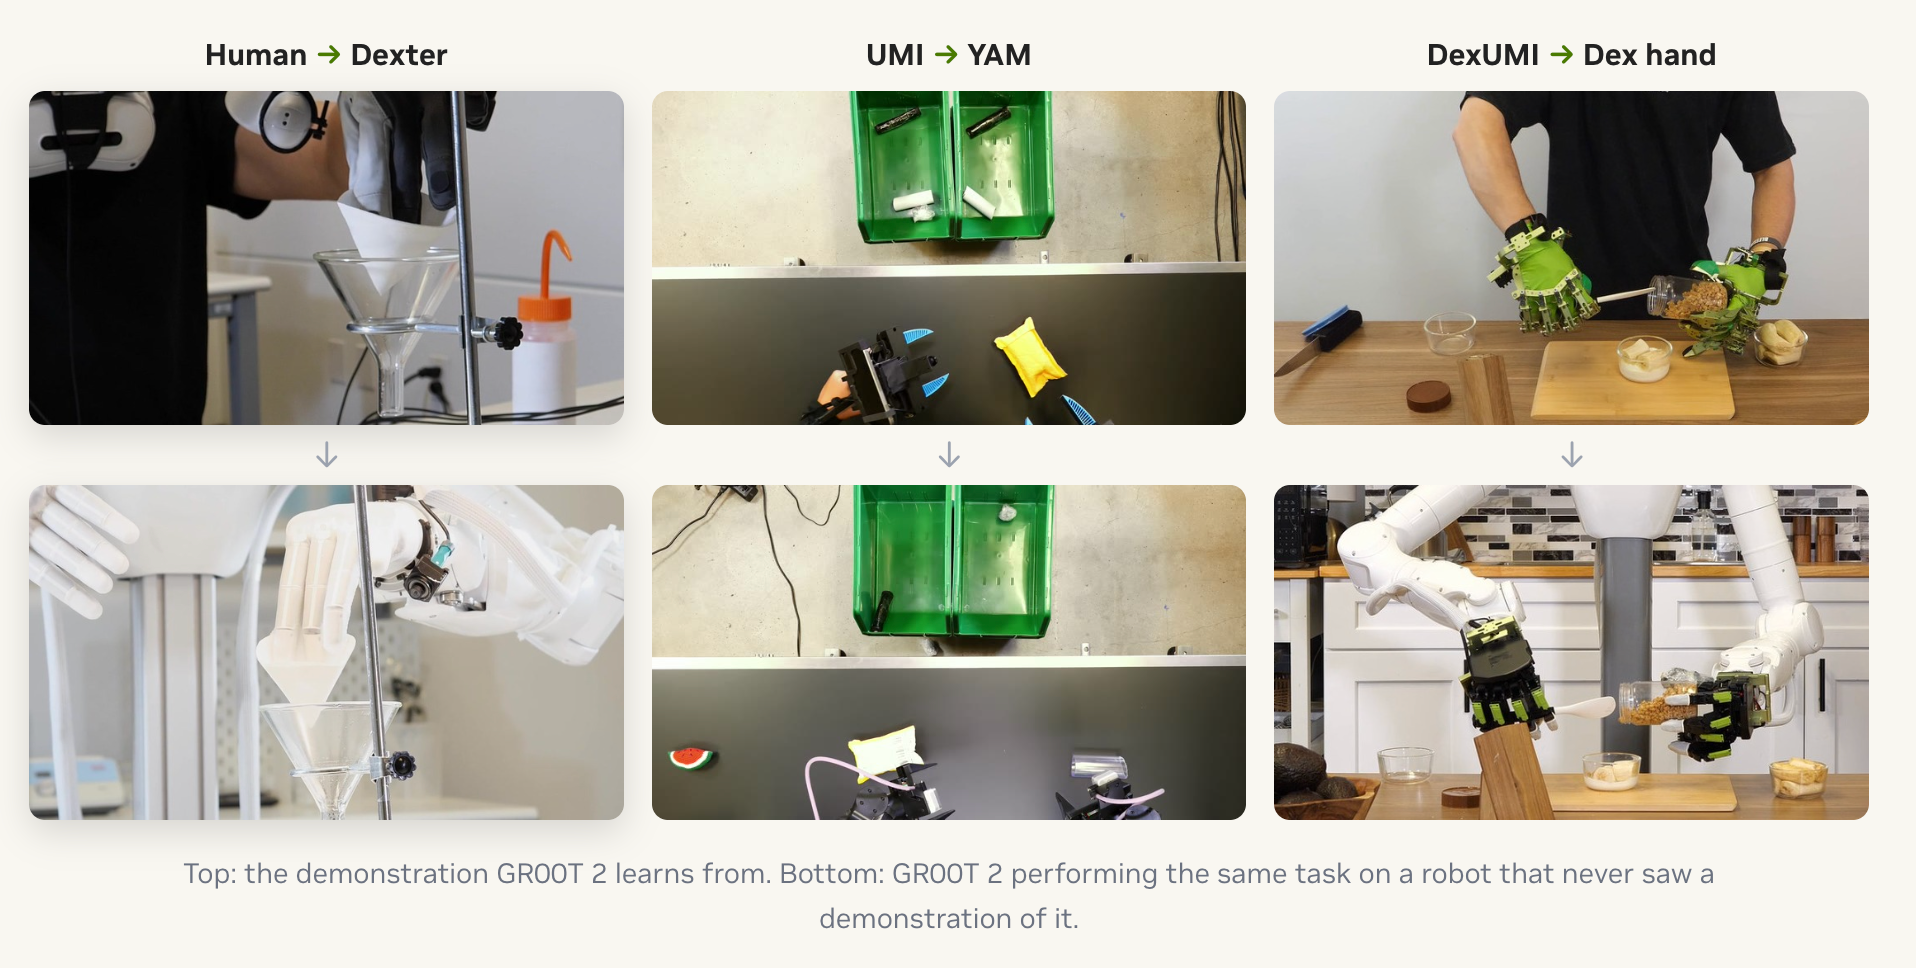
GR00T 2首先展示的是跨本体迁移能力(X-Adaptability)。机器人自身无需演示过这项任务,GR00T 2就能利用人类视频和其他机器人的数据学会这项技能。
具体来看,它支持三种迁移方式。
第一种是“人类到机器人”。在化学实验任务中,人类佩戴手套、头戴式相机和腕部相机进行示范,灵巧手则通过与具体任务无关的自由探索数据,学习自身身体的外观与运动方式。
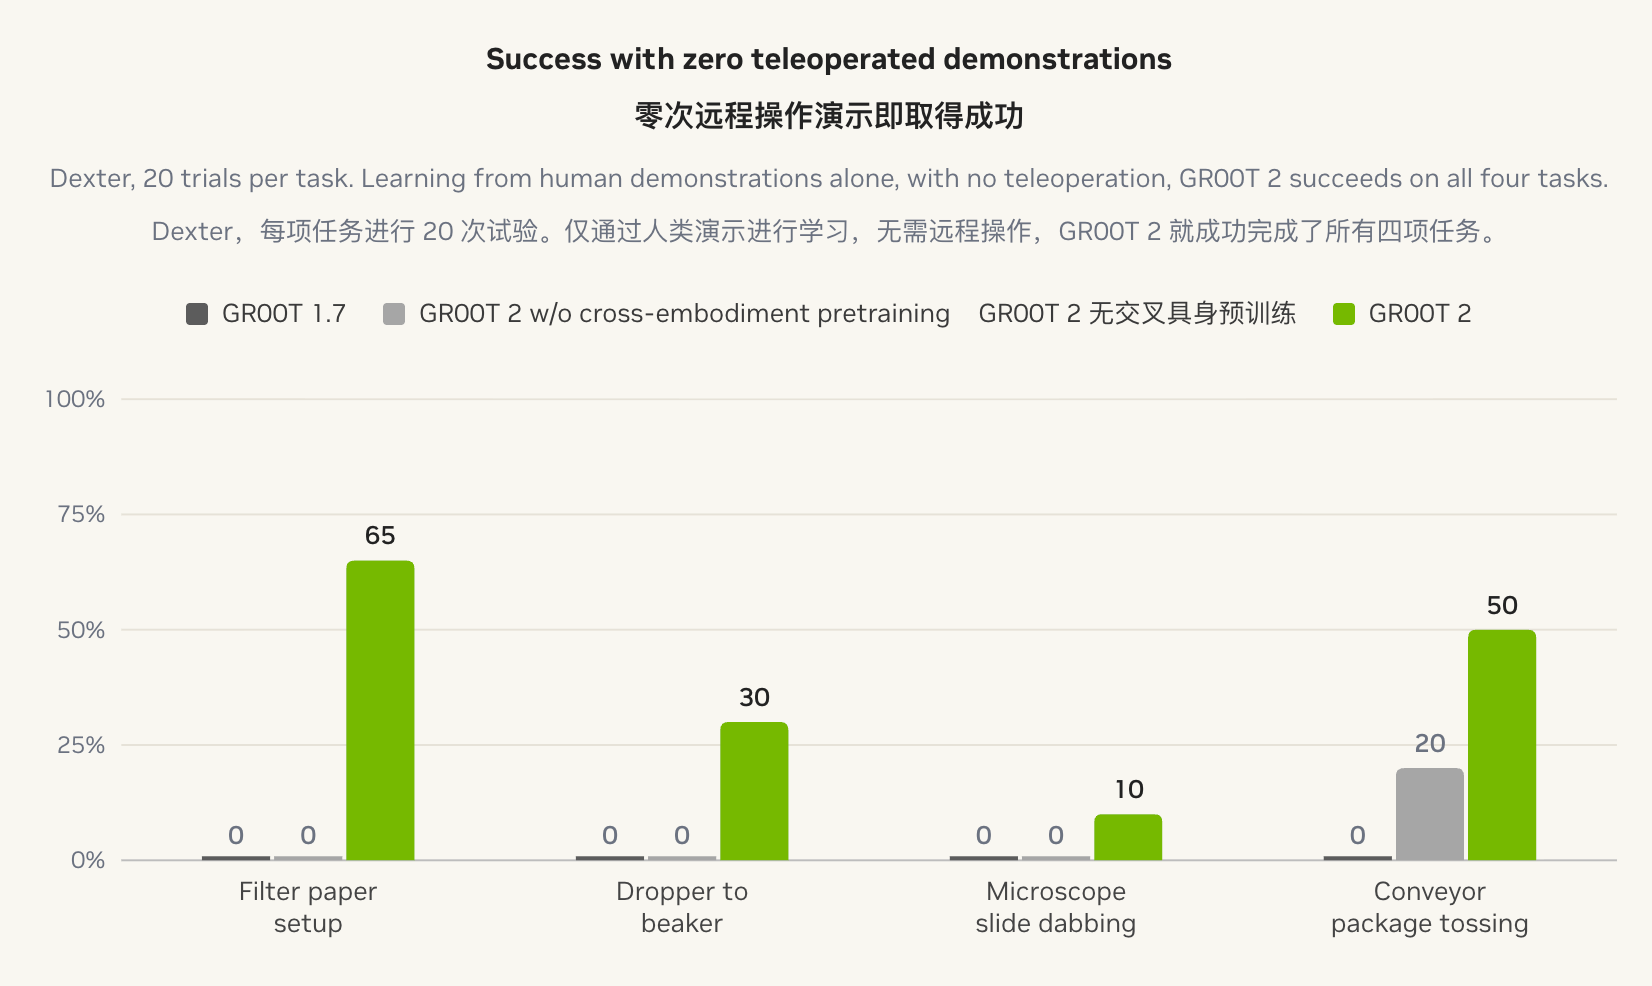
完全不使用遥操作示范,GR00T 2仍能在四项任务上取得成功:滤纸放置成功率为65%,将滴管放入烧杯为30%,显微镜载玻片轻蘸为 10%,投掷传送带上的包裹为50%。
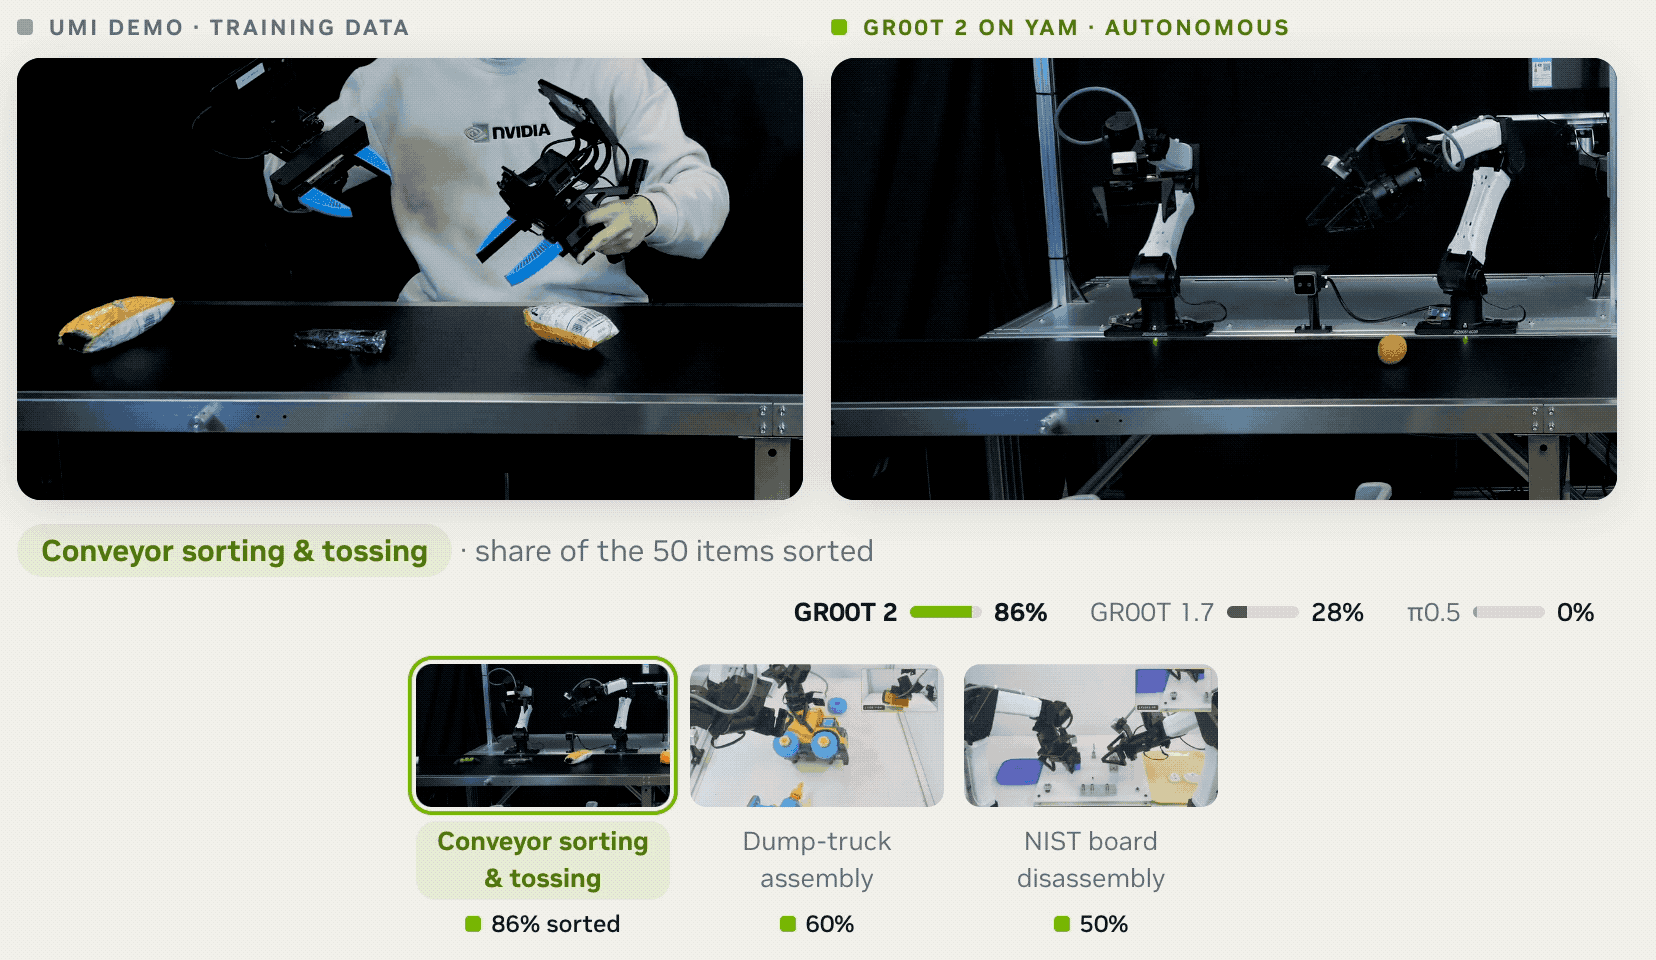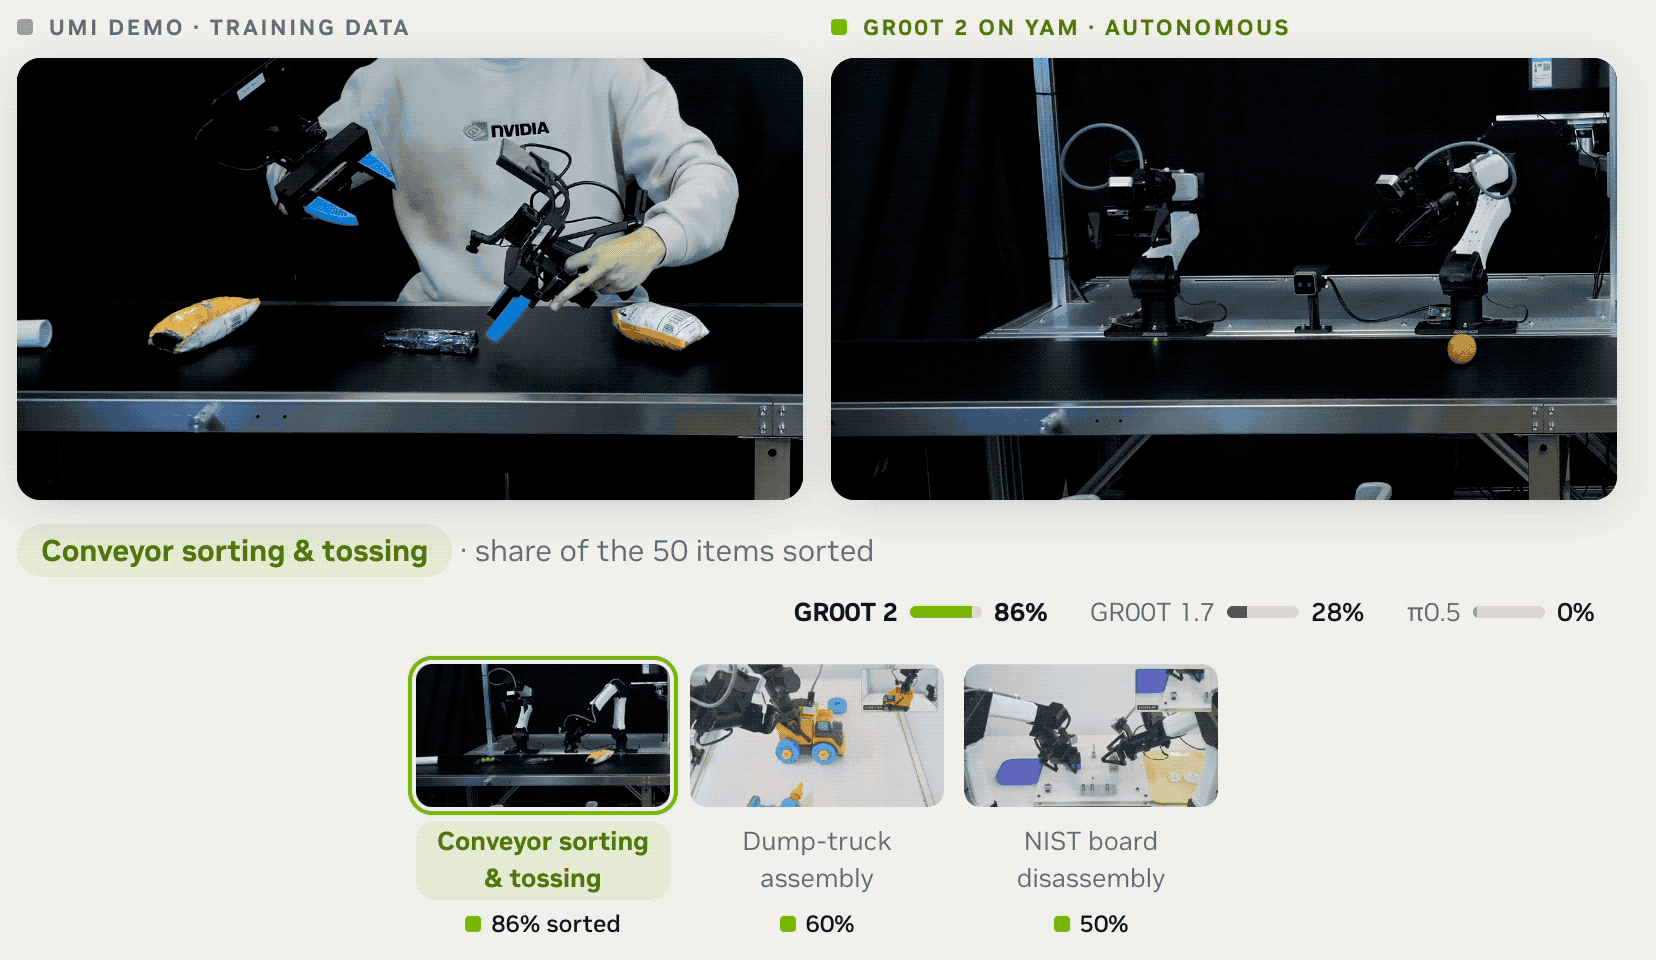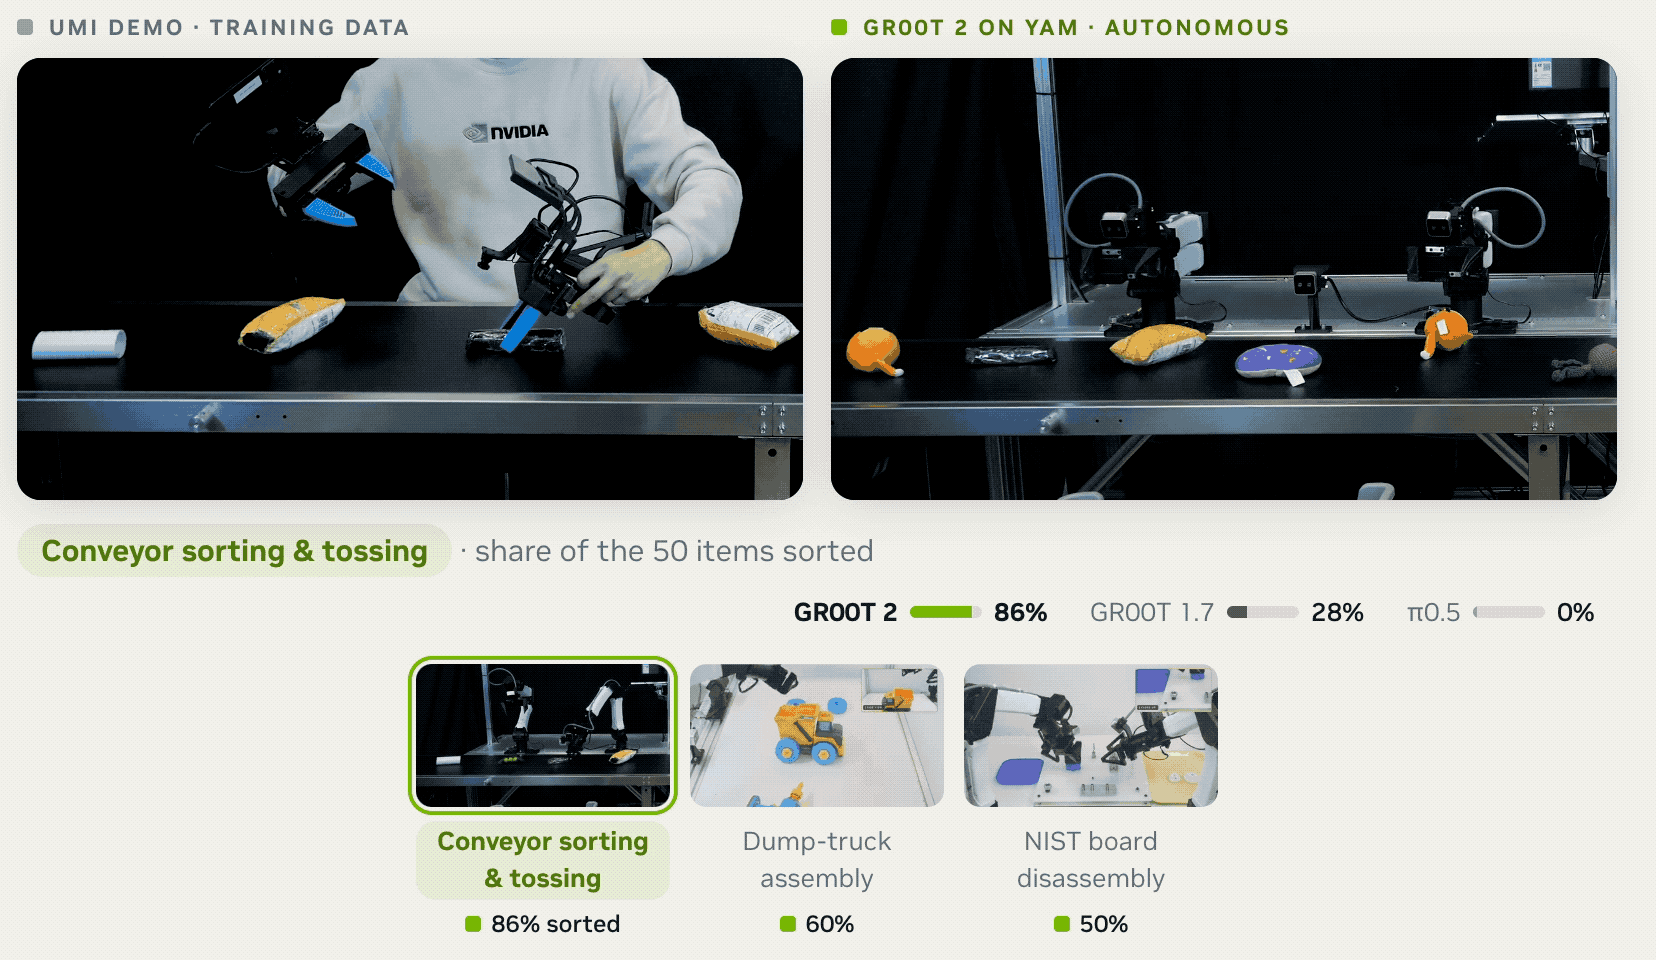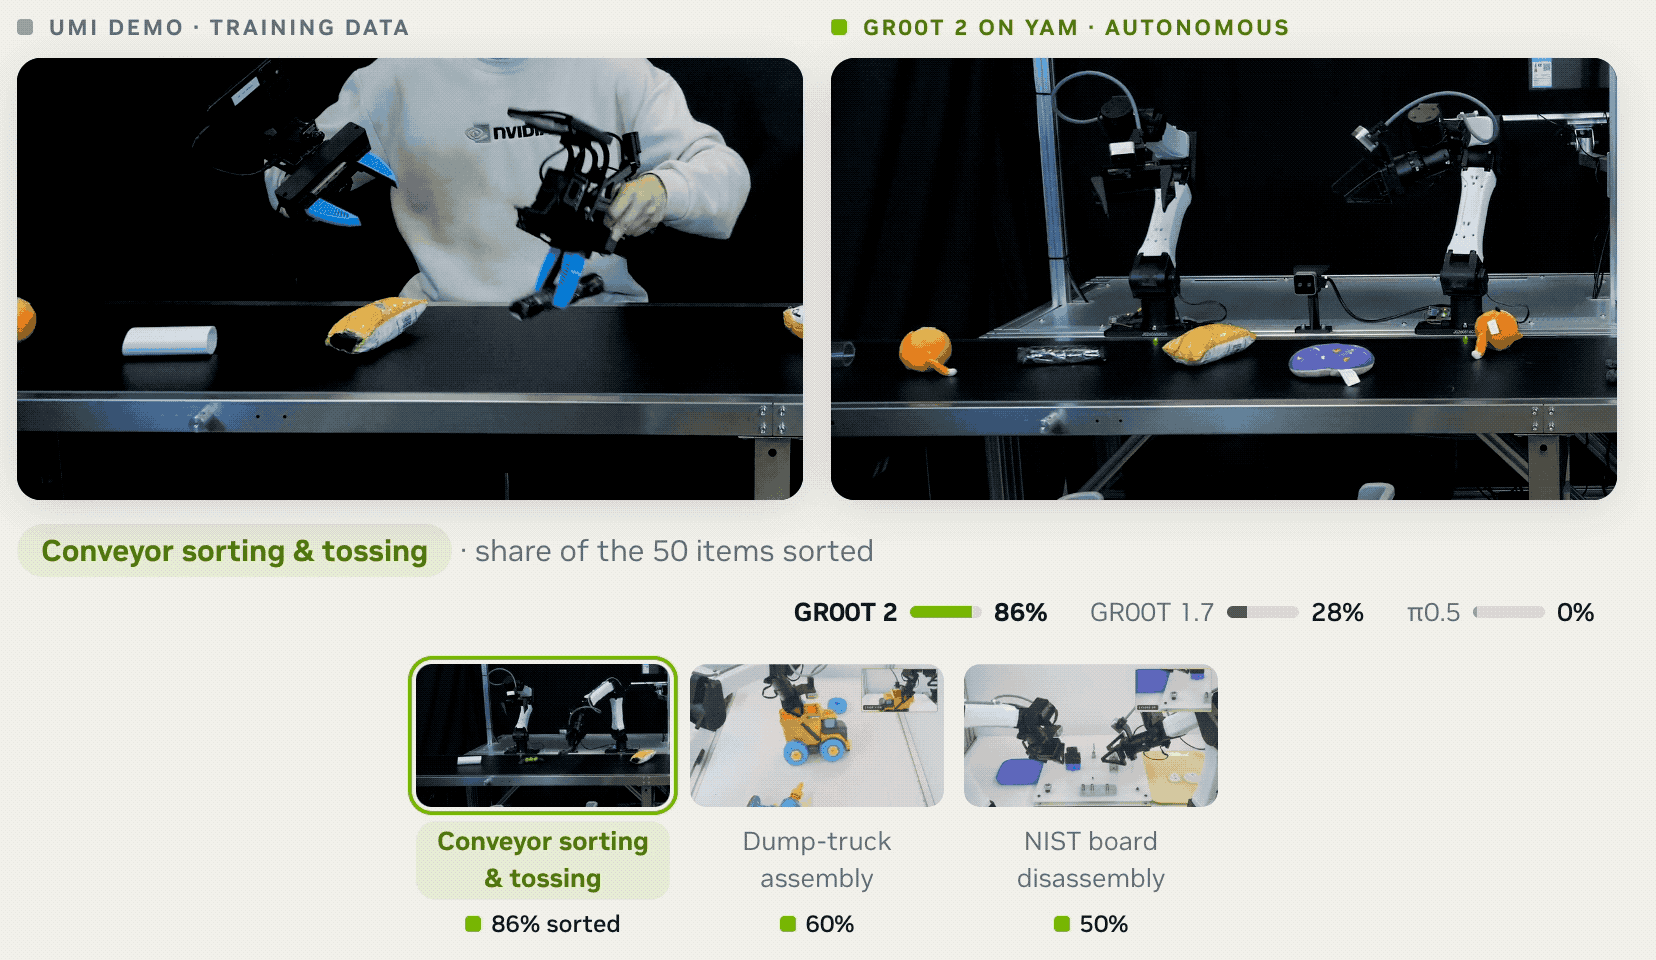
第二种是“手持夹爪到机械臂”。在传送带分拣与投掷、玩具自卸卡车组装、NIST板拆解三大任务中,英伟达都只用手持式GEAR UMI夹爪给模型进行演示。
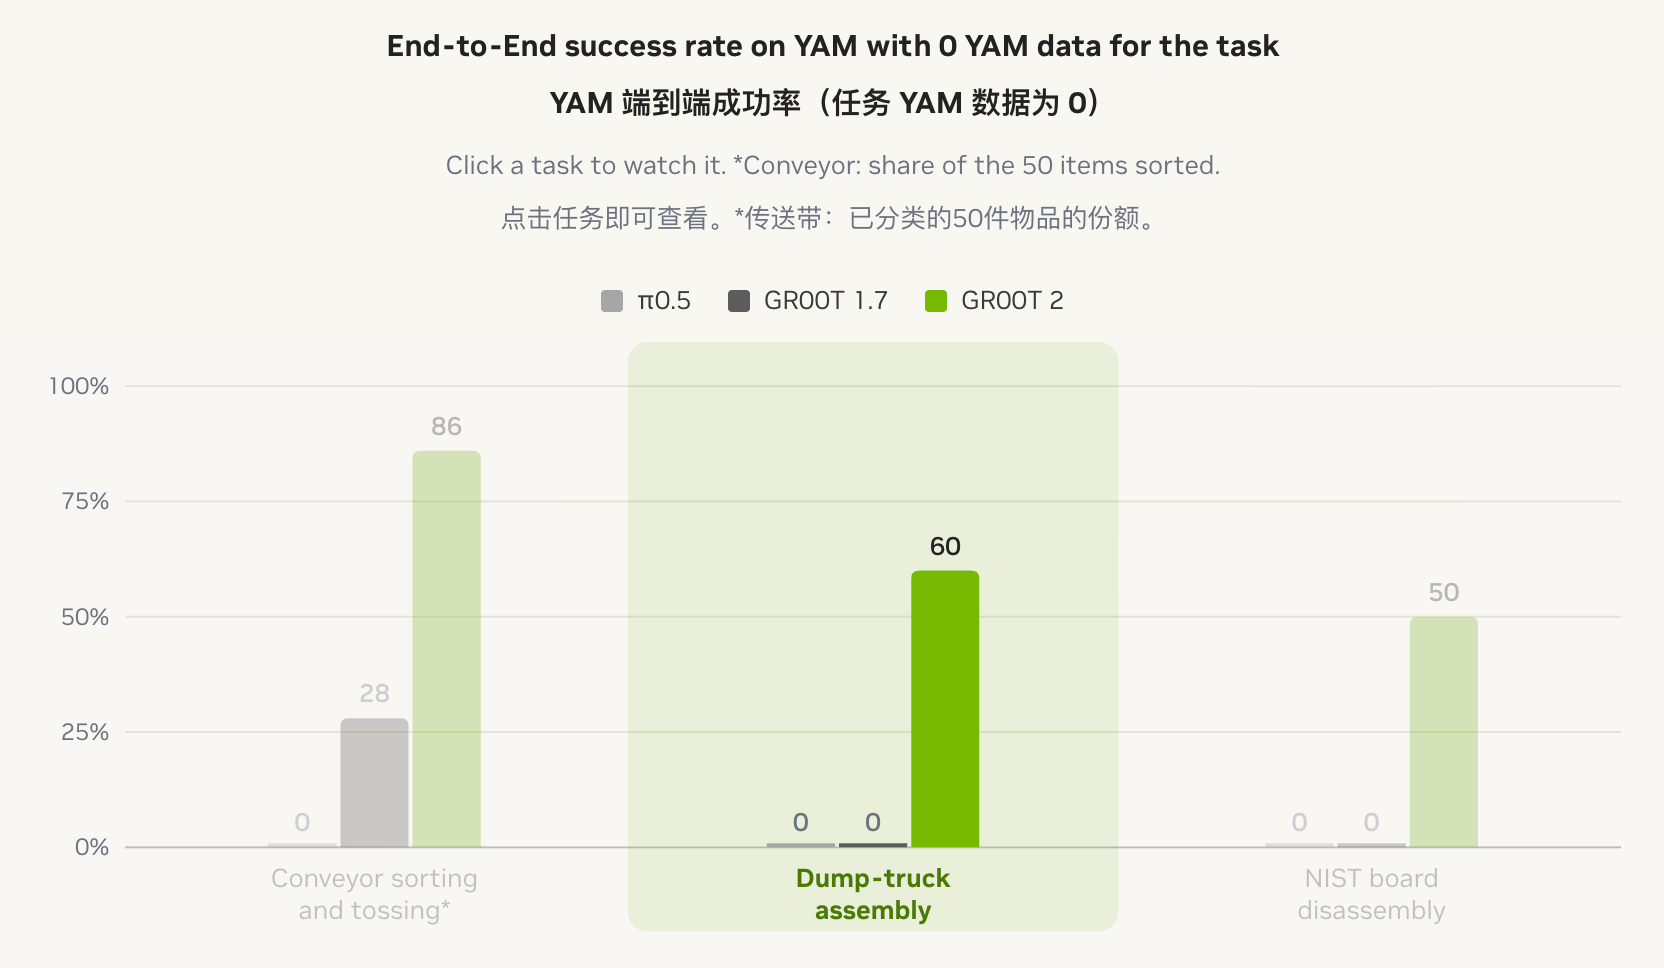
部署在YAM机械臂上的GR00T 2没有这些任务的真机示范数据,最终仍取得86%、60%和50%的成功率。
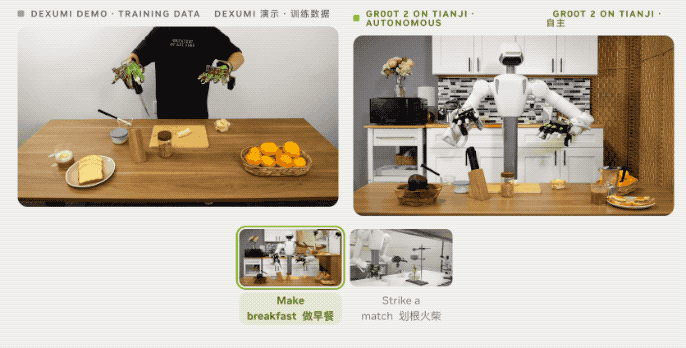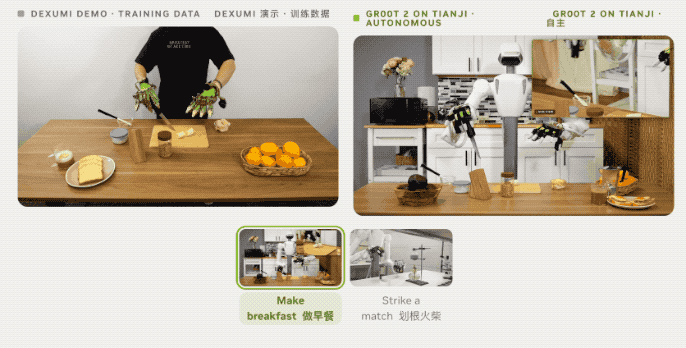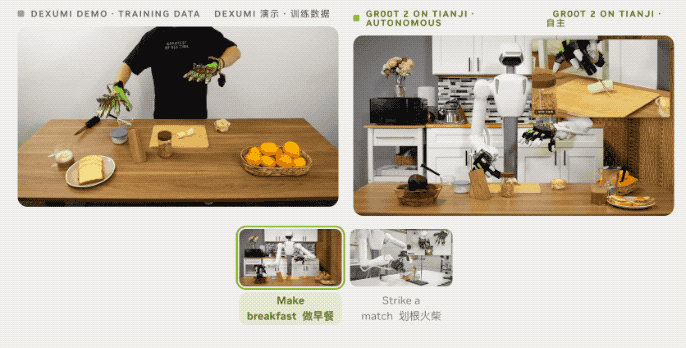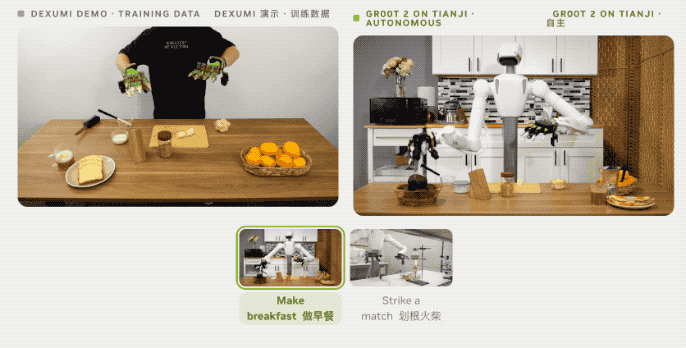
第三种是“可穿戴设备到机器人灵巧手”。GEAR DexUMI是一种与机器人手部关节相对应的可穿戴外骨骼设备(Wearable Exoskeleton),可以将人的手部动作直接映射到机器人上。
仅凭DexUMI示范,GR00T 2便能让配备两只XHAND1灵巧手的天机机器人学会三项双手任务:制作香蕉酸奶、舀取格兰诺拉麦片,以及划火柴点燃烧瓶下方的灯,再将火柴放入水中熄灭。
跨本体迁移主要解决技能如何从一种本体迁移到另一种本体的问题,少样本适应(Few-Shot Adaptation)则进一步回答,模型要如何以较低成本提升任务成功率。
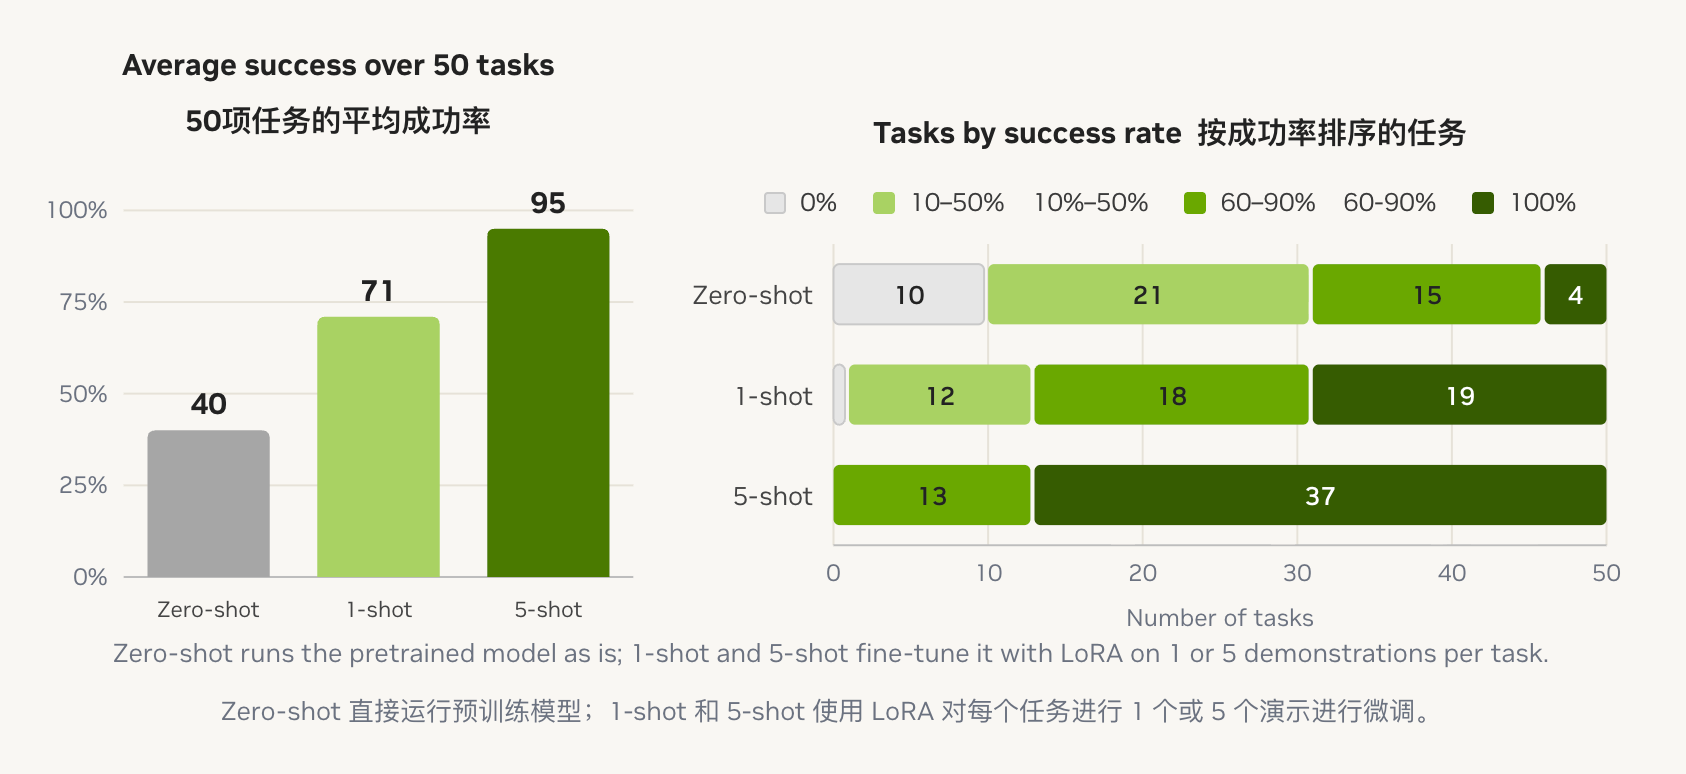
研究团队选取了50项目标机器人从未见过的任务。这些任务只出现在其他机器人的数据或人类视频中,目标机器人则是一台配备两只Sharpa灵巧手的机器人。
在零样本泛化(Zero-Shot Generalization)的条件下,GR00T 2仅凭任务指令,试验成功率就达到了40%,并在50项任务中的40项上至少成功一次。
英伟达发现,大多数失败并非因为模型理解错了任务,而是执行精度不足,机器人能够按正确顺序完成正确步骤,只是某一步没有做到位。
而少量目标机器人的数据,正好可以补上这一缺口。
据其披露,每项任务提供1个示范,平均成功率便提升至71%。提供5个示范后,平均成功率升至95%,50项任务中有37项在每次试验中都能成功。
该公司还补充道,每次适应只需在单张RTX5090上进行30分钟的LoRA(Low-Rank Adaptation)微调。
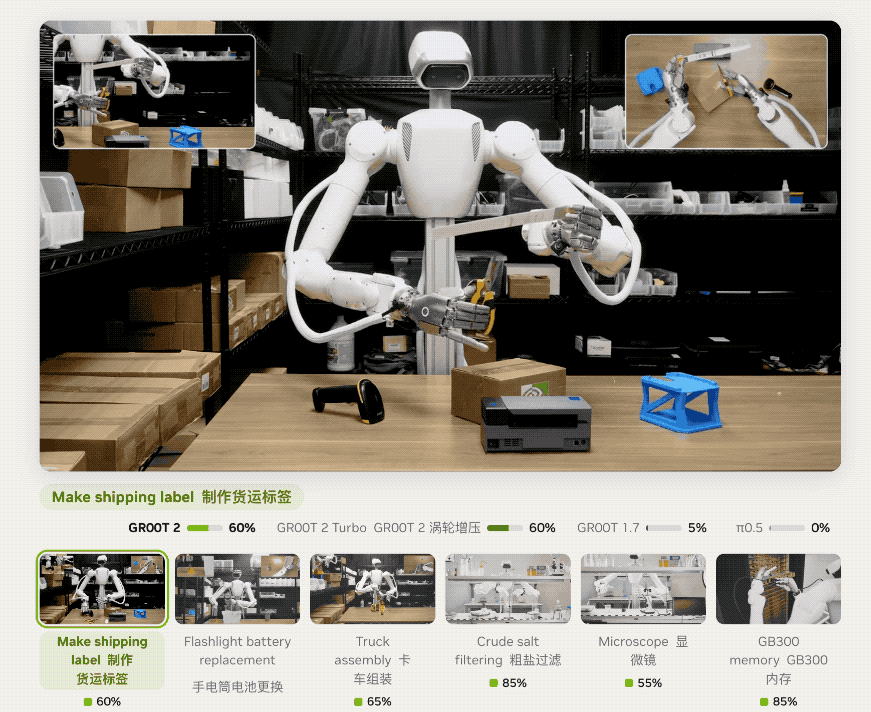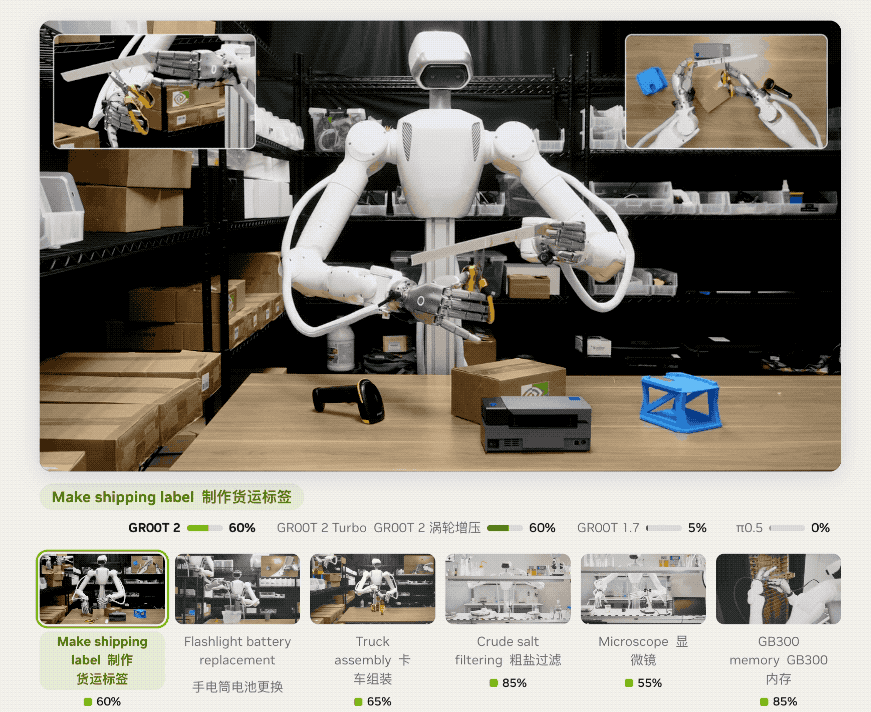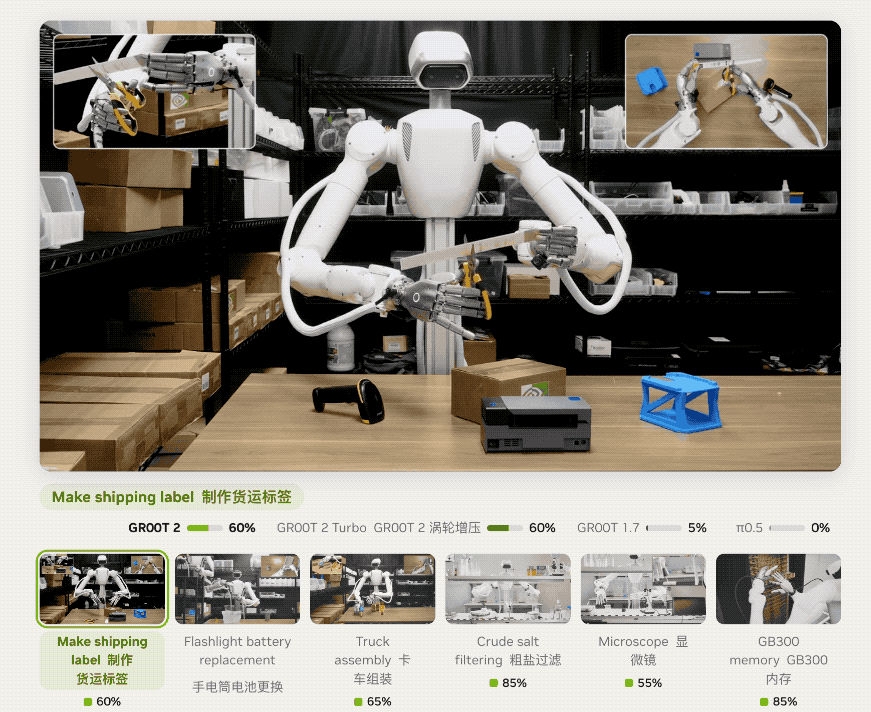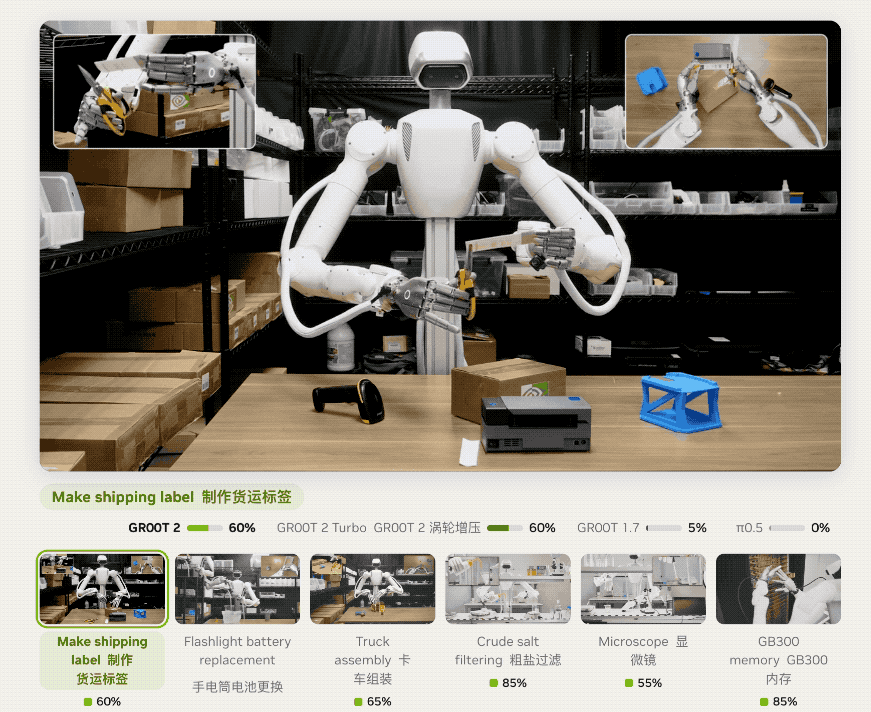
在需要更精细操作的任务上,后训练(Post-Training)同样发挥了作用。
据英伟达介绍,仅需少量的遥操作数据后训练,GR00T 2就能使用两只22自由度的Sharpa灵巧手完成灵巧操作任务,例如为包裹贴标签、更换部件、组装玩具和端到端执行化学实验流程等长时程任务。
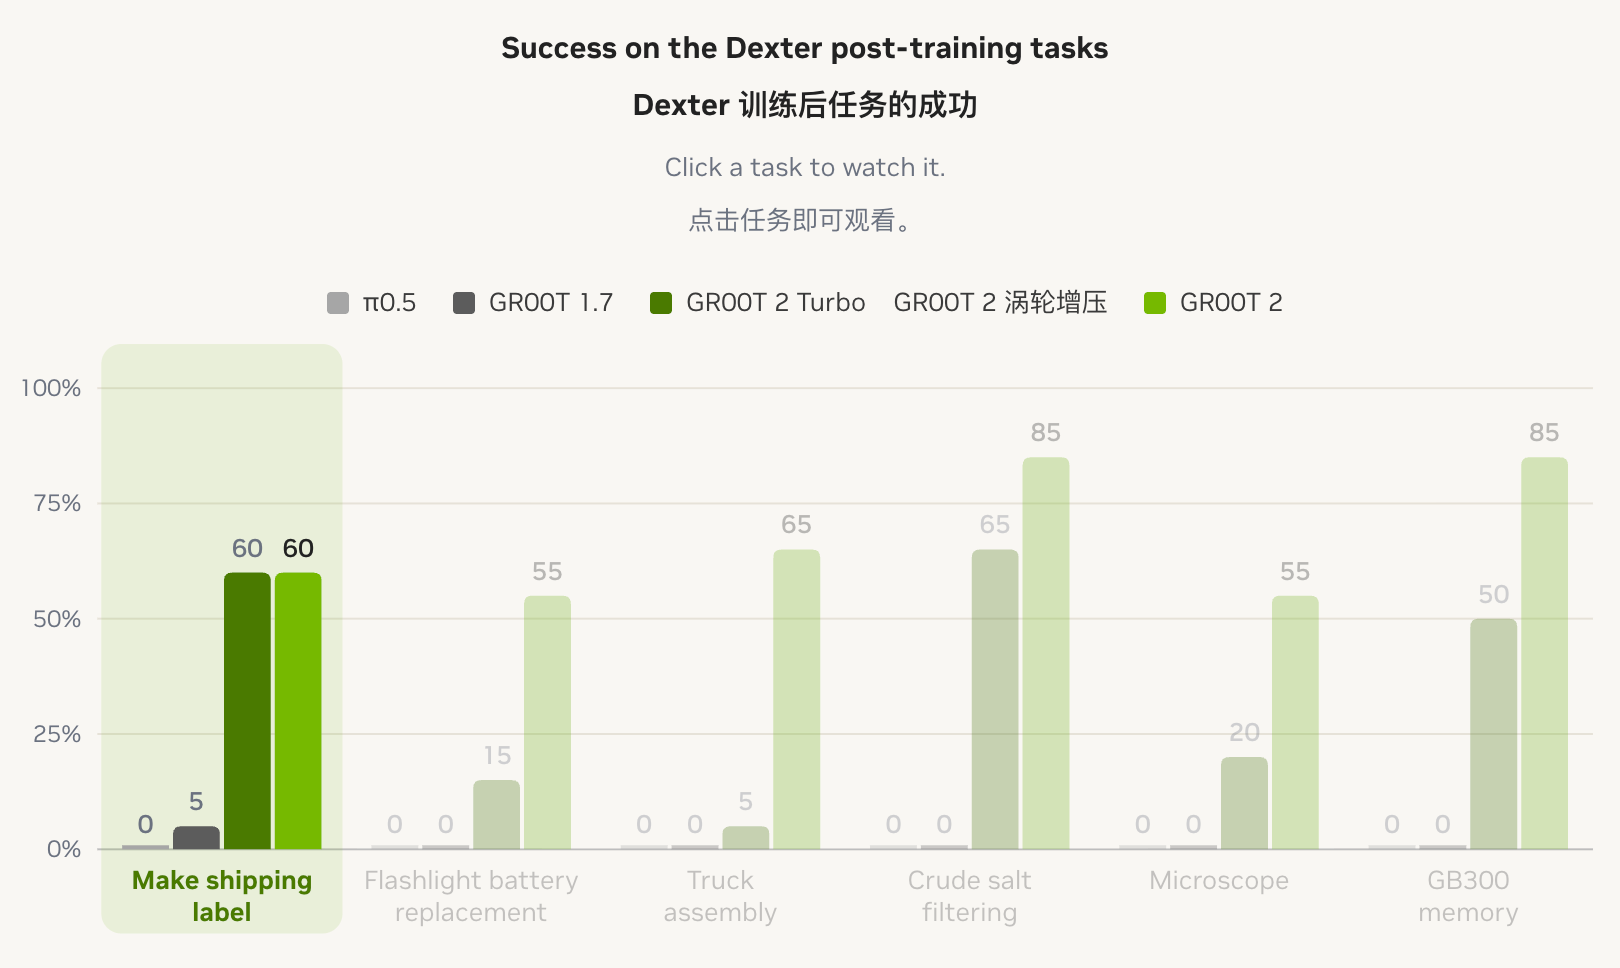
其中,制作并粘贴货运标签、手电筒电池更换、卡车组装、粗盐过滤、显微镜操作和GB300内存模组插入的成功率分别为60%、55%、65%、85%、55%和85%。
二、可用Agent做上层推理,还能通过视觉规划“怎么拿”
单项技能串成长程任务后,机器人还需要面对任务理解规划、失败恢复的问题。GR00T 2给出的方案,是让前沿推理智能体(Reasoning Agent)与机器人模型分工协作。
智能体决定“做什么”,负责拆解任务、检查进度和编写代码;GR00T 2决定“怎么做”,执行难以通过脚本编写的大量交互操作。
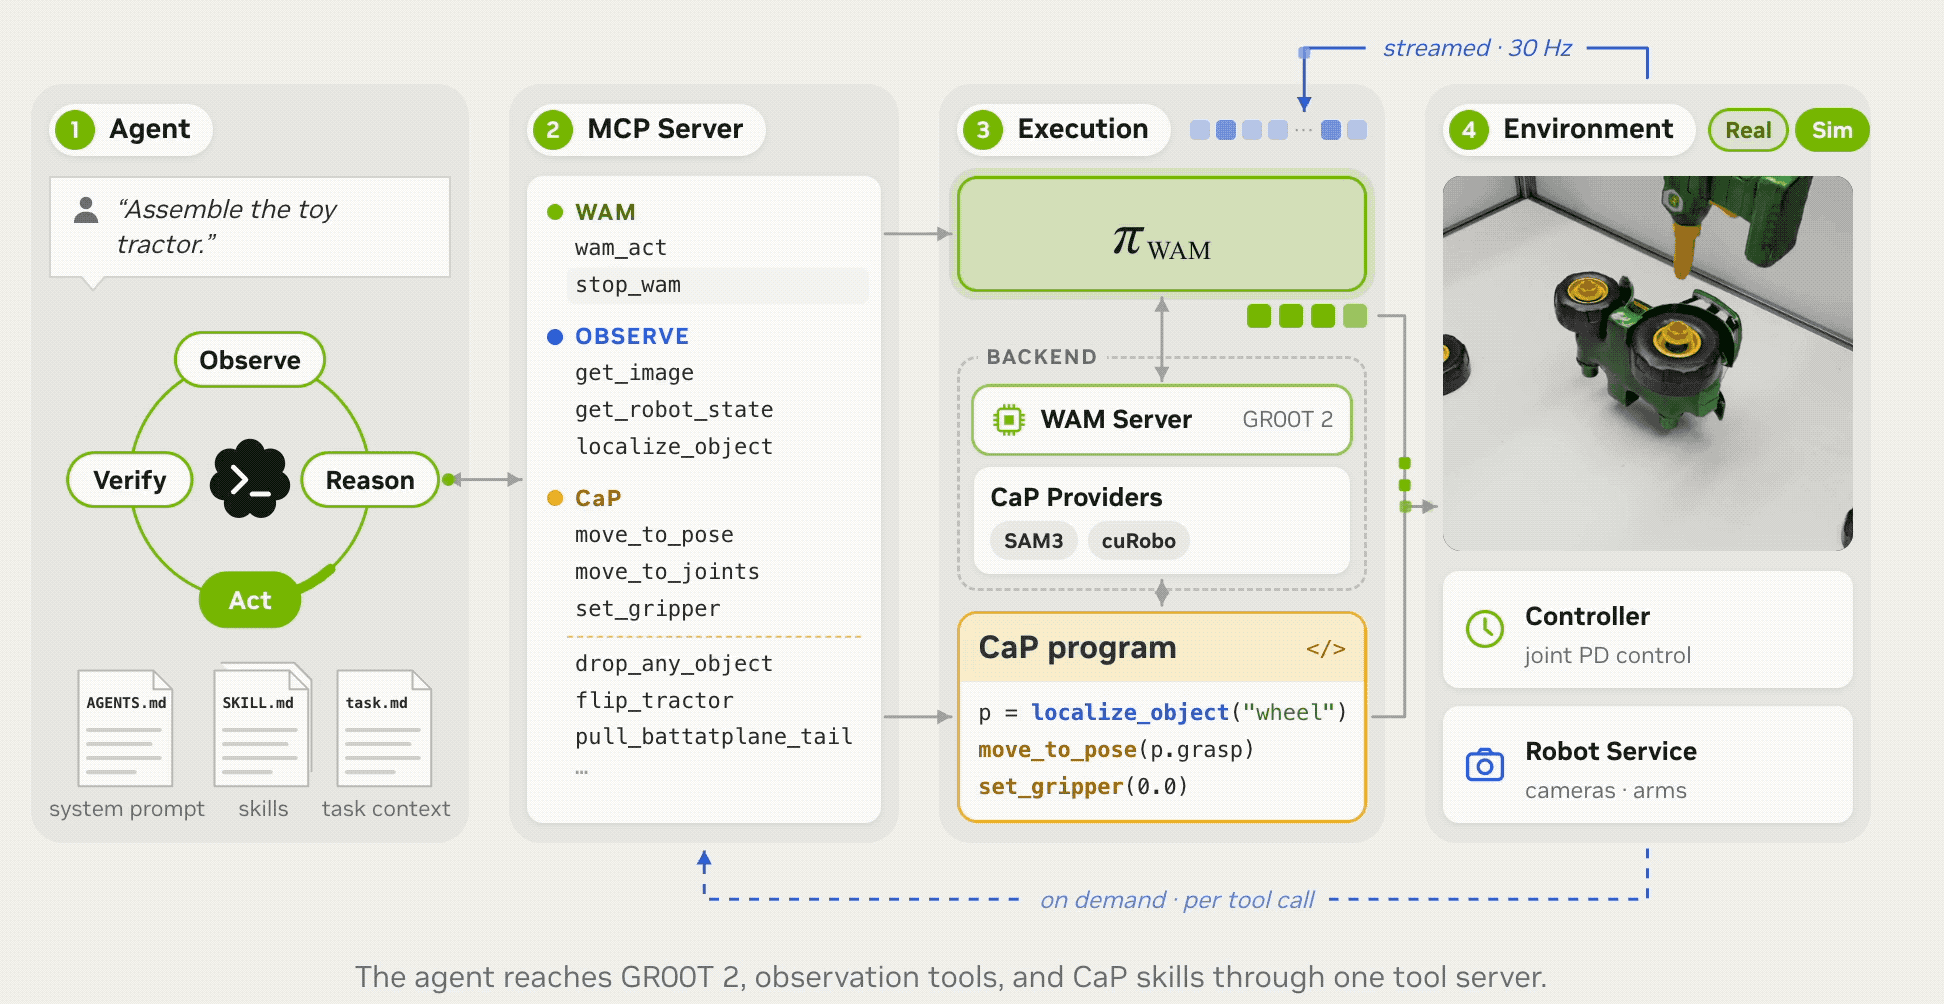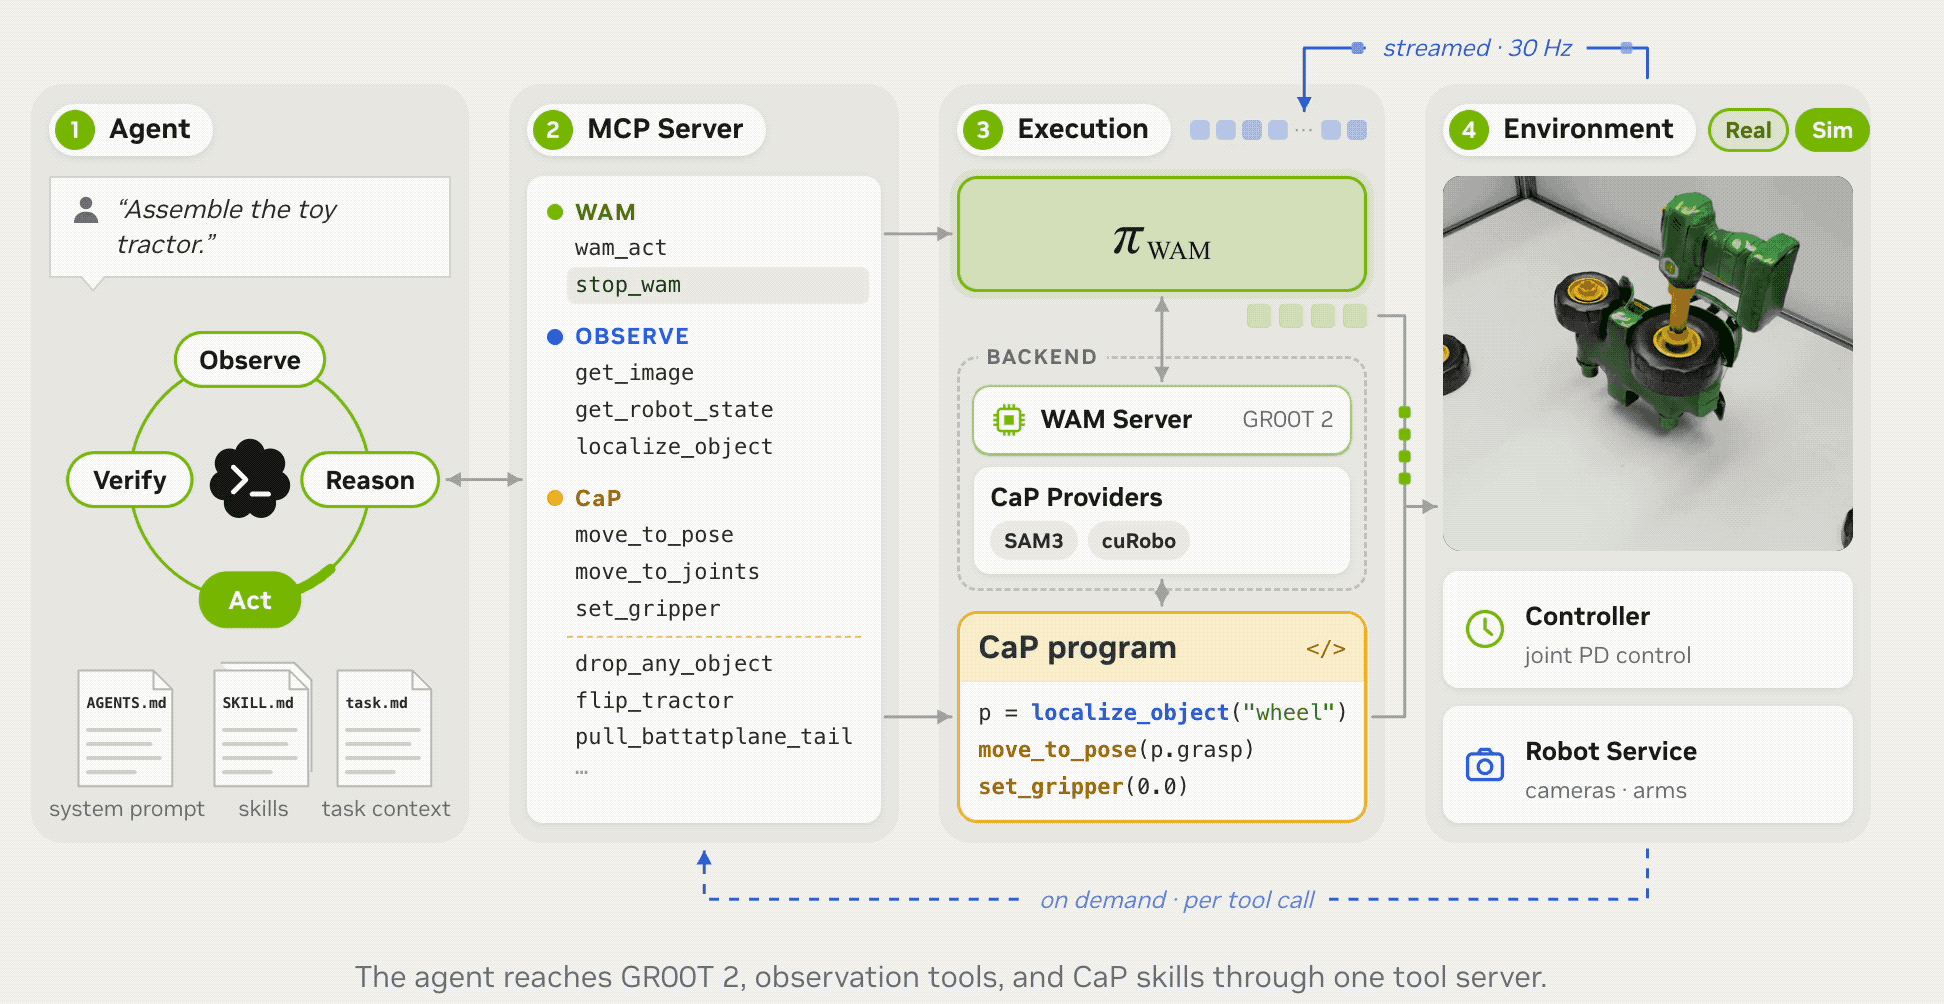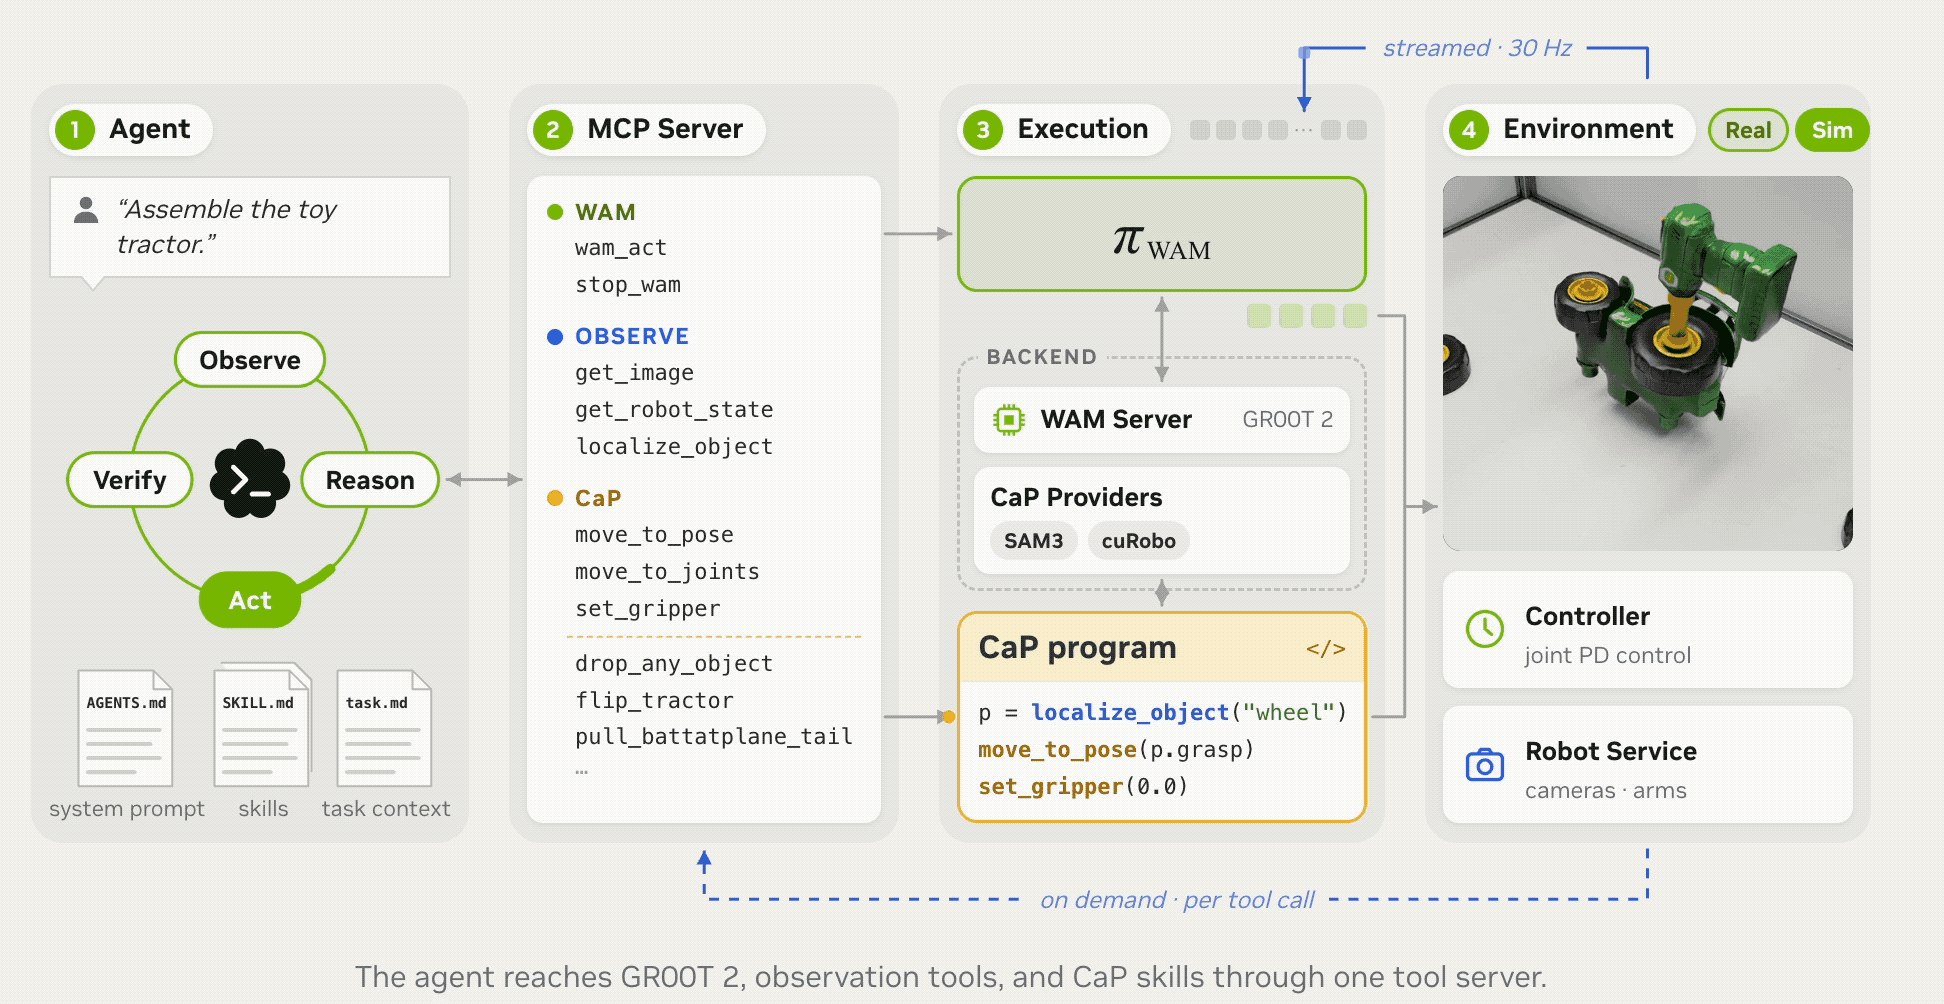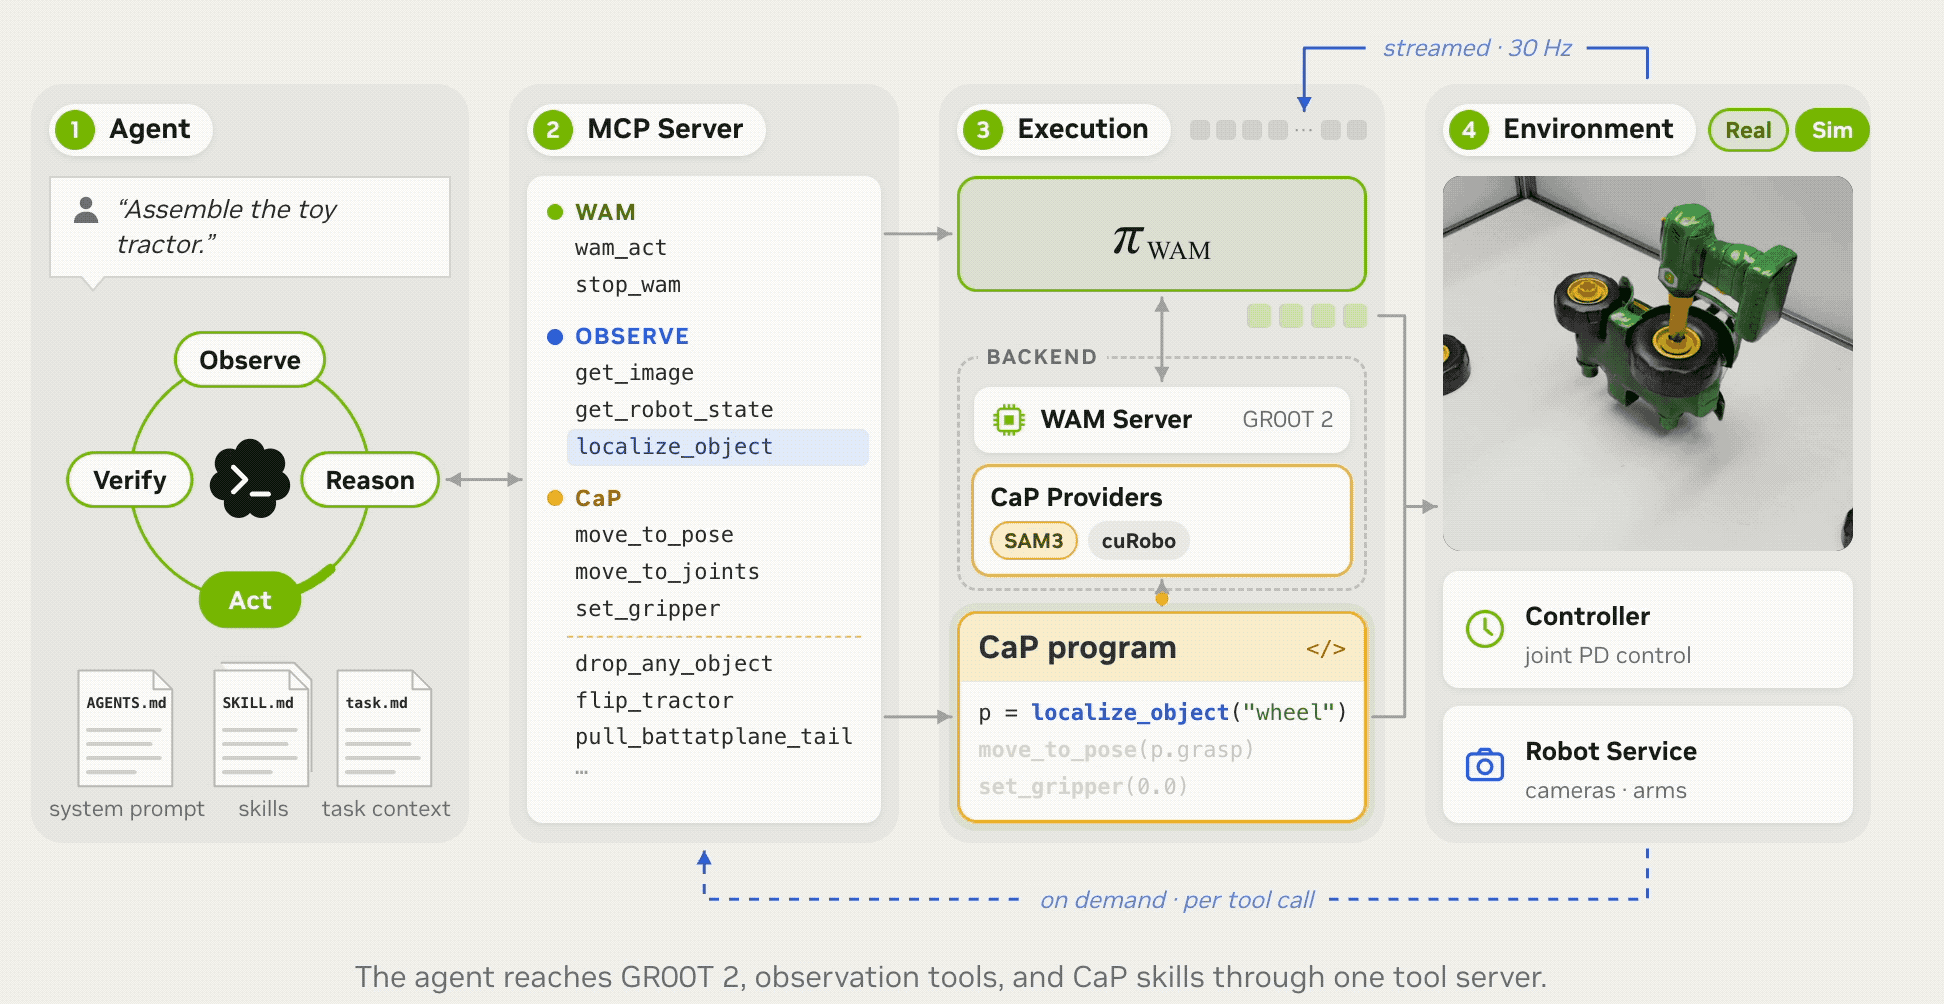
通过世界—动作模型API,智能体可以把GR00T 2作为工具调用,与相机图像、机器人状态和代码即策略(Code-as-Policy,CaP)技能配合使用。
在实体机器人上,GR00T 2完成大部分操作,智能体持续监测执行情况。一旦零件掉落或进度停滞,智能体就调用通过ASPIRE学到的CaP 技能恢复场景,再把控制权交还GR00T 2。
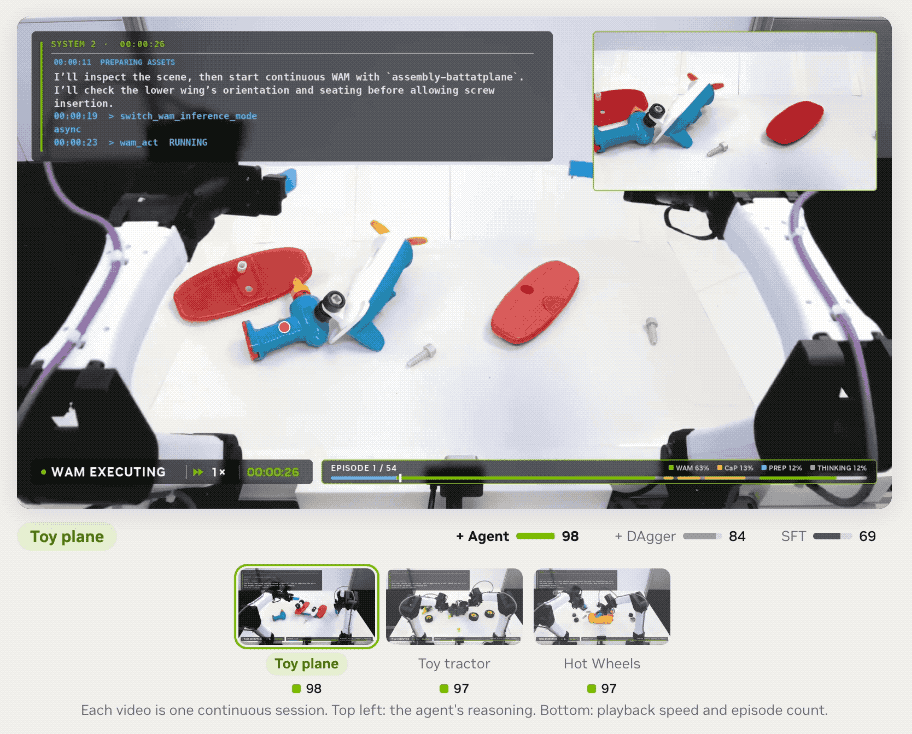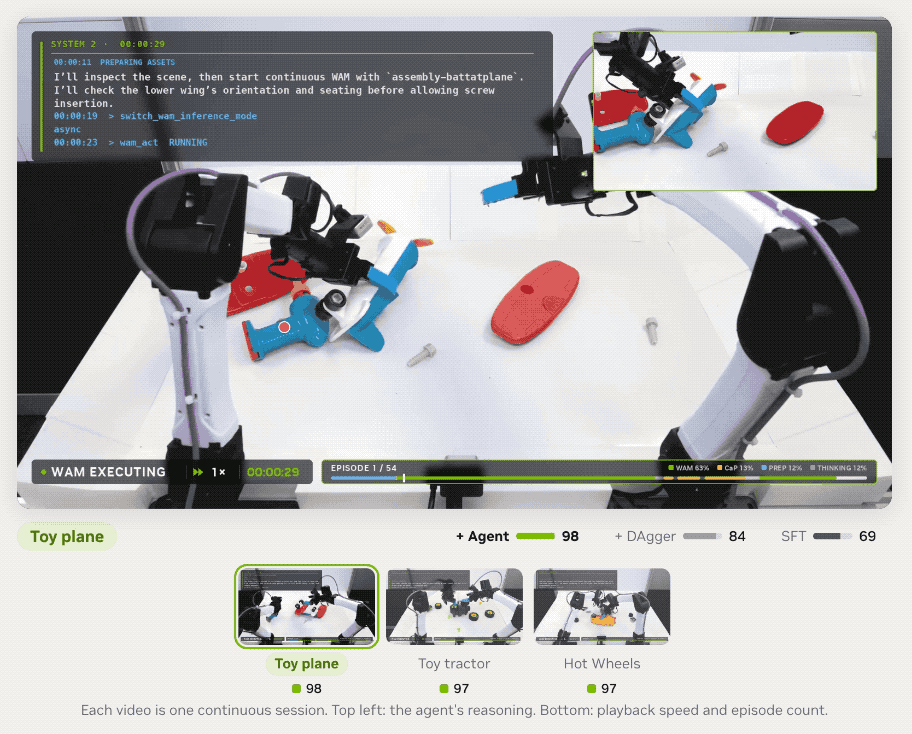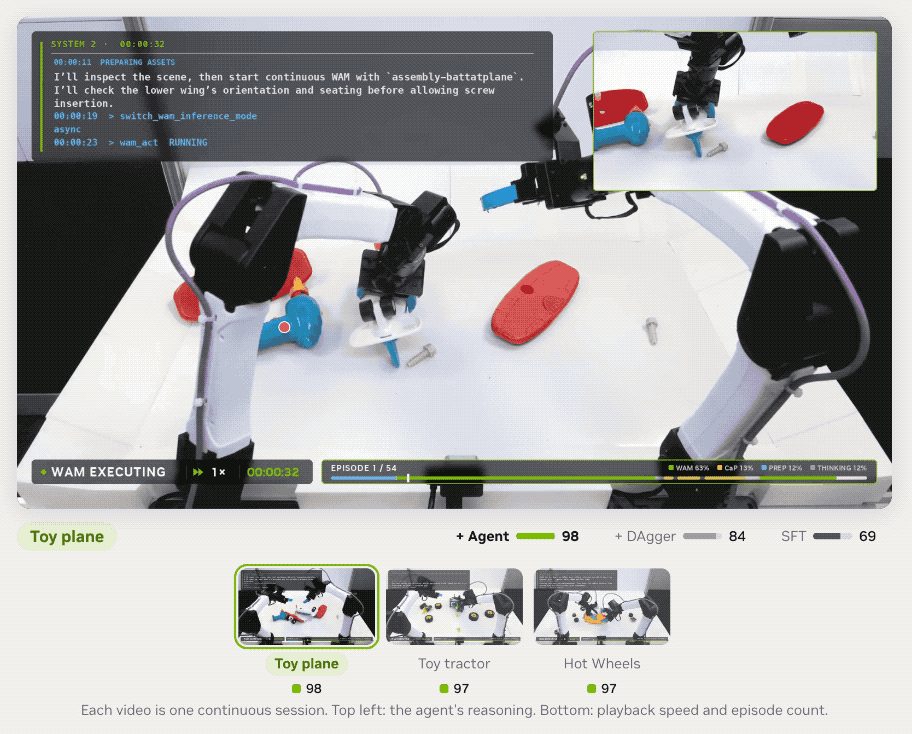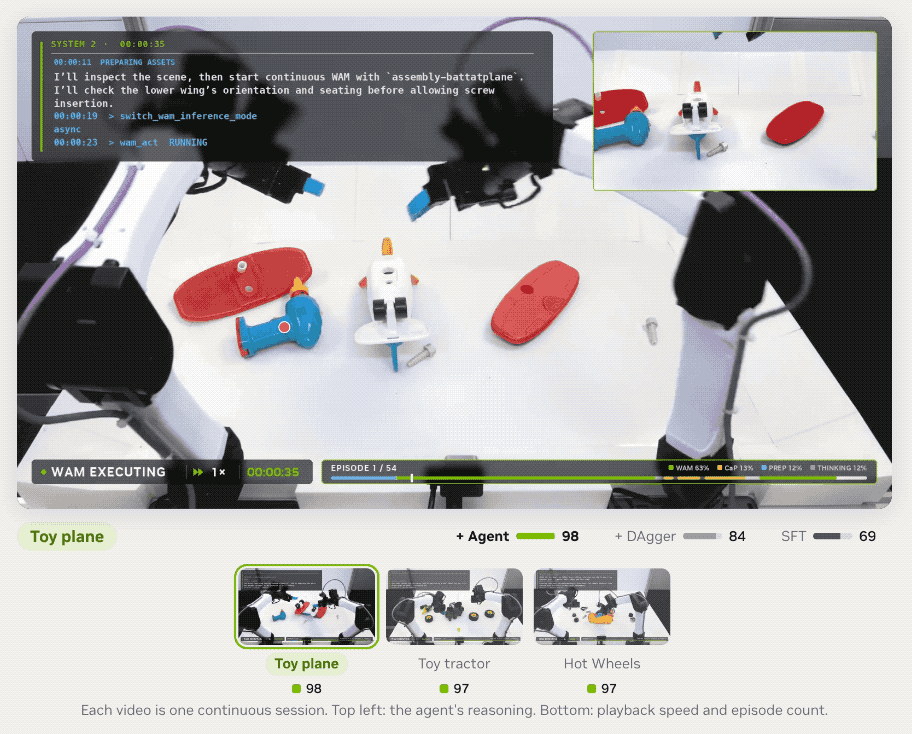
每次试验前,所有零件都会被倒在桌面上,形成后训练数据中未曾出现的杂乱布局。
在这种条件下,GR00T 2配合智能体,组装玩具飞机、玩具拖拉机和Hot Wheels玩具车时,分别在100次试验中成功98次、97次和97次。
不过,从视频时长来看,GR00T 2花费时间较多,距离实际应用仍有提升空间。
智能体还能把真实世界强化学习(Real-World Reinforcement Learning)获得的技能组合成更长的任务。
例如,将五根以太网线依次插入网络交换机,或将五个充电器插入指定的插座。
在这个过程中,CaP负责定位、抓取和放置,GR00T 2执行对精度要求较高的插入动作,智能体则安排步骤、验证结果,并在需要时调用恢复技能。
视频中,机械臂能够精准定位到以太网线的接口,完成插入操作,模型还会确认任务完成后,再进行下一步操作。
在成功率上,将监督策略替换为经过强化学习训练的GR00T 2后,线缆任务的完整成功次数由20次中的12次提升至19次,充电器任务则由20次中的2次提升至20次。
而语言指令在杂乱环境中指挥机器人,还可能会面临目标物体和执行动作不明确的情况,因此英伟达在GR00T 2引入了视觉引导(Visual Steering)能力。
简单来说,规划器可直接在 GR00T 2 的相机画面中标出抓取点和释放点,并用不同颜色区分执行机械臂,GR00T 2 随后完成接近、抓取、搬运和释放等动作。
每一步结束后,规划器会重新观察,决定继续、重试或停止。该功能无需新增训练数据,标注点则可从现有示范的夹爪和手部状态中提取,由此模型依然能仅凭语言指令运行。
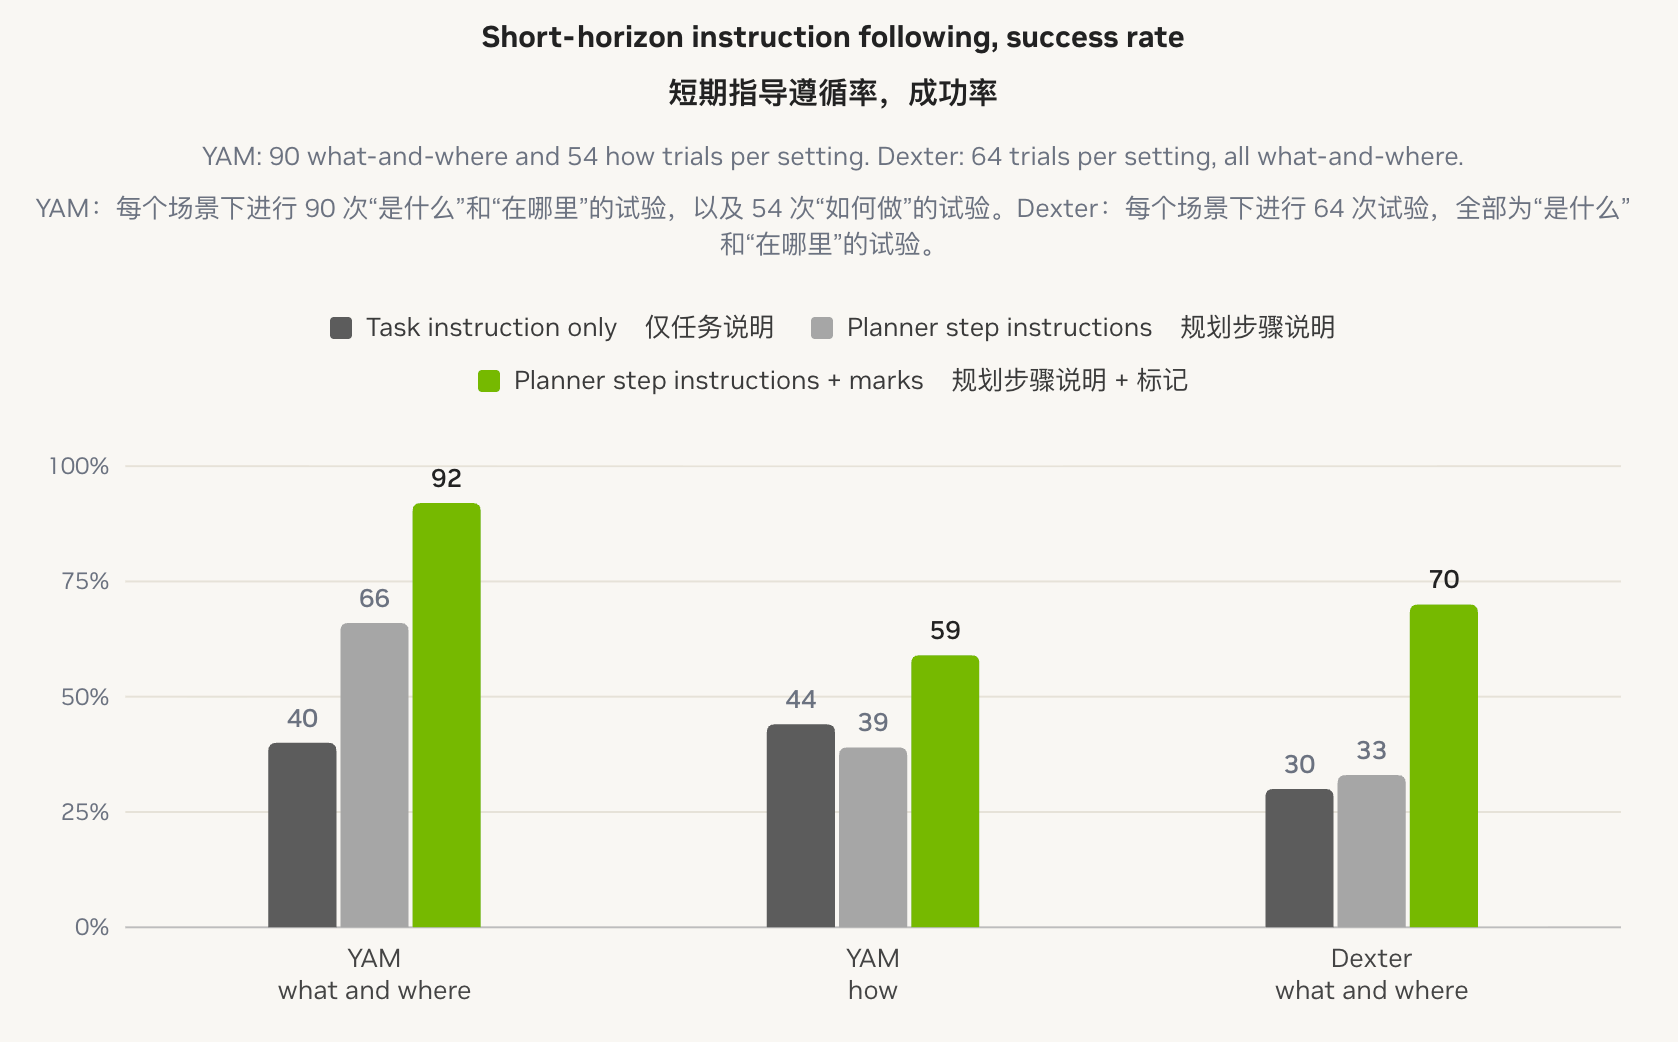
对于“移动什么、移动到哪里”的短程指令,分步指令加标注将YAM机械臂操作的成功率由仅提供任务指令时的40%提升至92%,灵巧手操作则由30%提升至70%。
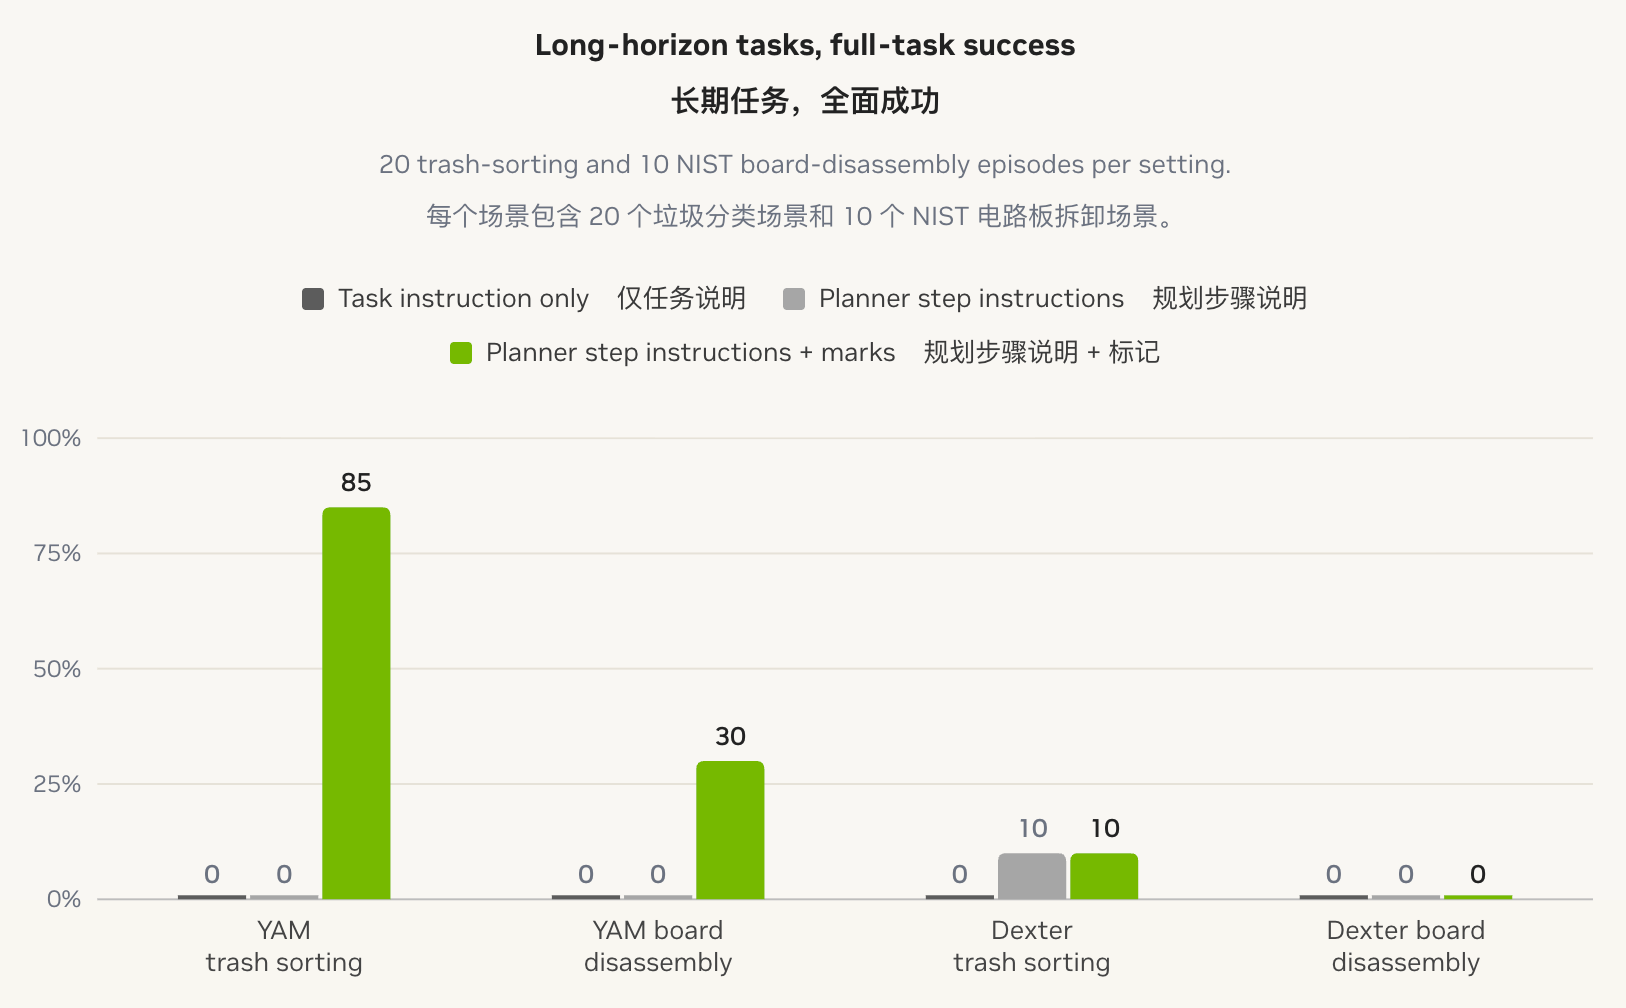
长程任务中的差距更加明显。在YAM机械臂上,没有标注时,即使提供规划器的分步指令,GR00T2也无法完整完成垃圾分类或任务板拆解;加入标注后,20次垃圾分类完整完成17次,10次电路板拆卸任务完整完成了3次。
不过,英伟达也发现,在灵巧操作上,标注点能帮助机器人分拣更多垃圾,但模型很少能完成整个任务,这是该系统目前的局限。
此外,标注点无法传达物体的最终朝向信息,也无法说明抓取与释放之间的动作关系,如倾倒或擦拭这类复杂的动作信息仍需通过语言表达。
三、推出更快端侧版本,指挥宇树G1打扫房间
此外,面向人形机器人,GR00T2还推出了更强调速度的GR00T 2 Turbo。
人形机器人要完成全身移动操作(Whole-Body Loco-Manipulation),必须在全身快速运动时保持平衡,同时把双手准确移动到位。
Turbo通过小型联合视频-动作Transformer和更高压缩率的视频编码器降低建模成本,其中联合视频-动作Transformer的参数量仅为20亿。
这个更小的模型依然采用和GR00T 2类似的架构,但可以直接在宇树G1上运行。
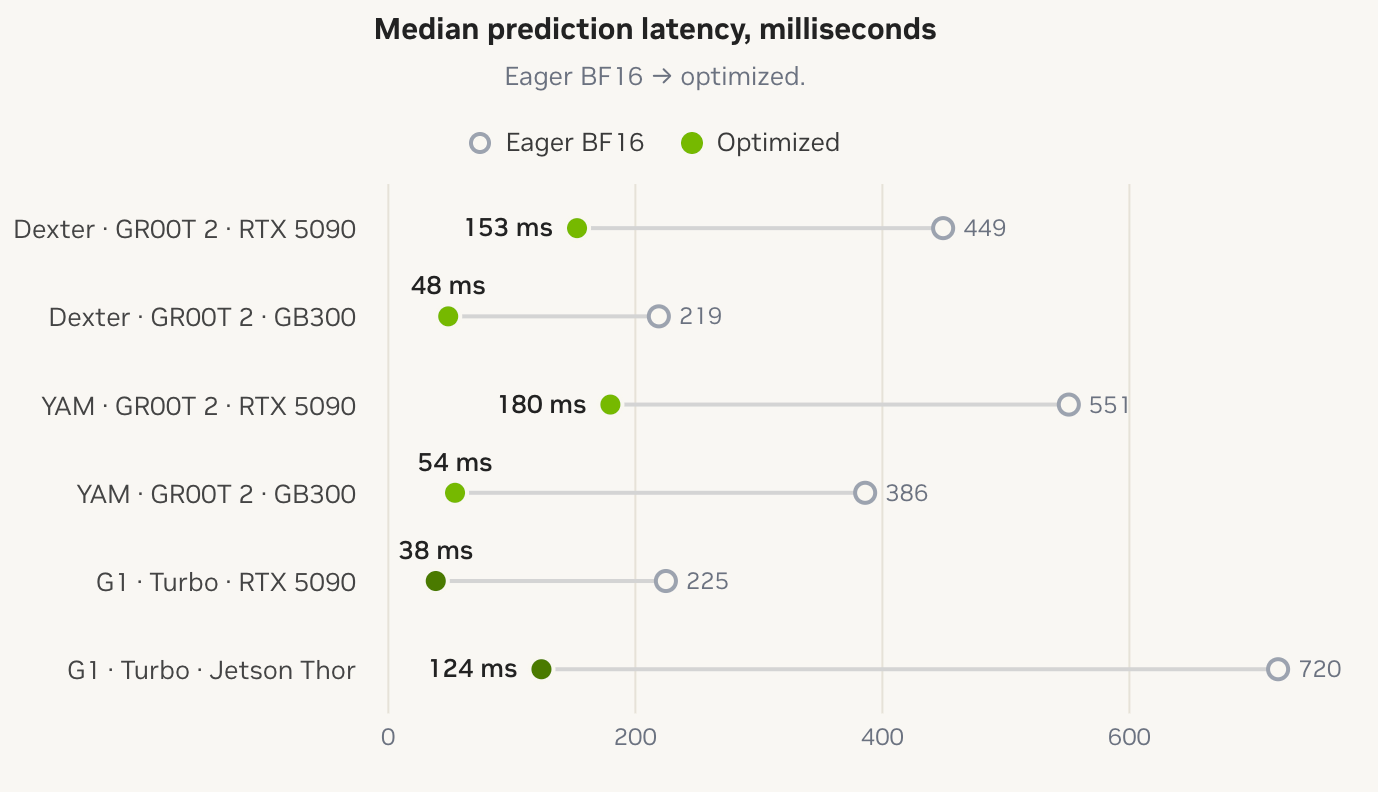
经过优化,Turbo为G1完成一次推理,在 RTX 5090上耗时38毫秒,在机载Jetson Thor上耗时124毫秒。
由此,模型得以实现约每秒规划一次时长1.6秒的全身运动token块,再由SONIC全身控制器以50Hz的频率执行。
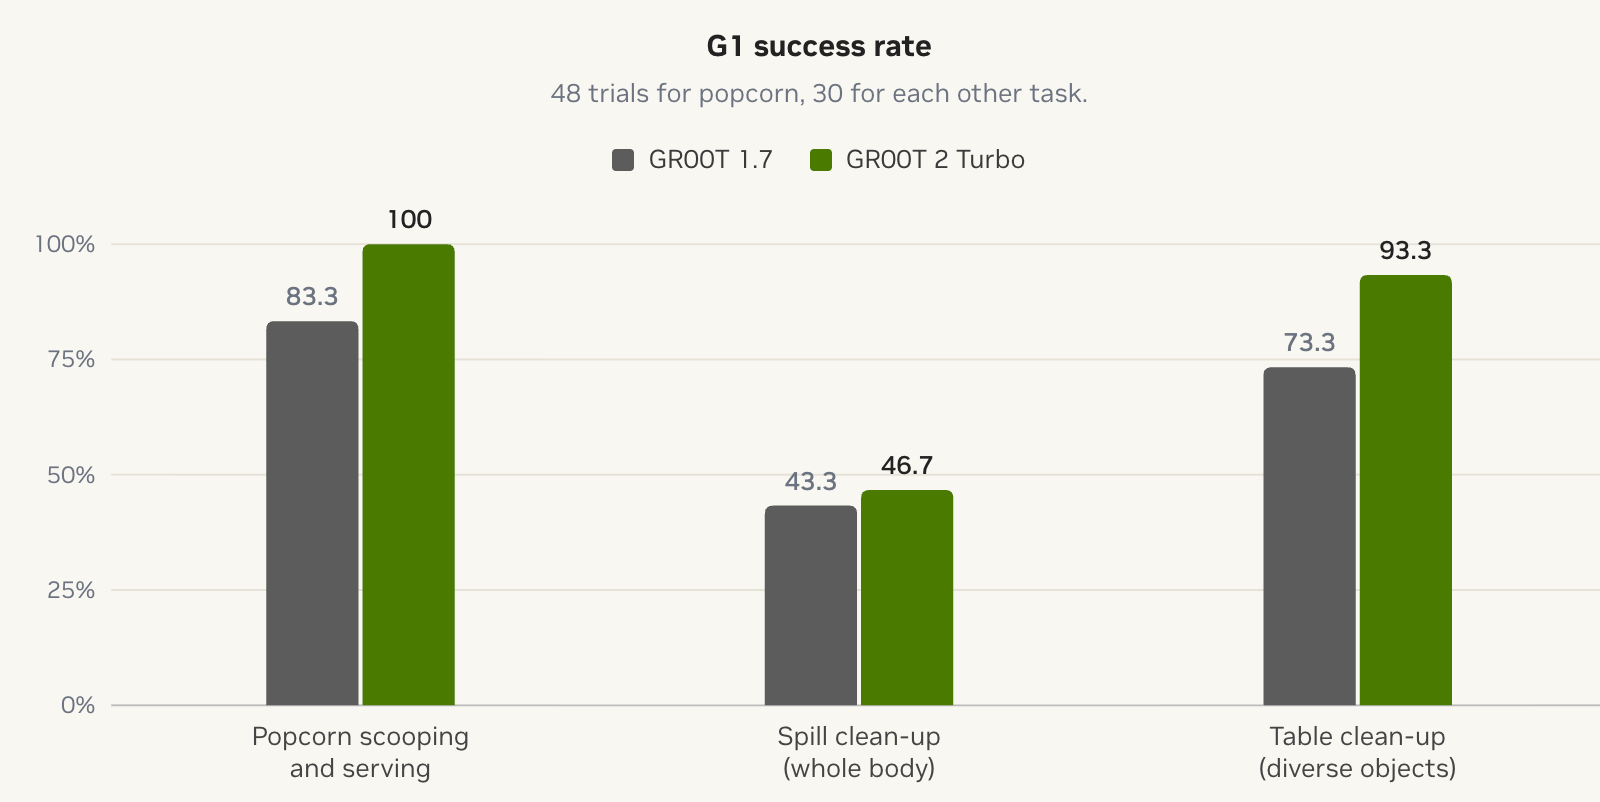
在真实世界任务中,GR00T 2 Turbo控制G1舀取并分装爆米花,48次任务全部成功。而地面撒漏清理的任务成功率为46.7%,清理桌面上多种物品的任务成功率为93.3%,相较GR00T 1.7均有提升。
从视频来看,G1的动作较为流畅,停顿较少,且能持续执行数分钟的任务,展现了一定的长程任务执行能力。
四、使用超40万小时人类视频训练,核心采用DiT架构
在训练上,GR00T 2使用了三类预训练数据,包括402,730小时的人类工作第一视角视频、覆盖2,897项任务的10,184小时手持式UMI夹爪数据,以及23,500小时的机器人遥操作数据。
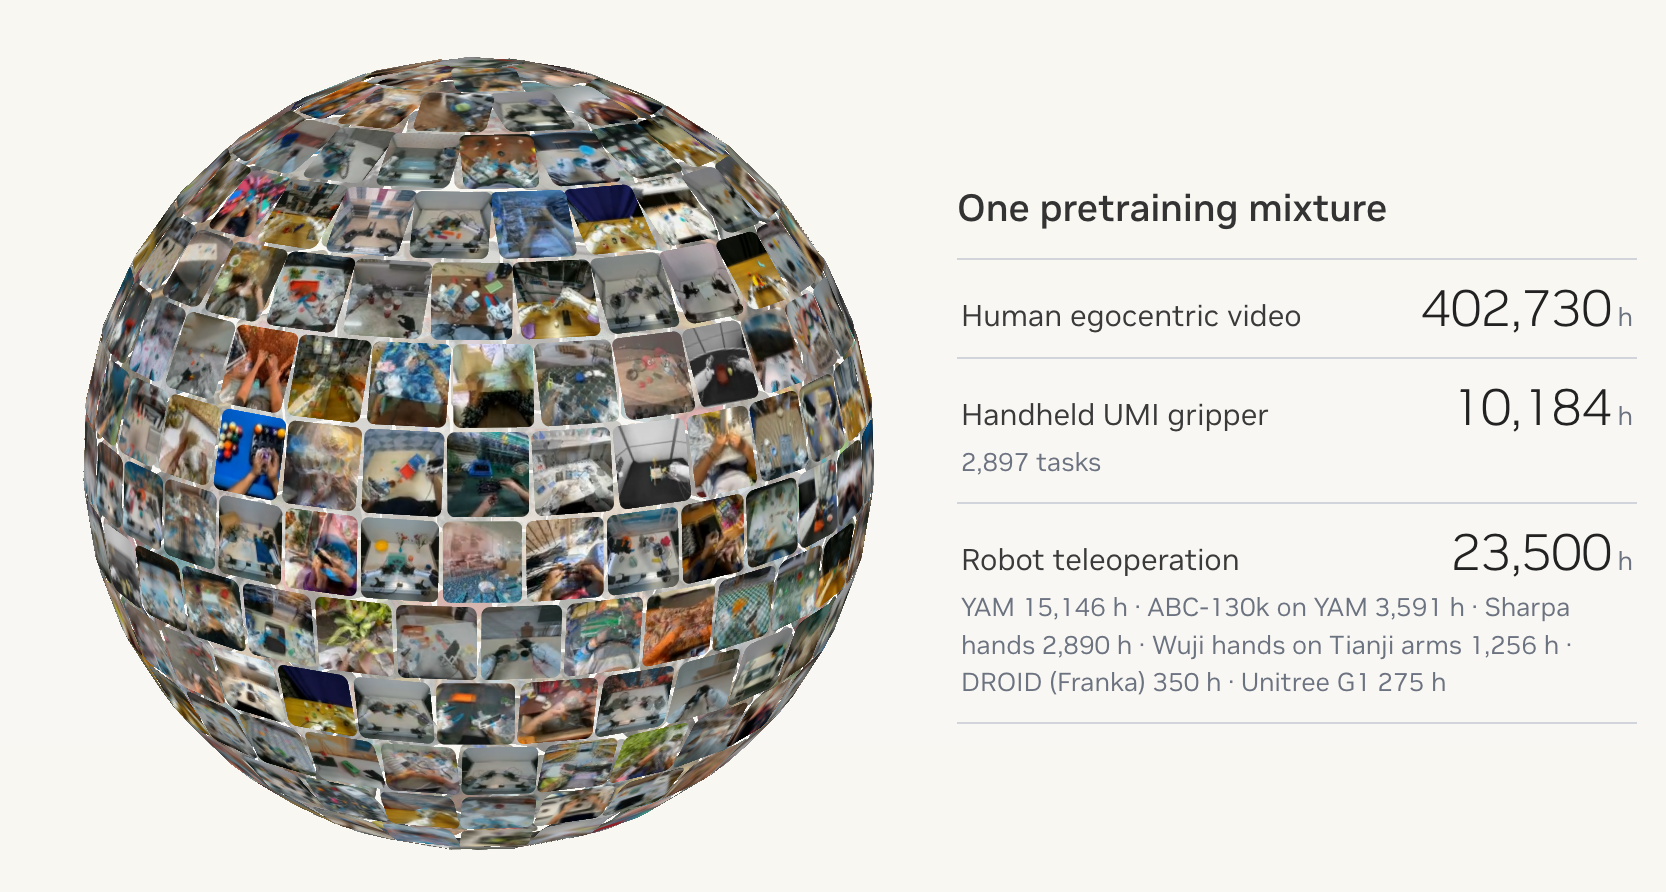
其中,遥操作数据使用的本体涵盖YAM和Franka的平行夹爪机械臂、Sharpa与Wuji灵巧手以及宇树G1人形机器人。人类视频则来自第一人称数据集Human-1M,该数据集包含100万小时人类数据,其中10万小时已以Human-1M-100K的形式在Hugging Face上开源。
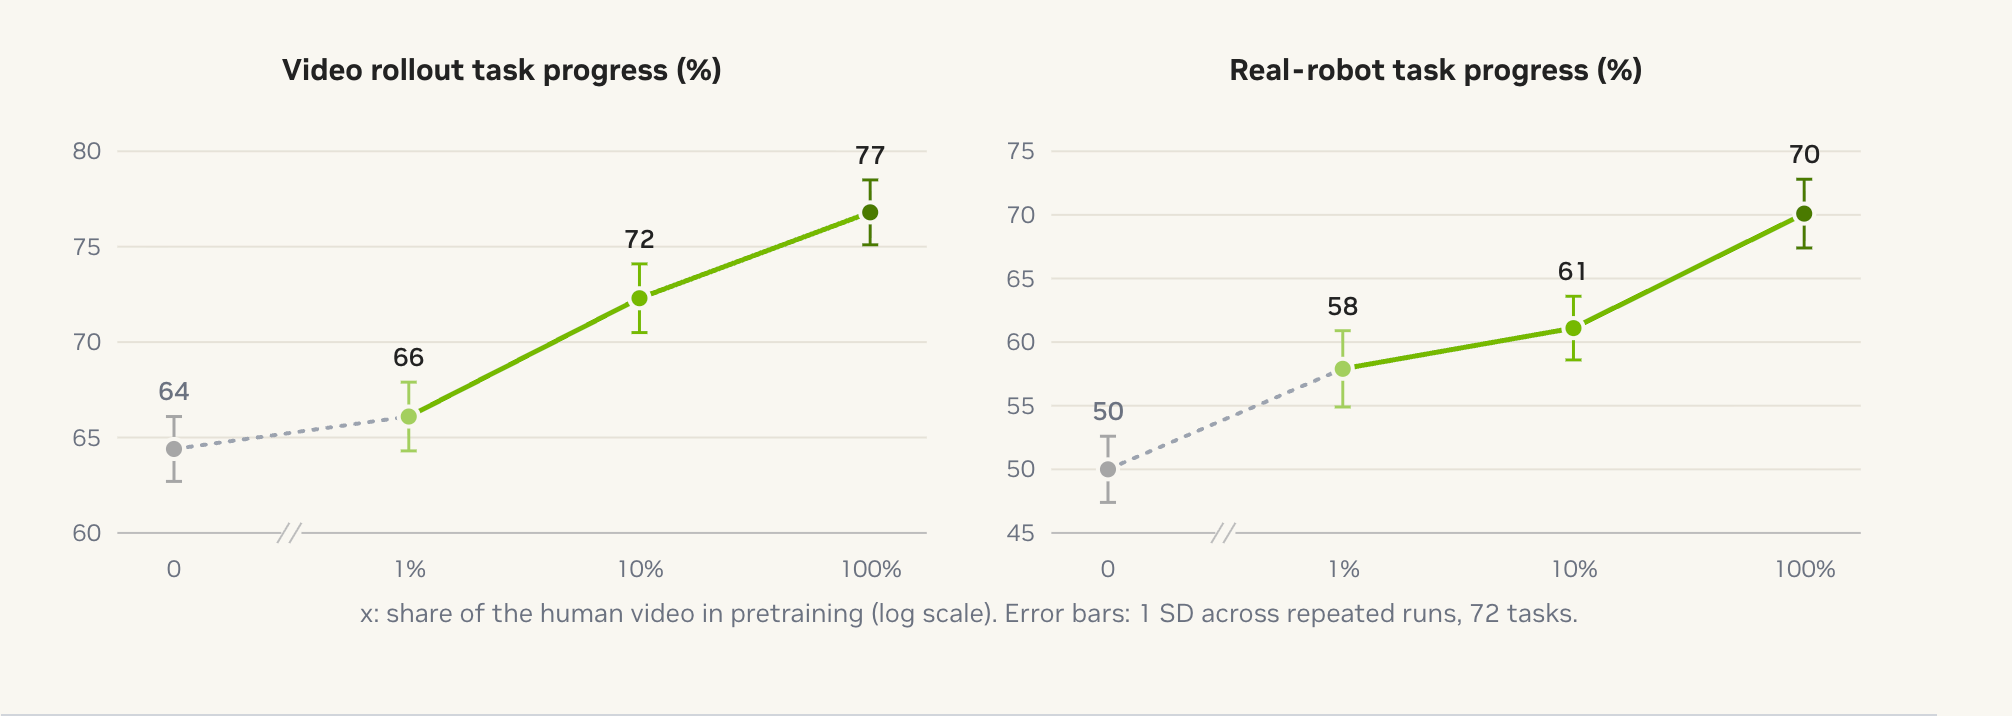
人类视频规模的扩大,也直接反映在了任务表现上。研究团队分别使用0、1%、10%和100%的人类视频预训练模型,并在72项灵巧操作任务上评估。
数据显示,随着人类视频数据比例的提升,视频策略运行的任务完成率由64%提升至77%,实体机器人的任务完成率由50%提升至70%。
GR00T 2的核心,则是一个视频—动作扩散Transformer(Video-Action Diffusion Transformer)。
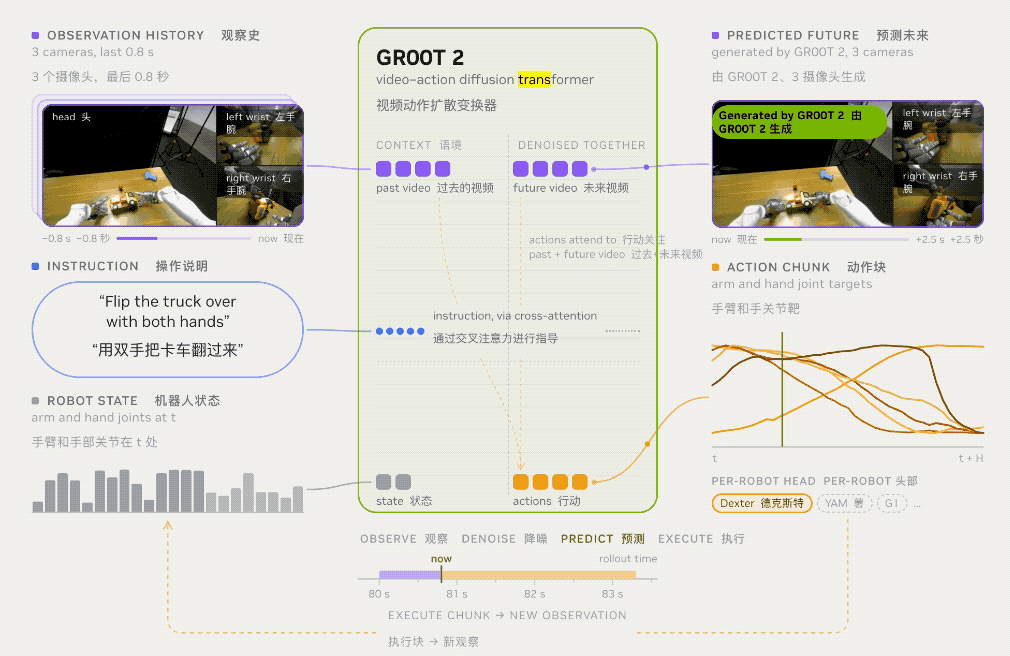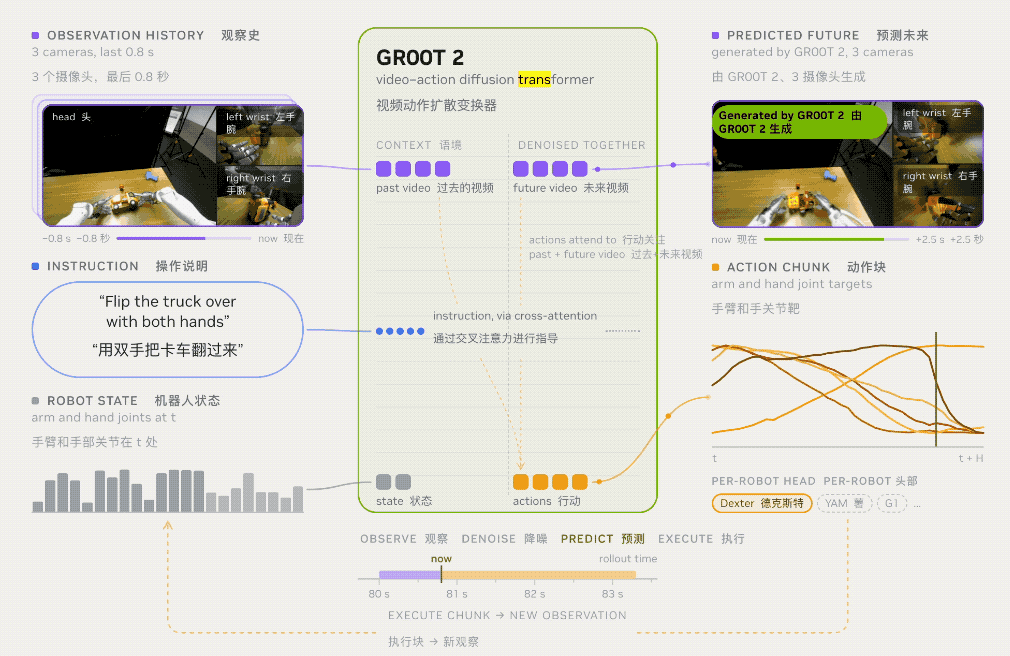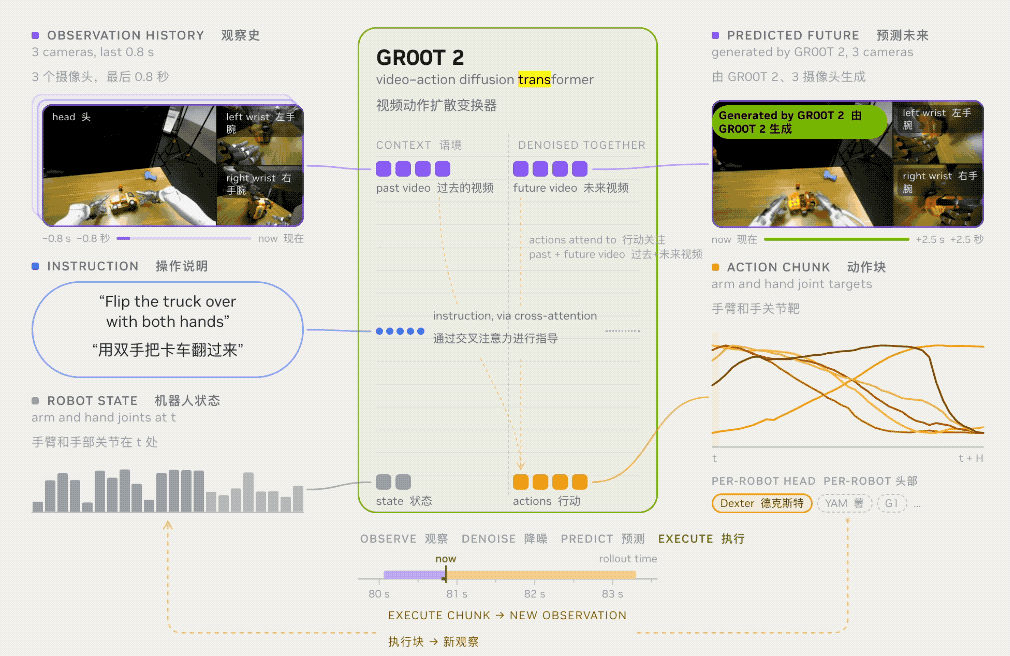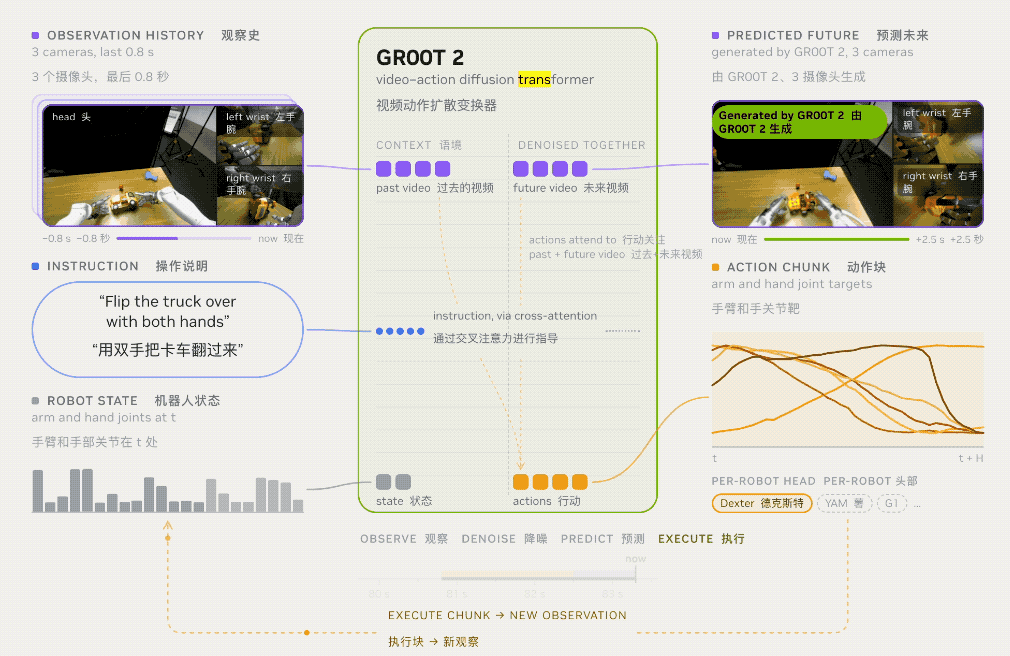
模型读取近期视频、任务指令和机器人状态,对未来视频与一段动作块进行联合去噪,然后执行这段动作,再进入下一轮预测。
简单来说,它既会生成接下来可能发生的画面,也会生成实现这一结果所需的机器人动作。
这一过程中,GR00T 2通过预测场景应如何变化,从人类视频中学习物理规律,在面向不同机器人本体的小型输出头(small per-robot heads)时,再将规划转换为相应的电机控制指令。
英伟达称,目前,在RoboCasa365、RoboLab、RoboDojo和MolmoSpaces基准测试的所有VLA模型及世界动作模型类别中,GR00T 2均位列前三,并多次登上排行榜榜首。
最后,英伟达还披露了与其他公司合作探索模型能力的情况,中国台湾的机器人公司Nexuni正在测试将GR00T 2用于衣物处理工作,富士康正在将GR00T 2应用于服务器制造的工厂自动化,西门子则正在评估其在各类工业场景中的应用能力。
德国慕尼黑的具身初创公司MicroAGI还使用了经过强化学习后训练(post-trained through reinforcement learning)的GR00T 2,控制YAM机械臂更换以太网线缆。
结语:英伟达,不止想做“卖铲人”
不止于GR00T 2,Jim Fan 在 CoRL 2026 现场宣布,英伟达将推进机器人相关技术的全栈开源:12 月开放 GR00T 2、Turbo 的模型权重及 Cross-Adapt 方法,同时开放真实到仿真流程SimFoundry、可持续积累技能的智能体框架 ASPIRE、数据整理与标注工具Flora,以及Human-1M首批10万小时训练数据,甚至还包括UMI、DexUMI等设备的完整硬件设计图纸。
也就是说,英伟达在具身领域开源覆盖的不只是模型,还包括数据、仿真、智能体框架和硬件设计。再加上 RTX 5090、Jetson Thor 等计算平台,这家公司正在把机器人研发所需的软件工具与硬件基础设施串联起来,覆盖从数据采集、模型训练到仿真评估和真机部署的多个环节。
由此来看,英伟达并不只想销售芯片做一个“卖铲人”,他们更希望通过软硬件的协同,降低机器人开发的门槛,加快机器人技术从实验室走向真实场景的应用,形成产业飞轮。这种角色,显然比一个“卖铲人”更能获得市场的青睐。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”