作业帮语音团队成果入选Interspeech2026,让AI语音合成推理提速3.25倍



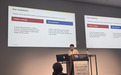
2026年9月26日至10月2日,全球语音领域顶级学术会议Interspeech 2026在澳大利亚悉尼举行。作业帮语音团队论文《Enhancing Flow Matching with A Unified Guidance Framework for Efficient and Robust Speech Synthesis 基于统一引导框架增强Flow Matching,实现高效且稳健的语音合成》入选大会口头报告(Oral Presentation)。本届大会共录用论文1341篇,仅少数优秀成果入选现场宣讲。同期团队另一项成果《Poly-InstructTTS: Learning In-the-Wild Expressive Speech Synthesis from Open-Ended Instructions 基于开放式指令学习复杂场景下具有表现力的语音合成》被大会录用并进行海报展示。
作业帮语音团队这项成果回答的是语音合成技术领域的两个“卡脖子”问题:1)生成一段高质量语音耗时久;2)克隆或转换音色时不像目标说话人。如何才能让AI语音“又快又像”,作业帮语音团队研发出以“数据引导 + 增强模型引导”为核心的统一引导框架,推理提速3.25倍——3步推理生成即可接近传统10步推理生成的音质。目前该成果已在相关教育业务中落地,支撑口语跟读即时反馈、数字人实时答疑等场景。
作业帮统一引导框架,解决语音合成领域的“卡脖子”难题
语音合成领域里一直有个绕不开的矛盾:在流匹配模型上,想要达到理想的语音生成效果,往往推理步数多、耗时久;一旦强行压缩步数,生成的语音质量就会大幅下降。
还有一个更隐蔽的问题,称之为“音色泄漏”。在训练过程中,模型容易走捷径——从语义特征里残留的声学线索中提取说话人信息,忽略指定的目标音色条件,从而导致在音色转换任务上,生成的语音不符合目标音色,或介于原音色和目标音色之间。这个问题很早就被业界报告,现有解决方案一直不达预期。作业帮语音团队的解法分为两步:数据引导解决“像不像”;增强模型引导解决“快不快”。
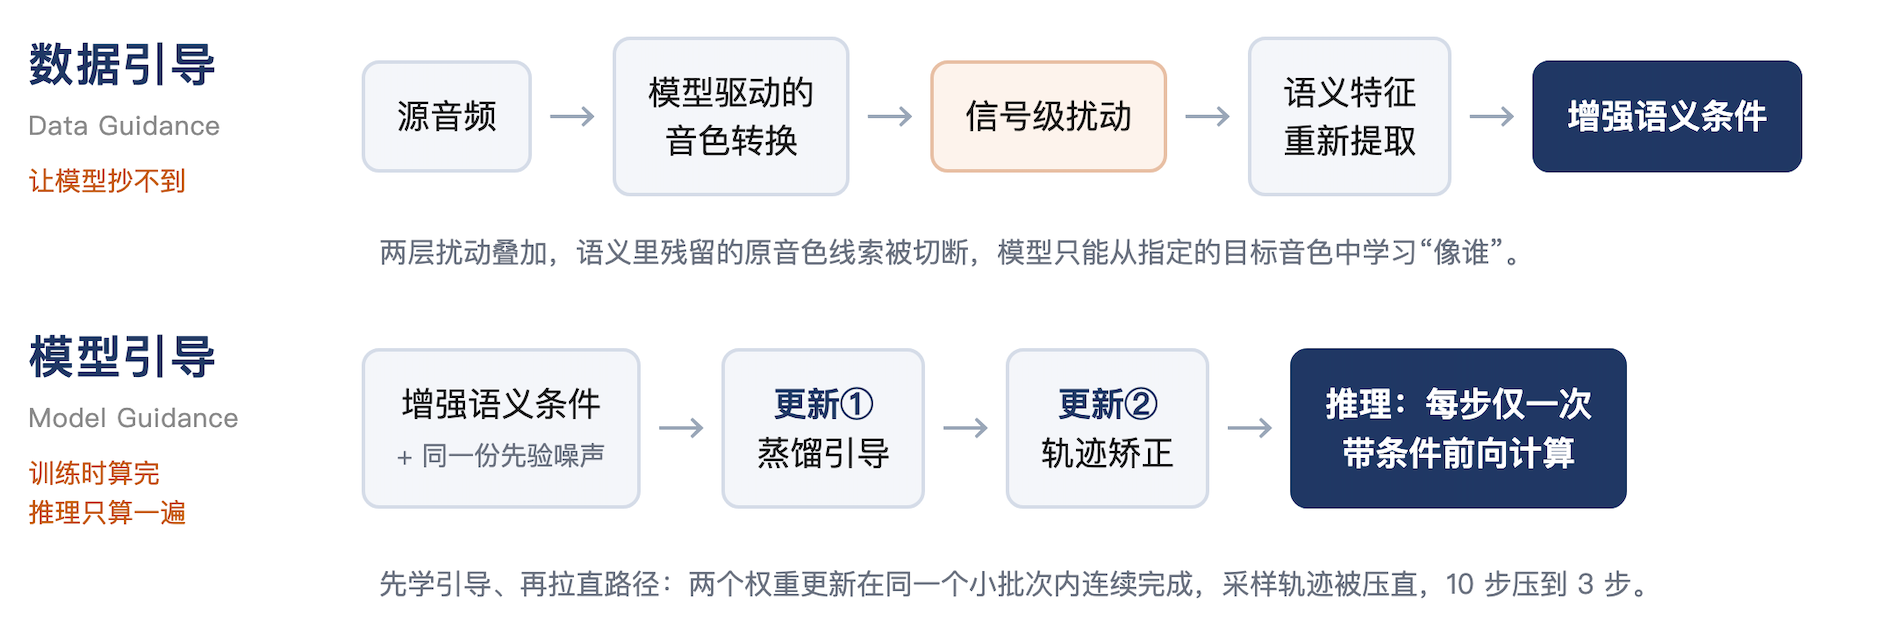
图注:统一引导框架:数据引导与增强模型引导的协同
数据引导:让模型“抄”不到
数据引导先解决“像不像”的问题。在训练AI模型时,需要把声音拆成两类特征:一类是内容信息,即“说了什么”;另一类是音色/声学信息,比如“谁在说、音色如何”。拆分的前提是两类特征界限清晰。但现实恰恰相反——同一段语音里,内容和音色容易混在一起,内容特征往往并不“干净”,或多或少包含一些声学信息,AI模型就学会了“偷懒”,既然信息里已经藏着足够辨认说话人的线索,它便“走捷径”。结果是合成出的声音往往既不像用于克隆或转换的那个音色,也不符合预期。
作业帮语音团队的方案是:训练之前,先对语音材料动一次“手术”——现有的一种解决思路是在训练前用AI把音频转换成另一种音色,作业帮团队在这条路径上多走了一步:在模型驱动的交叉合成之后,再施加随机化的信号扰动——如扰动音高、能量等特征。经过这样的处理更深度地切断声学捷径,原文里残留的原说话人音色线索几乎被彻底抹掉或者混淆,模型想走捷径也走不了,只能老老实实从指定的目标音色中学习。实验中,团队在3万小时筛选语料上施加上述双重扰动,构建出6万小时训练语料,完成预训练与引导优化两个阶段,从根本上解决了“音色泄露”难题。
增强模型引导:让模型“跑”更快
当前主流的流匹配语音合成需要从一团噪声出发,沿着模型学到的路径一步步走到语音。这里有两笔隐性成本:其一,为了让合成结果可控,行业通用的引导机制要在每一步同时计算两种可能性——一种带条件(听指令),一种不带条件(自由发挥),再把两者按比例混合,代价是每一步计算量更大;其二,业内许多的模型要走至少10 步才能保证合成质量够好——步数减一半,质量掉多少,没人敢保证。
作业帮语音团队的第一步改造对准“每步算两遍”。基于作业帮在 AI 视觉领域的技术积累,语音团队把图像生成领域的先进加速方法移植到语音场景:把“带条件、不带条件混合推理”这个原本发生在推理时的动作,提前到训练时完成,将引导信息直接学习进模型权重。推理时,每一步只需要一次带条件的前向计算,单步计算量随之下降。
第二步是轨迹矫正。团队发现,如果让模型同时学“引导”和“拉直”两件事,会互相拖累;因此在同一个小批次内连续执行两次权重更新——第一次蒸馏引导,第二次用更新后的解码器在线采样、矫正轨迹。先学引导、再拉直路径,矫正目标因此更简单。矫正之后的推理轨迹变得“更直”,原本需要 10 步的采样才能达到的质量在轨迹被矫正后3步就能达到。
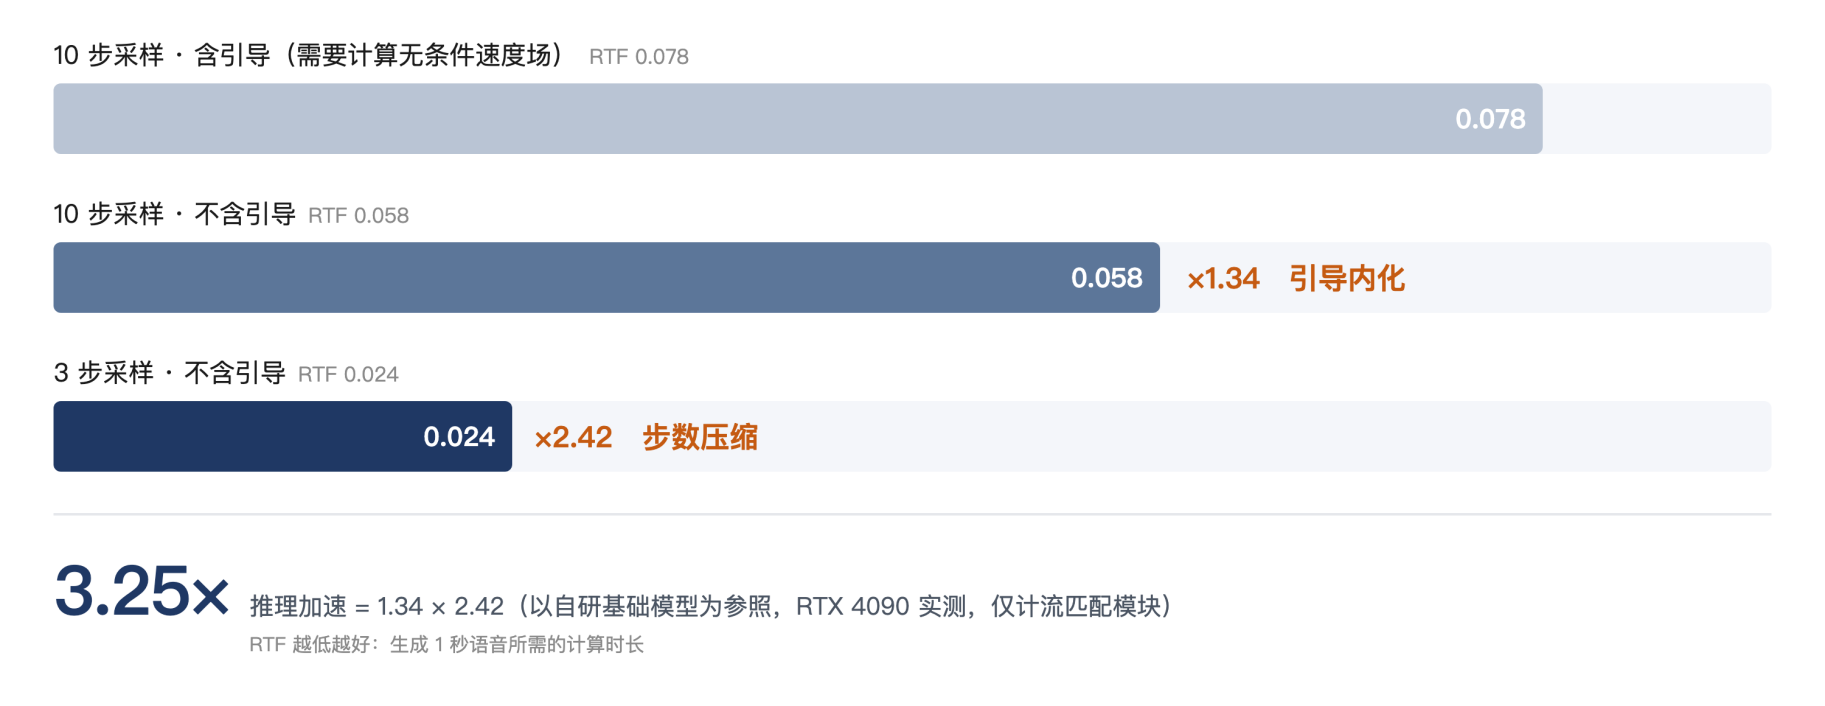
图注:推理提速 3.25 倍的拆解
论文显示,实验结果验证了方案的有效性:在LibriTTS、Seed-TTS两个国际通用评测集上,3步生成的语音质量接近传统10步的水平:以说话人相似度衡量,3步达到0.887与0.808,优于10步基础模型的0.874与0.793;该方案还与业界广泛使用的CosyVoice2后端做了同条件对比,语义输入完全一致时,作业帮后端的说话人相似度为0.888与0.806,高于CosyVoice2后端的0.847与0.750。对于推理成本敏感的实时语音场景,统一引导架构的价值不言而喻。
然而,提速并非没有代价:以词错误率衡量语音可懂程度,团队在论文中给出了答案:3步比10步增加0.03至0.23个百分点的可懂度代价,在实时场景里,延迟和成本是硬性约束,而千分之几的转写差异用户几乎无感。
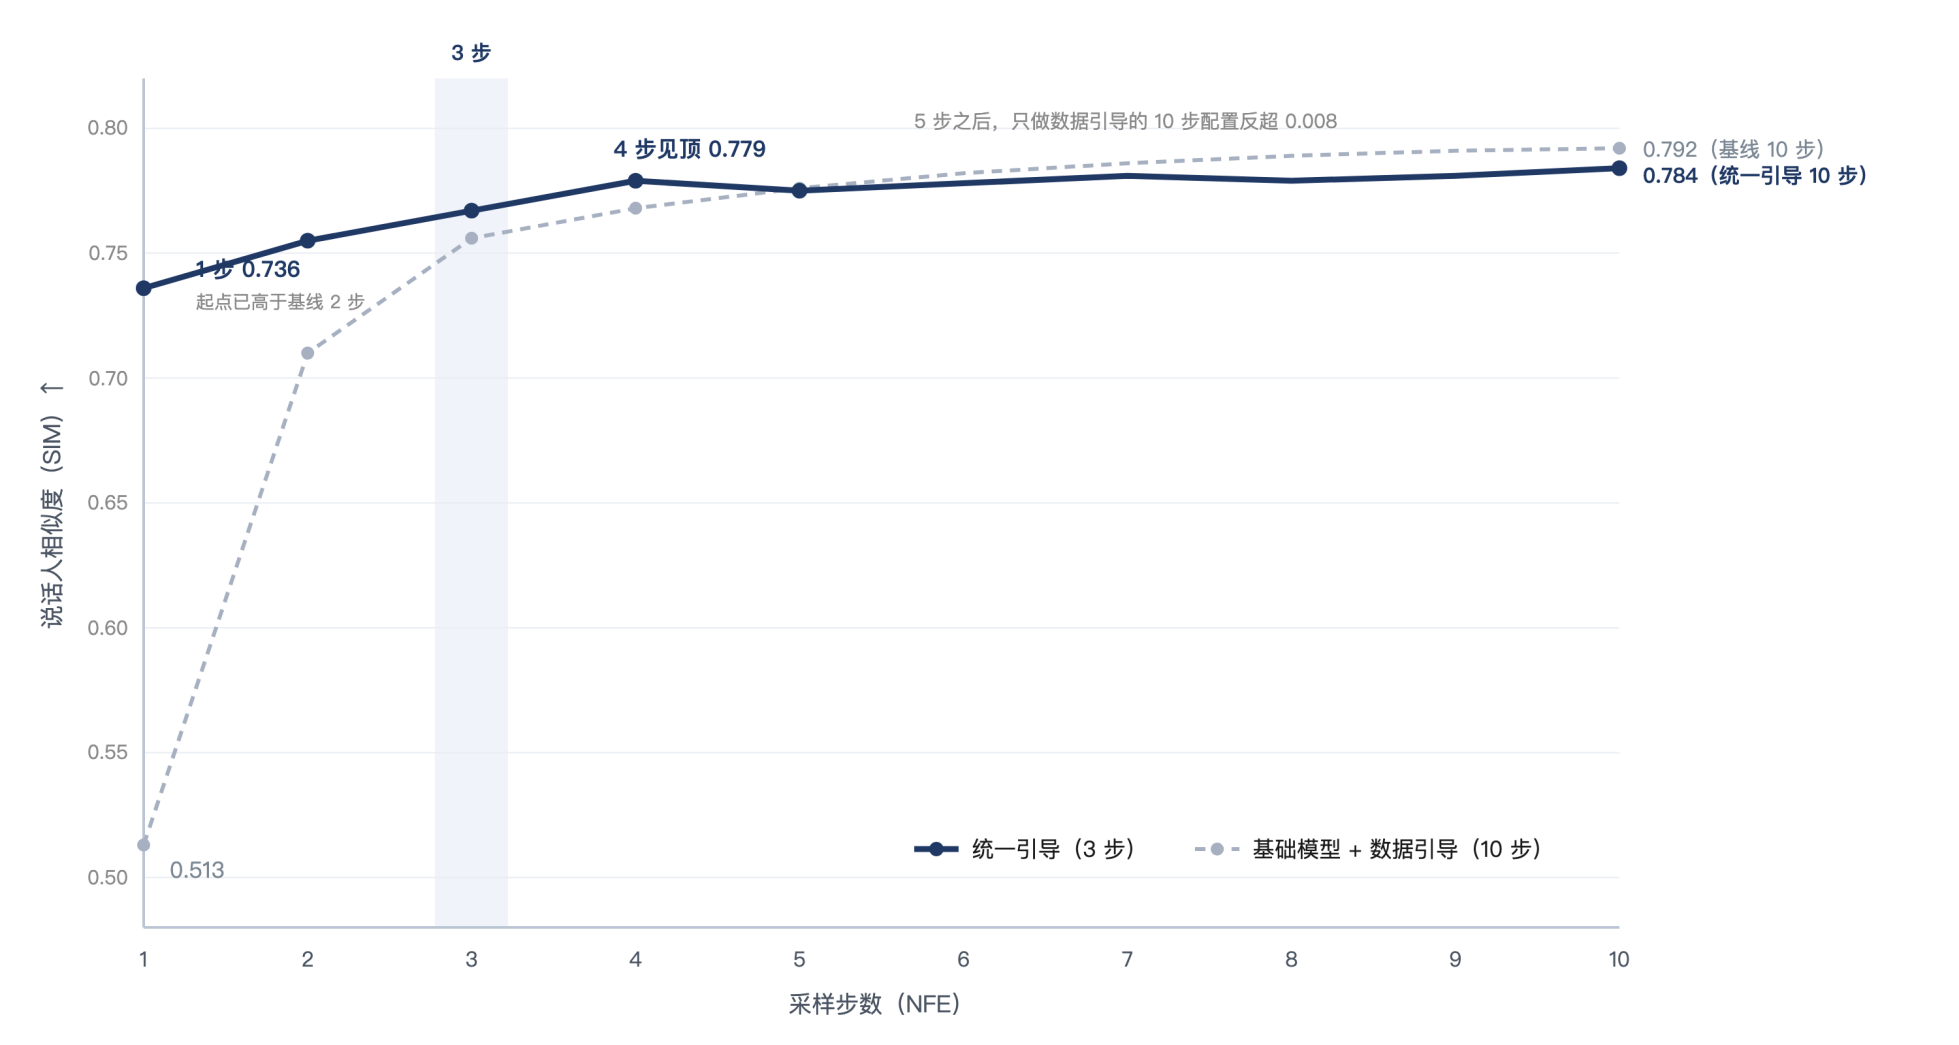
图注:说话人相似度随采样步数变化(Seed-TTS 非平行语音转换)
语音是教育产品最自然的交互入口。落到产品侧,数据更直接:教育场景下生成1秒语音仅需约0.024秒计算,单张消费级显卡即可支撑实时并发的余量,对于教育产品而言,这意味着语音讲解可以更连贯、AI口语跟读可以即时反馈——让“讲得好”实时发生。
此次获选口头报告,是国际学术界对作业帮自研语音技术工程能力的一次集中检验,相关技术支持在作业帮AI超级老师等业务场景中进行部署。未来,作业帮将持续加大AI核心技术研发投入,把前沿学术成果转化为真实学习场景里“听得清、讲得好、答得快”的学习体验,论文里的每一次提速,正在变成千万学习者屏幕前听得见的进步。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”