作业帮AI语音研究入选Interspeech2026,语音表现力合成跻身全球第一梯队



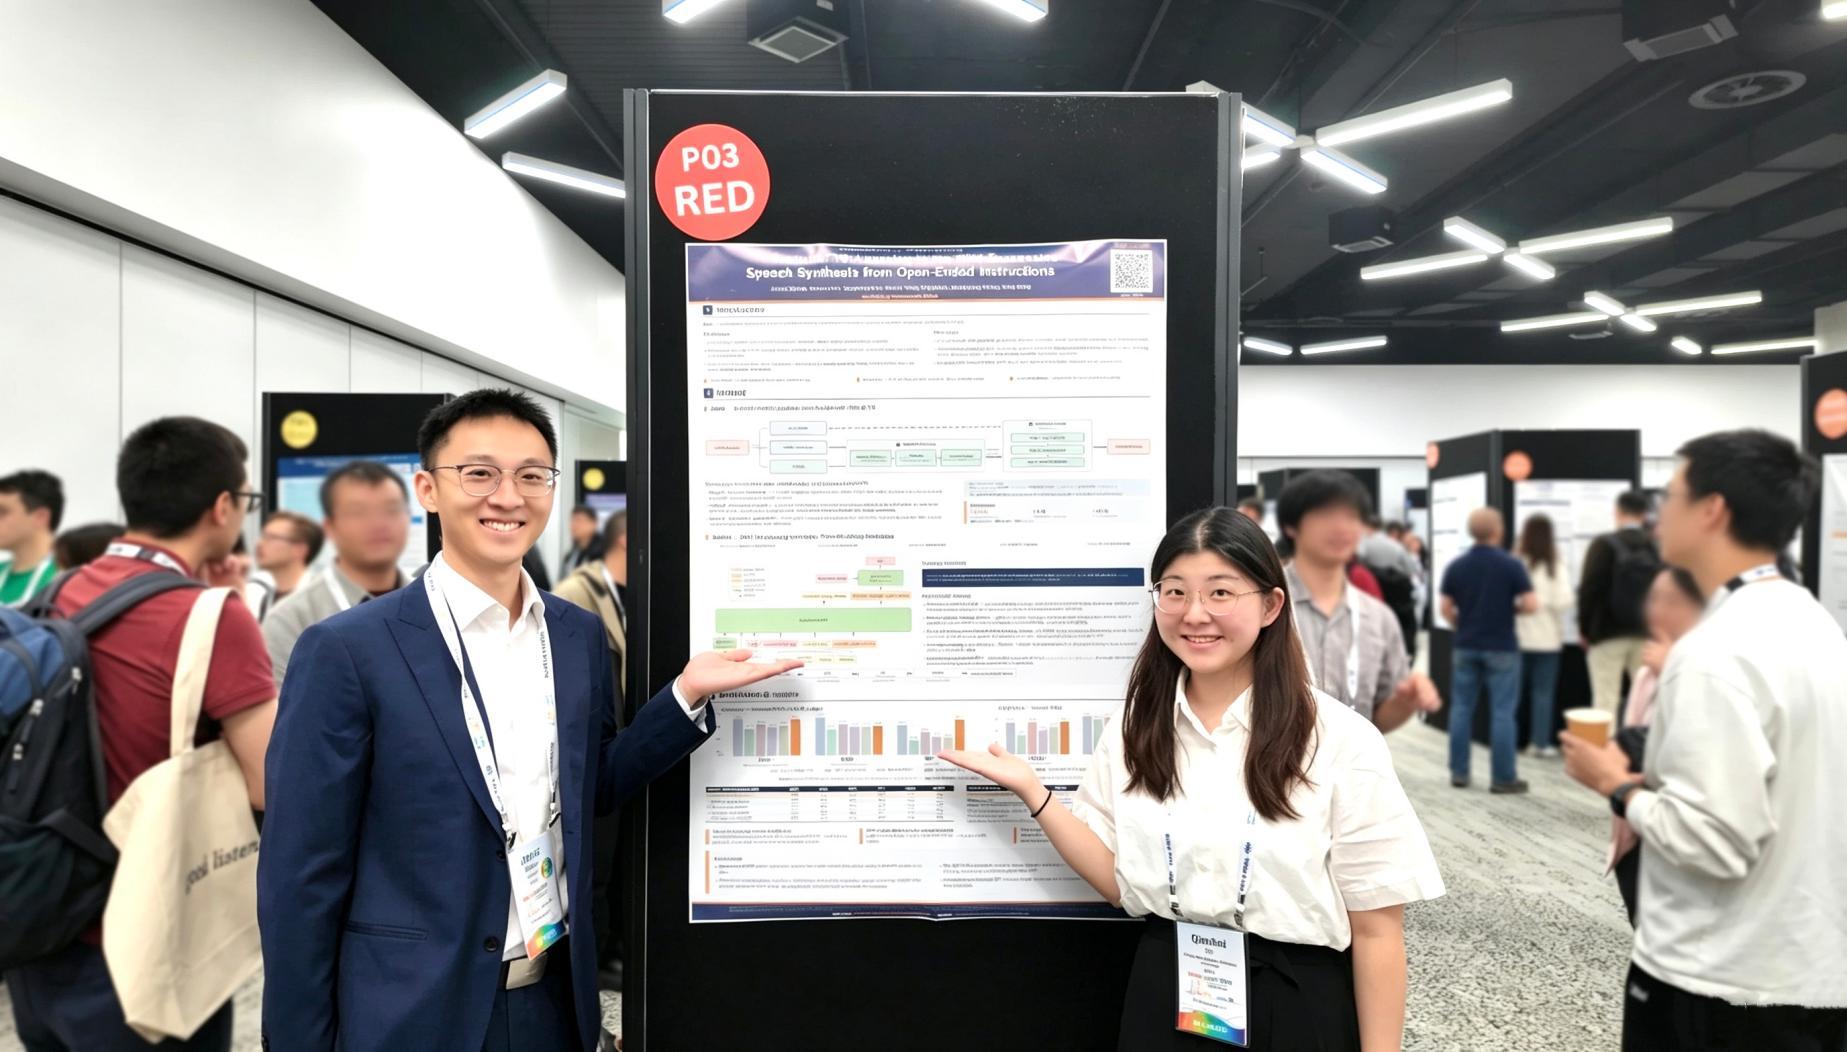
2026年9月26日至10月2日,全球语音领域旗舰学术会议Interspeech 2026在澳大利亚悉尼举行。作业帮语音团队的论文《Poly-InstructTTS: Learning In-the-Wild Expressive Speech Synthesis from Open-Ended Instructions 基于开放式指令学习复杂场景下具有表现力的语音合成》被大会录用,并以海报形式展示(Poster Presentation)。该研究推动AI语音从传统的参考音频模仿向自然语言指令驱动转变:用户只需通过一句话描述,即可控制语音的表达风格、口音与情绪强度,无需提供参考音频,相关方案在行业主流评测中跻身全球第一梯队
同期,团队另一项研究成果《Enhancing Flow Matching with A Unified Guidance Framework for Efficient and Robust Speech Synthesis基于统一引导框架增强Flow Matching,实现高效且稳健的语音合成》成功入选大会口头报告(Oral Presentation),展现了团队在语音生成领域的持续探索与技术积累。
让AI语音“有情绪”,到底难在哪
近年来,语音合成技术在清晰度与自然度方面已达到较高水平,但表现力仍是行业亟待突破的难题。其主要面临三方面挑战:参考音频与指令之间的风格冲突、精细化描述语料的稀缺,以及用户指令本身的开放性。
首先,主流零样本语音合成通常需要输入一段参考音频,供模型学习目标音色与说话风格。然而,参考音频在提供音色信息的同时,也可能对生成风格产生干扰。当用户期望的表达方式与参考音频不一致时,模型往往难以兼顾两者,导致生成结果既无法准确还原参考音频的风格,也难以满足指令要求。
其次,现有语音数据在表现力维度上仍存在明显不足。开放语料库中的语音大多以中性、平稳的朗读为主,情绪和风格表达相对单一;已有标注数据集则通常只覆盖“愤怒”“高兴”等少量粗粒度情感类别,难以刻画“语速柔和、带着笑意,像在鼓励一个刚刚泄气的孩子”这类细腻、具体的表达需求,因而难以为模型提供充分的细粒度表现力学习信号。
最后,用户指令天然具有开放性,往往通过自然语言描述具体的表达需求,而非按照预设标签选择语音属性。这不仅要求模型具备较强的语言理解与语义泛化能力,也要求训练数据包含足够丰富、多样的自然语言描述,帮助模型建立指令与语音表达之间的关联。
从标签分类到指令跟随:作业帮重建语音数据的组织方式
基于以上难点,作业帮语音团队首先从数据层面突破表现力的瓶颈;与其继续在有限的标签体系里做分类,不如把每一句话都配上一段“该怎么演”的描述。
作业帮语音团队发现,视听场景中的语音素材具有更丰富的情绪表达和更强的表现力,内容也更贴近日常对话语境。然而,这类素材普遍存在音频质量参差不齐、背景音乐干扰、多说话人重叠等问题,若直接用于模型训练,容易引入噪声,影响模型性能,导致其潜在价值未能得到充分释放。针对这一问题,团队构建了一套自动化预处理流程,将原始视频素材转化为高质量的语音生成训练数据,充分挖掘视听场景语音素材的价值。
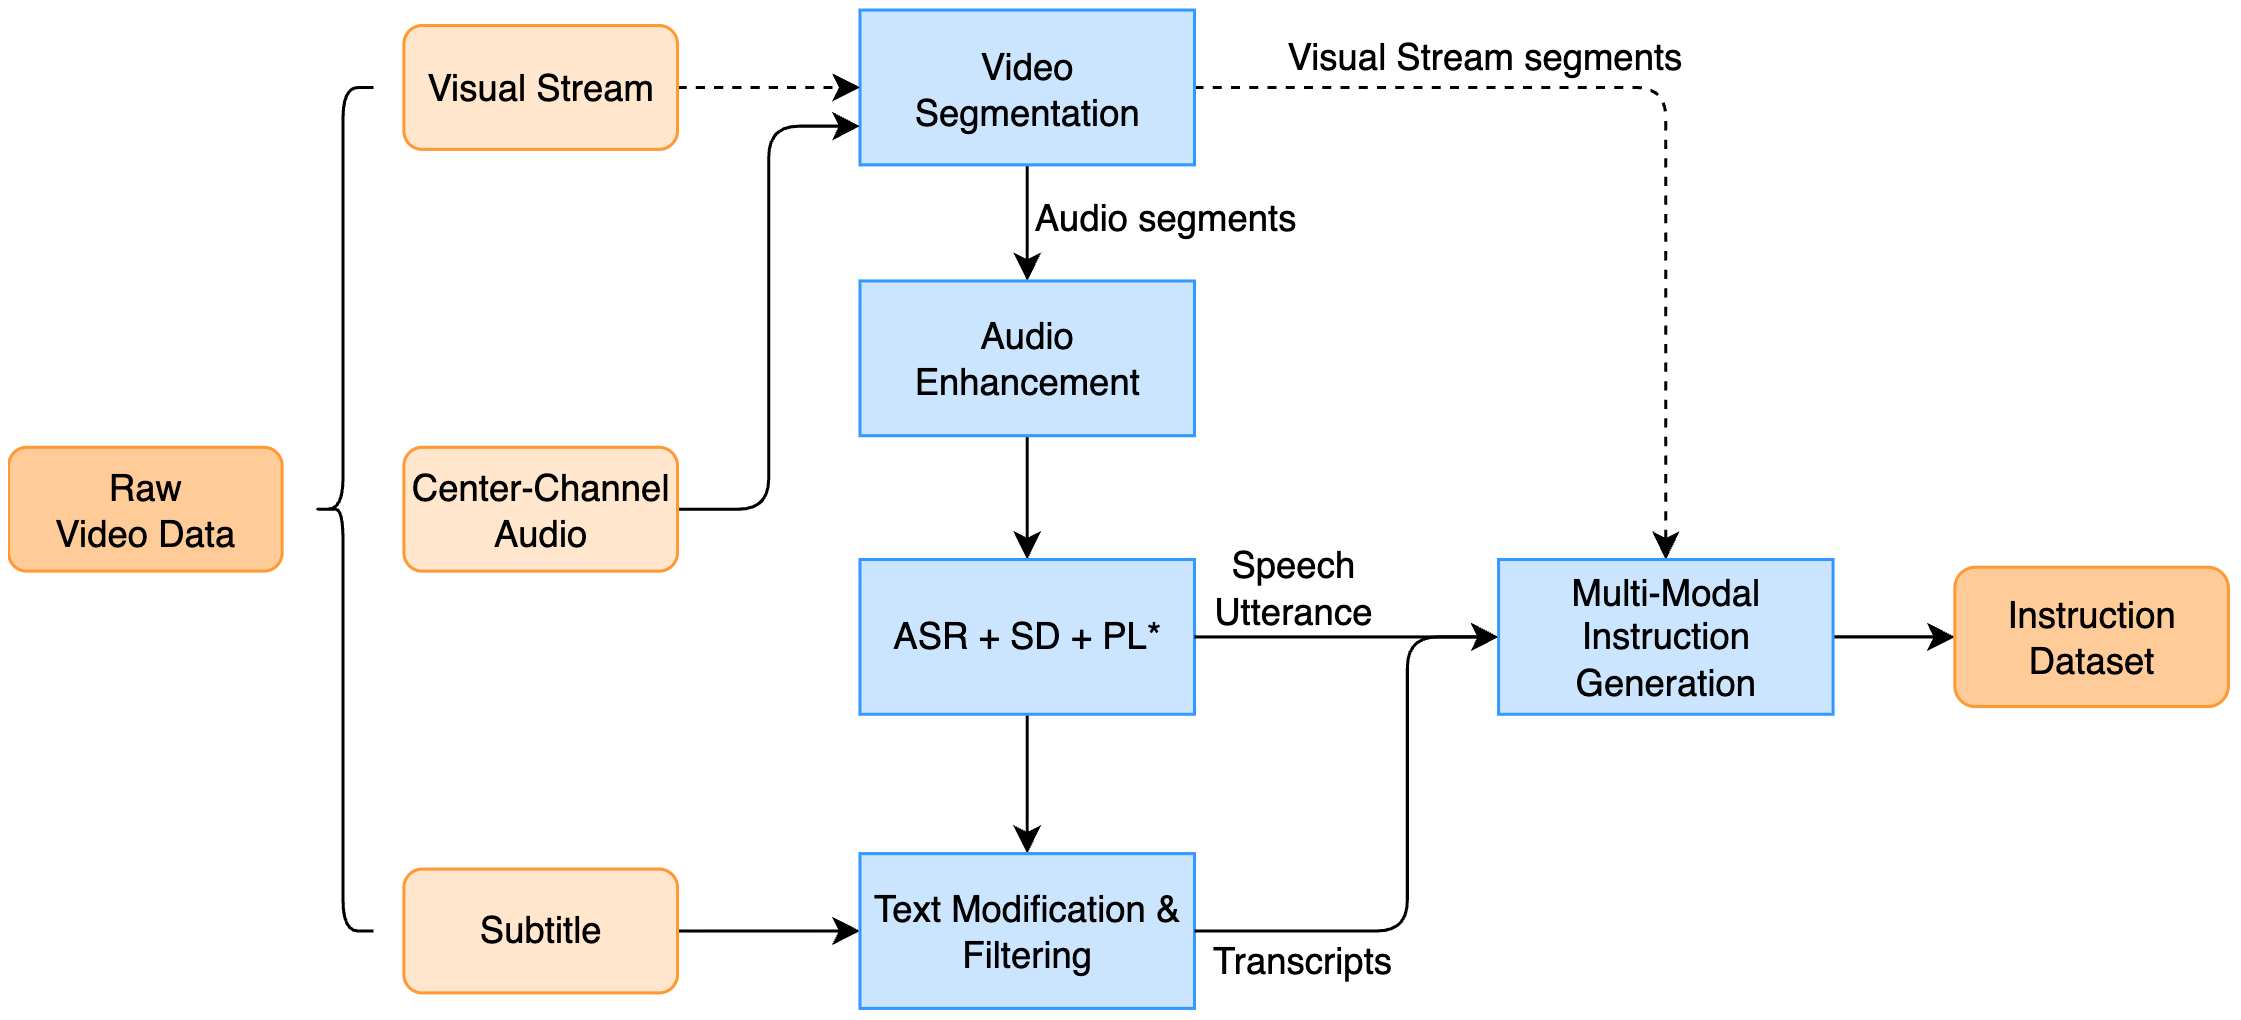
图注:作业帮语音多模态数据处理链路
第一步,对原始素材进行切分与转录。团队通过语音活动检测切分单句音频,结合音源分离与降噪去除背景音乐及环境噪声,再利用语音识别完成转写,并结合说话人分离、副语言特征标注及原始字幕进行交叉校验,确保文本与音频准确对齐。经过处理,最终将原始视听素材转化为干净、准确的句级语音数据。
第二步,团队基于多模态大模型构建了多阶段自动化标注流程。首先,综合视频画面、字幕、对话及环境音效等信息,提取整体叙事结构、人物关系与场景上下文;随后,结合全局摘要、转写文本与视频画面,逐句标注说话人、性别、口音、情绪及强度、DPE等级和说话风格等属性。其中,人物的面部表情与神态为情绪强度判断提供了纯音频分析难以获取的视觉线索。在此基础上,进一步生成段落级场景描述和句级Instruction Description,为不同粒度的语音生成模型训练提供上下文信息与精细化文本监督。
经过层层精炼,最终团队从2500小时视听内容中,筛选1000小时语料,110万条单说话人话语,覆盖800余种情绪、400余种风格、200余种口音,人工校验的匹配一致率超过95%。这批数据的价值不在于“多”,而在于“每条语音都带着一句开放性指令”——它把语音合成从标签分类问题,变成了指令跟随问题,模型学会的是“听懂这句话该怎么演”。
借鉴LLM思考机制 作业帮把关键属性抽象成结构化标记
在获得带有丰富描述标注的语料后,团队进一步重构了语音生成架构,将生成过程拆分为两个相互独立的阶段:第一阶段根据自然语言指令和待合成文本生成语音特征表示,不引入参考音频或目标说话人信息,使模型专注于理解和还原指令中的表达风格;第二阶段通过Flow Matching注入目标音色,并经声码器生成最终语音。这种设计实现了表达风格与说话人音色的解耦,从架构上避免模型依赖参考音频模仿说话方式,使其真正具备根据文本指令控制语音表达的能力,同时保留对目标音色的还原能力。
在模型设计上,团队借鉴了大语言模型的思考机制,将性别、口音、说话风格等关键属性抽象为结构化标记,其余复杂的语音表达特征则保留在自然语言指令中,由模型自主理解。通过这种方式,在增强属性可控性的同时,避免过度拆解语音特征带来的标注复杂度与训练负担。其中,性别标记用于辅助后续音色生成阶段减少音高与音色失配,而情绪和音高等韵律特征则交由模型根据指令自主学习和还原。
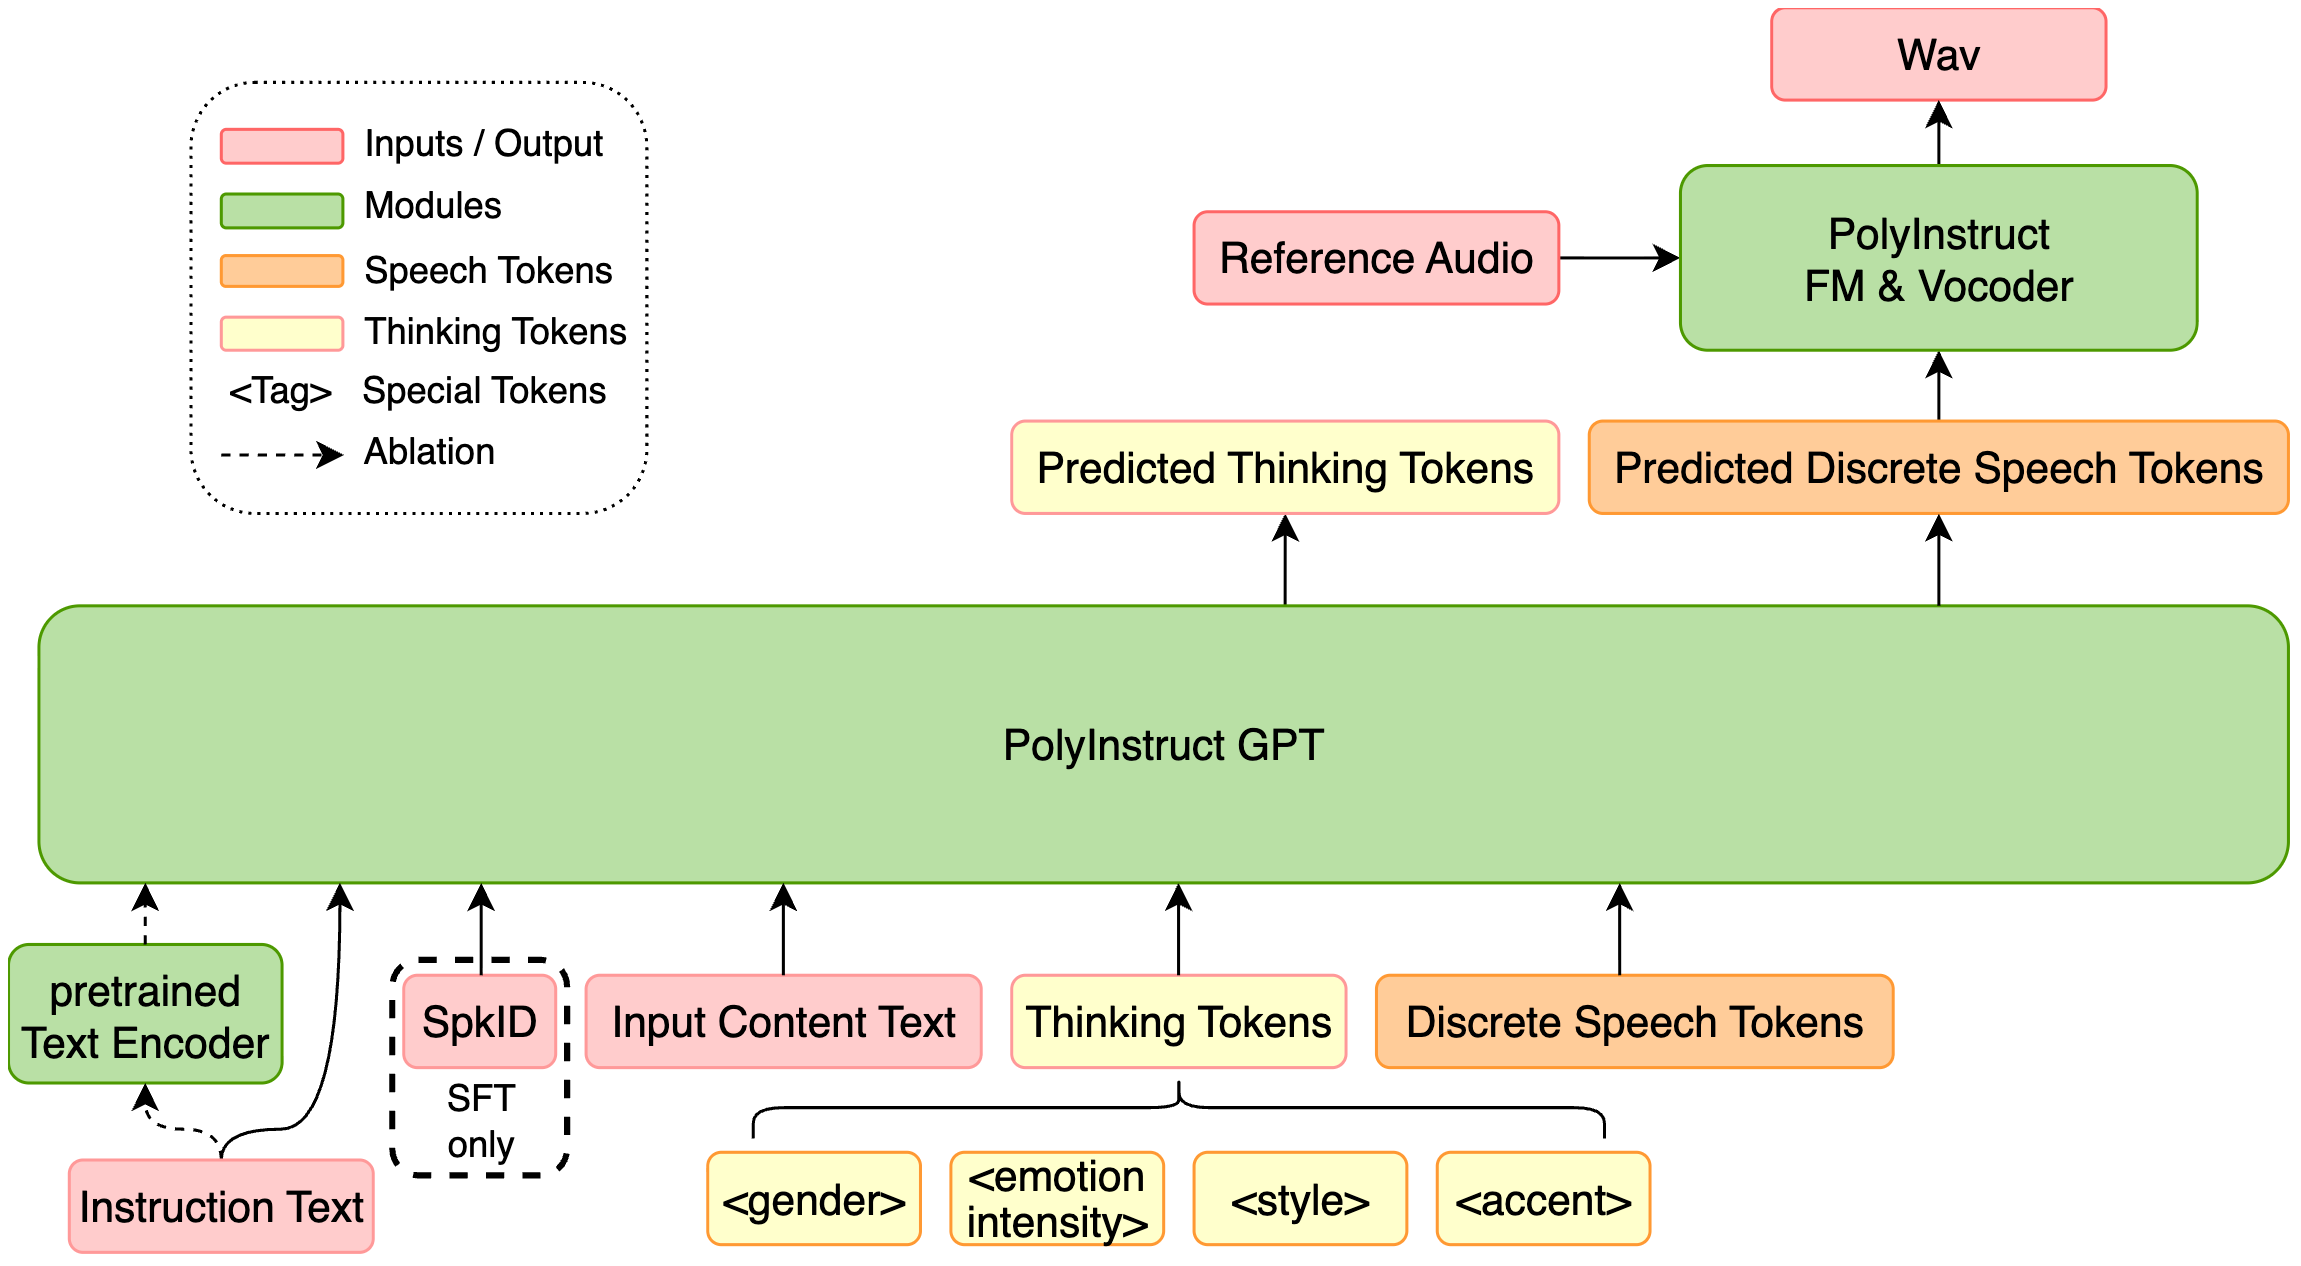
图注:作业帮语音多模态模型架构
与GPT-4o、Gemini同场竞技:多项核心指标跻身全球第一梯队
在面向指令语音合成的公开基准 InstructTTSEval上,作业帮语音团队的方案与11个系统同场评测,各维度表现位列Top1—Top4,展现出较强的指令理解与语音生成能力。参与对比的系统包括Gemini-Flash TTS、GPT-4o-mini TTS、Qwen3-TTS、OV-InstructTTS 和MiMo-Audio-7B等。
此外,针对实际应用中角色音色与指令控制的平衡问题,团队进一步引入说话人标识符进行微调,在保留目标说话人固有音色与个性的同时,增强角色一致性。微调后,角色人设相似度由3.62提升至3.91,自然度由3.76提升至4.02,但指令遵循度主观评分下降0.30,体现了角色一致性与指令可控性之间的权衡。
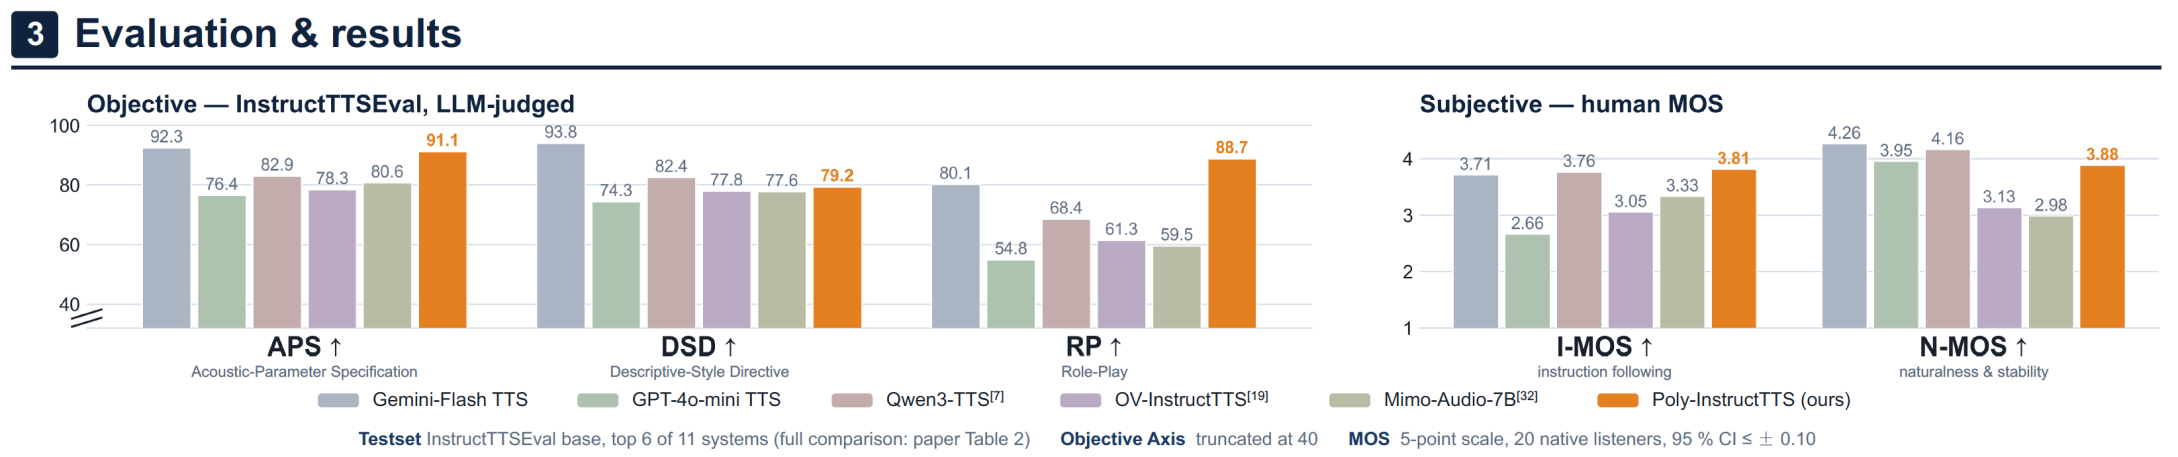
图注:行业主流评测模块与基准对比
除论文成果外,团队还进一步扩展并公开了InstructTTSEval评测集,在第三方原始基准上新增200条样本,覆盖口音、极端情绪、角色特征及即兴对话等场景,并同步开放音频演示页面,支持外部试听与结果核验,为同行开展统一标准下的性能对比与研究复现提供更全面的参考。
回归教育场景,该技术能够支持作业帮AI超级老师根据学习内容和辅导场景灵活调整语音表达,例如讲解难点时放慢语速、突出重点,鼓励学生时采用更加柔和的语气,AI语音不仅能够清晰地传递内容,更能自然地表达情绪与交流方式。作业帮语音团队表示,相关技术已在业务中部署应用,下一代技术研发也在同步推进。未来,团队将持续深耕语音生成领域,向国际顶级学术会议输出研究成果,为用户带来更加自然、更有温度的AI语音体验。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”