联合宇树!中国电信孵化的具身公司,打造了一套人形机器人新考题



机器人前瞻(公众号:robot_pro)
作者 | 刘俐杉
编辑 | 许丽思
机器人前瞻11月9日报道,近日,伽马智能与TeleAI(中国电信人工智能研究院)联合宇树推出LocoManiLab,这是一个面向人形机器人移动操作的统一测评框架。
该测评框架的特点在于,将策略模型和全身控制器拆解成两个层面,并放在同一标准中进行综合测评,相当于又测大脑,又测全身控制器。
这套框架覆盖五类家庭空间、13个场景实例和234项任务,其中包括102项原子任务与132项组合任务,并以宇树G1人形机器人和Dex3灵巧手作为统一测试本体。研究人员可以在相同的任务和机器人配置下,比较不同策略的表现,也能进一步分析控制器对机器人执行效果的影响。
研究团队对12个策略模型进行测评后,结果显示,现有模型在换到新任务和场景后,成功率普遍下降,XR-1在见过任务上的平均成功率达到80.2%,到了未见任务下降至25.2%,在未见场景中进一步降至8.2%。
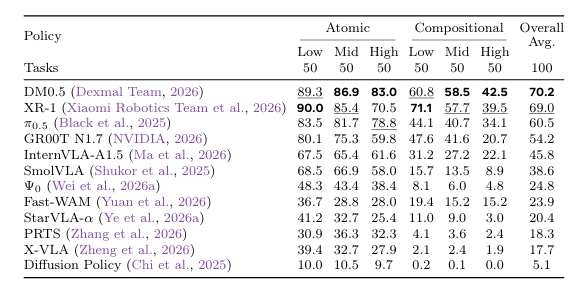
域随机化测试中,在较低强度的视觉扰动下,XR-1在原子任务和组合任务中都取得领先表现,但DM0.5在中、高强度扰动下,表现更稳定,均取得更高的成功率。在原子任务较高强度的扰动下,π0.5的平均成功率也反超XR-1的70.5%。
一、打造统一测试环境,覆盖厨房、客厅等多个家庭场景
移动操作不是简单地把机器人移动和抓取能力拼在一起。
以打开冰箱为例,机器人需要先走到冰箱前,调整身体位置,再伸手抓住把手并拉开冰箱门。冰箱门的状态改变后,机器人下一步抓取的位置也会随之变化。
整个过程中,双腿移动、身体平衡和手臂操作需要相互配合,机器人面对的并不是一串互不相关的动作。
LocoManiLab首先从任务和场景入手,为人形机器人建立了一套覆盖多种日常操作的测试环境。
该框架覆盖五类家庭空间,包含13个场景实例,涵盖厨房、客厅、卧室、浴室和办公室。其中包括两个从真实场景构建的仿真场景。
其中,102项原子任务用于测试机器人的单项技能,包括走近、开门、抓取和放置等基本能力。
另外还有132项组合任务,它们则把多个动作连成更长的任务链,考察机器人能否在移动和操作之间持续衔接。
在数据方面,LocoManiLab支持通过VR遥操作采集仿真环境和真实机器人的全身动作示范,还可以利用运动合成和轨迹增强扩充训练数据。
该平台采集了14160段仿真遥操作数据,累计时长为51.5小时,此外,还采集了约9小时的真实机器人遥操作数据。
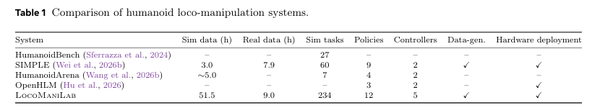
▲人形机器人运动操控系统的比较
每段示范都会记录机器人第一人称视角下的图像、语言指令、动作指令和实测状态,为后续策略训练提供数据基础。
在此基础上,LocoManiLab集成了12种策略模型,涵盖视觉-语言-动作模型(VLA)、世界动作模型(WAM)和模仿学习基线模型。
这些模型根据图像、语言指令和机器人状态生成动作,再由全身控制器负责执行。
为观察相同动作意图经过不同身体执行方式后会产生什么差异,在控制器评测中,两个代表性VLA策略分别接入五套全身控制器,分别是SONIC、AMO、HEFT、ALMI和ScaleBFM。
平台通过数据适配器连接策略模型和控制器,并统一指令执行流程,控制频率为50Hz。
在硬件方面,LocoManiLab采用宇树G1人形机器人,配备两只Dex3-1灵巧手。整套系统包含29个身体关节和14个手部控制目标,可以在同一机器人本体上完成移动、伸手和物体操作。
评测还区分了训练分布内、分布外的场景和任务,并加入不同强度的视觉扰动。
二、分层考察策略模型和全身控制器性能
有了统一的任务、数据和机器人本体,LocoManiLab进一步将评测拆分为策略模型和全身控制器两个层面。
这种拆分很重要。只比较策略,可以回答谁更擅长理解任务和安排动作;把控制器也纳入比较,才能进一步回答相同的动作意图是否能够被不同的身体稳定执行。
首先是策略模型评测。
研究团队将12种策略模型接入同一套SONIC全身控制器,尽可能统一身体执行条件,重点比较不同模型在任务理解、动作规划和任务完成方面的表现。
▲策略模型评测
测试不仅包括训练过程中见过的任务,还加入了未见过的任务和未见过的场景,考察机器人面对新环境、新任务时的表现。
平台还加入了域随机化测试。研究人员可以改变场景纹理、光照和相机条件,也可以增加干扰物,观察视觉环境发生变化后,机器人能否继续完成任务。
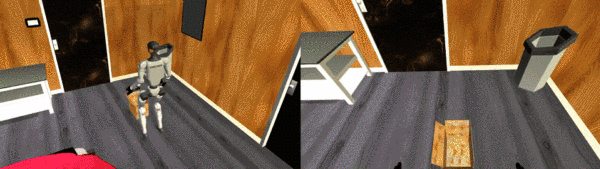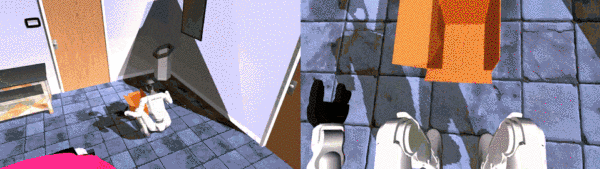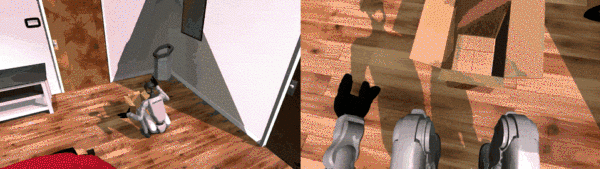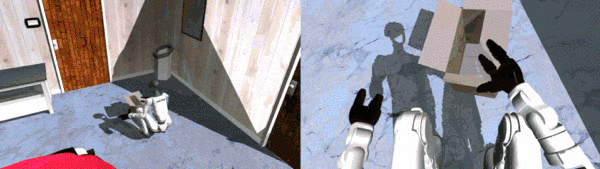
▲LocomaniLab的域随机化示例
其次是全身控制器评测。
研究团队选取GR00T N1.7和π0.5两种VLA策略,分别接入5种全身控制器,在5项原子任务和5项组合任务的浴室场景上进行测试。
这一部分不仅统计任务成功率,还记录机械输出功率、足部打滑、跌倒率、身体关节目标变化率和相对完成时间。
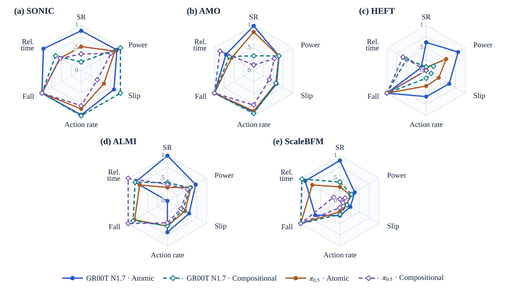
▲两种上层策略搭配五种全身控制器的多指标雷达图
这些指标可以从不同角度反映机器人的执行质量。例如,机器人即使完成了任务,也可能出现动作不稳定、足部打滑或者机械功率消耗较高等问题。
因此,单看任务成功率还不够。只有同时观察任务结果和身体运动状态,才能更全面地了解机器人距离实际应用还有多远。
三、对比12个策略模型,陌生场景成功率普遍下降
在12个策略模型的主实验中,研究团队使用SONIC作为共同的全身控制器,对不同模型在见过任务、未见任务和未见场景中的表现进行比较。
测试结果显示,现有模型在熟悉任务上的表现相对较好,但换到新的任务和场景后,成功率普遍下降。
以XR-1为例,它在见过任务上的平均成功率达到80.2%,到了未见任务下降至25.2%,在未见场景中进一步降至8.2%。
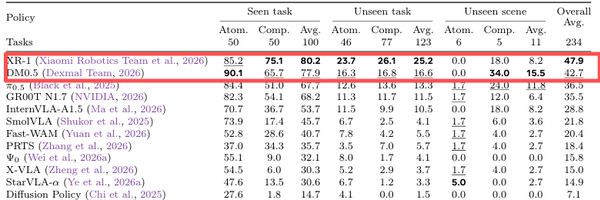
▲测试结果
而不同策略的优势也会随测试条件发生变化。XR-1在见过任务和未见任务上表现领先,而DM0.5在未见场景中的成功率最高,达到15.5%。
域随机化测试也呈现出类似的变化。
在较低强度的视觉扰动下,XR-1在原子任务和组合任务中都取得领先表现,其成功率分别为90.0%和71.1%。
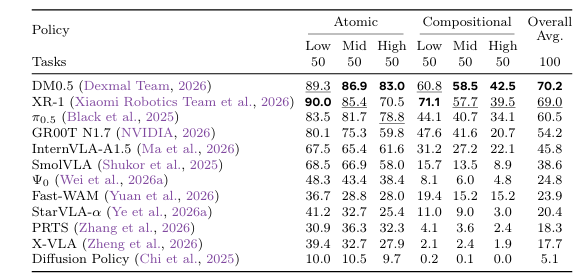
▲域随机化测试结果
但随着扰动增强,DM0.5的表现更加稳定,在中、高强度扰动下均取得更高的成功率。
在原子任务上,π0.5 的降幅也小于XR-1,并在较高强度的扰动下,以78.8%的平均成功率反超XR-1的70.5%。
因此,模型在一种测试条件下表现最好,并不代表它在所有环境中都能保持优势。这些组合预设,用于考察策略在场景外观、光照和相机条件同时变化时,能否依然保持较高的任务成功率。
全身控制器的测试则进一步说明,任务成功率不能完全代表机器人身体的执行质量。
在GR00T N1.7的原子任务测试中,ALMI取得了最高成功率,但在其成功的回合中,跌倒次数比 SONIC更多。
SONIC在两种策略、两类任务的成功执行过程中,机械输出功率最低,但在部分对比中,其他控制器的任务成功率更高。
这些结果表明,仅凭任务完成度不足以选择执行控制器。因为成功率相近的配置,可能在功耗、稳定性和动作质量上存在差异。
最后,研究团队还将仿真测试与真实机器人测试联系起来,进一步在宇树G1上设计与仿真相近的真实任务,用于观察仿真中的相对表现能否在真机中得到呼应。
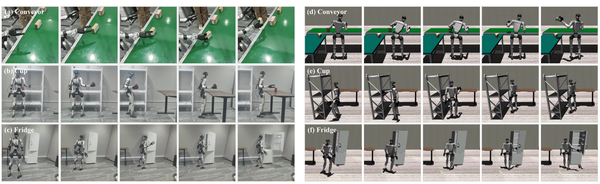
▲三项真机任务及其对应仿真执行片段
研究团队在宇树G1上设置了三项任务,分别是打开冰箱、将物品从货架搬运到桌面,以及处理传送带上的箱子,并在仿真环境中设置对应任务。
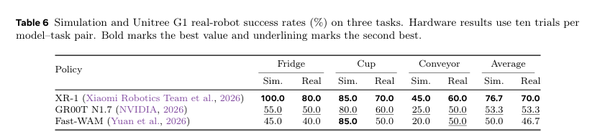
▲三项匹配任务的平均成功率
如上图显示,XR-1在仿真和真机中的表现均排名第一,GR00T N1.7排名第二,Fast-WAM排名第三。
结语:建立了统一评测平台,但覆盖范围与部署条件仍有局限
随着具身领域的飞速发展,行业对机器人能力的要求不再局限于能做出动作,更关注其能否在不同条件下稳定完成一件事。
LocoManiLab为人形机器人移动操作提供了一个统一的测试平台,它将家庭任务、遥操作和生成的演示数据、策略训练,以及仿真与真机评估连接在一起。
实验不仅考察了策略的泛化能力和控制器性能,还探究了数据规模与微调的影响。
但这套测评框架仍然存在覆盖范围和部署条件的局限性。
目前的评测主要局限于室内家庭和办公任务,且真机硬件研究仅涉及三种策略,任务也仅限于开冰箱、搬运杯子和处理传送带箱子,且每种策略的每个任务只进行了10次测试。
未来,测评框架不仅要覆盖更多模型、活动和环境,还需要增加测试的重复次数和真机验证规模,才能真正验证这些测试结论的准确性。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”