英伟达重磅发布VFlash,Jim Fan直呼新时代来了!机器人动作解码提速12倍



机器人前瞻(公众号:robot_pro)
作者 | 刘俐杉
编辑 | 许丽思
机器人前瞻11月6日报道,今天凌晨,英伟达发布了VFlash,这是一种面向快速、精准视觉规划的通用解码框架。该框架通过并行解码完整的视觉基元,能够加快机器人和自动驾驶系统的推理速度。
VFlash的核心思路是,不再让模型逐个生成坐标,而是利用点、边界框和轨迹等视觉信息本身的几何结构,让一个轻量级模型一次并行预测完整的空间信息。
也就是说,原本需要逐个生成的多个轨迹航点,现在可以作为一个整体进行预测,该解码框架可以让模型更快地生成机器人抓取位置、运动轨迹等空间规划信息。
这套框架不仅能够处理机器人轨迹,还能用于物体定位、三维运动预测和自动驾驶规划。
在测试中,初步的单次生成测试表明,在三维点运动预测任务中,VFlash的生成速度约提升了25倍。
在四组MolmoSpaces任务套件中,以VFlash视觉规划为条件的世界动作模型,平均任务成功率达到70.2%,而基线模型为62.6%。
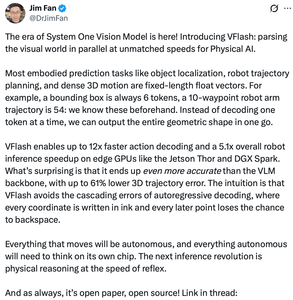
VFlash发布后,Jim Fan在X上转发并评论称,“System1视觉模型”的时代已经到来!下一场推理革命,是以反射速度进行的物理推理。
同时,Jim Fan还补充到,VFlash 可实现最高12倍动作解码加速、5.1倍整体机器人推理加速,而VFlash甚至比VLM主干更准确,3D轨迹误差最多降低 61%。且避免了自回归解码的级联误差(cascading errors)。
▲Jim Fan评论
一、打破逐Token生成限制,让模型一次输出完整轨迹
VFlash首先改变的是模型生成视觉信息的方式。
传统自回归解码采用逐Token生成的方式。模型生成一个坐标后,再根据前面的内容预测下一个坐标,直到完成整条轨迹。
这种方式适合文本生成,却不一定适合机器人。因为机器人需要的视觉信息具有明确的几何结构。
机器人不能只知道“拿起杯子”这条口令,还需要明确杯子在哪里、应该从哪个位置抓、沿着什么路线移动、抓取过程中,下一步应该到达哪里,这些信息都需要转化为具体的空间坐标和运动轨迹。
例如,模型需要生成一条包含10个航点的三维轨迹。每个航点都包含空间坐标。把这些坐标连起来,才能形成一条完整的运动路线。
而VFlash通过一套系统化的并行解码设计,支持物理AI所需的多种输出形式。
研究团队提出了Flash Primitive Decoding(闪速原语解码)。
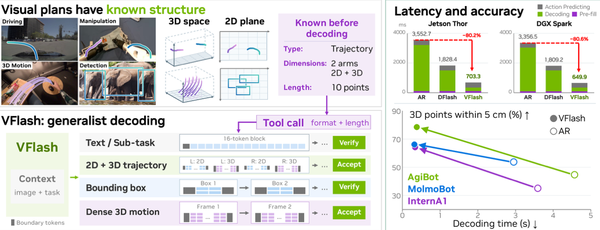
▲VFlash技术架构
具体来说,它将一个完整的几何对象作为一个解码块,在生成前,系统通过工具调用声明输出长度,再根据视觉基元类型决定坐标的排列方式。
随后,在冻结的VLM上下文条件下,轻量级草稿模型通过一次并行计算,预测完整的视觉基元。
预测结果再经过目标VLM处理,更新自身上下文,并提取供下游动作模型使用的特征。
研究团队发现,在这个过程中有三个关键点:边界对齐、位置对齐以及需要在几何结构中学习。
1、边界对齐
训练草稿模型和实际解码时,分块边界要对齐一个完整视觉基元的边界。这样,草稿模型学到的是完整几何,而不是被固定token窗口切碎的片段。
VFlash引入了一种结构化工具调用,用于声明基元的长度,视觉基元的类型决定坐标的排列方式。
闪速原语解码会为每个完整基元单独划出一个解码块,草稿模型在冻结的 VLM 特征条件下,能够一次并行预测出整个基元。
2、位置对齐
在开始并行预测前,每个输出位置都需要有明确的含义。
不同坐标值可能占用不同数量的文本Token,从而导致后续位置发生偏移。
为解决这一问题,研究团队使用专用坐标Token或定宽数值字段,确保航点、坐标轴和分隔符始终处于固定位置。
这种统一的排列方式,使模型能够进行并行预测,并对每个位置施加相应约束。
3、从几何结构中学习
模型训练方面,在训练轻量级草稿模型时,目标VLM始终保持冻结状态。
草稿模型包含5层非因果Transformer,并使用经过标注的视觉基元进行Token交叉熵训练。
它能够并行预测完整的视觉基元,不需要与目标模型逐Token保持一致。
对于子任务文本,模型仍采用投机解码,并由目标VLM进行验证。
二、机器人轨迹、物体定位和三维运动预测同步提速
VFlash并不是专门为机器人轨迹预测设计的。
研究团队还将它用于三维机器人轨迹、稠密三维运动预测、物体定位和子任务规划,验证这套解码框架能否适应不同类型的视觉任务。
在机器人轨迹预测方面,VFlash在ShareRobot-Bench和VABench-V上进行了测试。
结果显示,与自回归解码相比,VFlash在全部6项轨迹误差指标上均有所下降。
在3个机器人数据集和3种目标模型配置下,与自回归目标相比,其平均三维位移误差(ADE)降低了42.6%。
在稠密三维运动预测任务中,研究团队使用冻结的MolmoMotion-AR模型进行测试。
与原模型相比,VFlash将DAVIS数据集上的平均位移误差降低了27%,同时在稠密三维运动预测任务中保持了相近的整体质量。
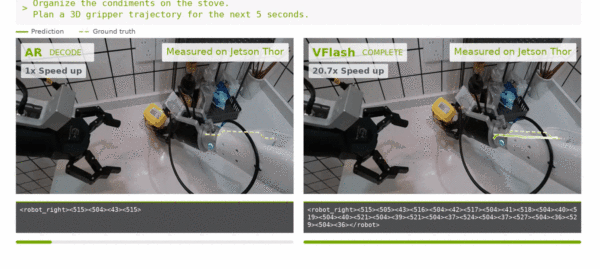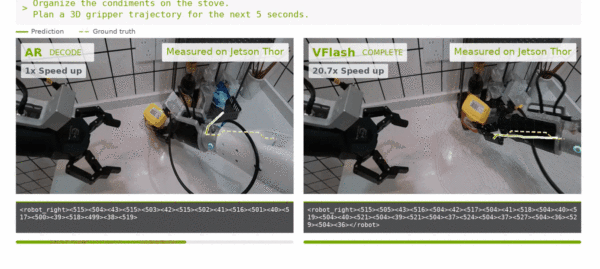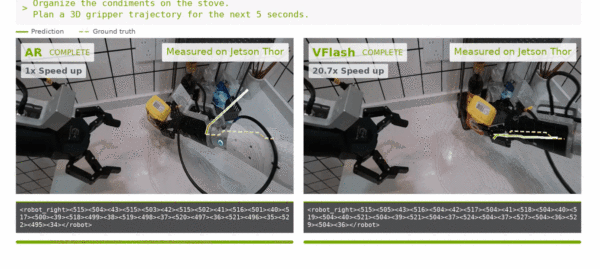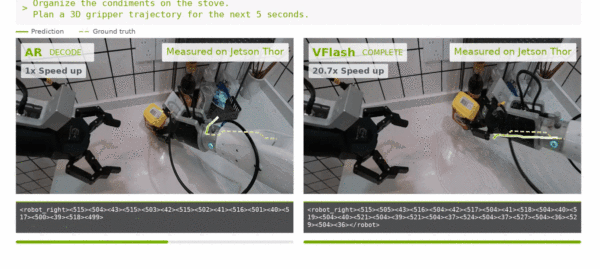
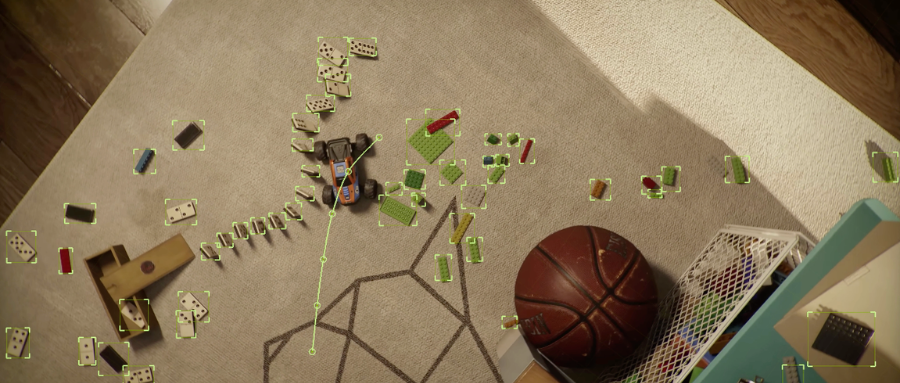
▲预测三维机器人轨迹
在H100 GPU、批量大小为1的条件下,单次生成速度约提升25倍。
VFlash将未来每一帧的查询点,作为一个整体解码块进行预测。
在物体定位任务中,VFlash则展现了更高的边界框生成效率。
在COCO和Dense200数据集上,它每秒能够预测的边界框数量,达到自回归目标模型的2.6至2.8倍,平均F1分数则与目标模型接近。
具体来看,闪速原语解码能够在一次并行预测中生成一个边界框的全部坐标。每个解码块负责一个边界框,后续解码块则继续处理其他物体。
对于文本形式的子任务规划,VFlash也保留了投机解码机制,同一个草稿模型也支持对子任务文本进行经过验证的解码。
VFlash将文本划分为长度为16的位置块,其中包含1个已接受的锚定Token和15个候选Token。
目标模型通过一次计算验证整个解码块,并保留其中最长的匹配前缀,再生成自己的下一个Token。
在博客展示的示例中,VFlash与目标模型最终生成了相同的子任务描述。
三、机器人操作成功率达70.2%,端推理速度提升5倍
生成轨迹更快、更准确,并不意味着机器人一定能完成任务。
对于机器人来说,视觉规划还需要进一步转化为实际动作。
下游世界动作模型和扩散动作头的架构有所不同,但它们采用了相同的设计:通过交叉注意力机制,读取编码了生成的视觉规划的VLM特征。
这些特征来自VFlash预测的视觉基元。因此研究团队将其输入目标VLM,再从中提取相应特征,测试它能否改善机器人操作效果。
其中,动作模型分别针对机器人操作或自动驾驶任务进行训练,而VLM始终保持冻结状态。
在其中一组实验中,研究团队让机器人策略采用世界动作模型(WAM)。该模型通过对Cosmos-Predict2.5进行控制任务的后训练得到。
它保留了原有的相机输入和机器人状态输入,并通过已有的交叉注意力通路,接收冻结VLM提供的问题、子任务和轨迹特征。
WAM每次预测一个包含20步动作的动作块,并在完成3个动作块后重新规划。
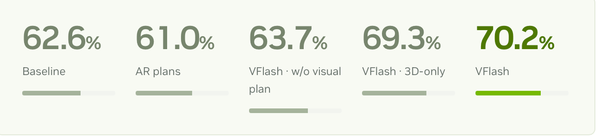
▲测试结果
测试结果显示,使用VFlash视觉规划后,WAM的平均任务成功率达到70.2%,基线模型为62.6%。
研究团队还对不同规划信息进行了对比。
在采用相同WAM架构的情况下,自回归模型生成的二维加三维规划,成功率为61.0%,而VFlash达到70.2%。
如果保留生成的子任务,但用图像特征替代轨迹特征,成功率则降至63.7%。
这表明,视觉几何信息能够在语言信息之外,为机器人操作提供额外价值。
研究团队还在LIBERO系列任务上进行了测试。
在这些实验中,研究团队使用PIv3动作头,通过交叉注意力读取冻结VLM的特征。
基线模型使用Qwen3-VL-4B编码图像和指令。VFlash则通过预测的子任务或完整规划,向模型提供状态信息。
在每次执行包含8步动作的动作块之前,VLM会根据主相机和腕部相机的图像,预测一个子任务,以及一条包含10个航点的二维加三维轨迹。
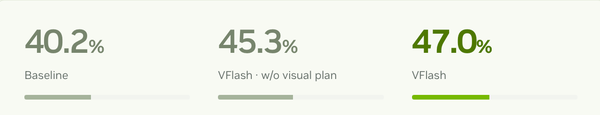
▲LIBERO系列任务测试结果
在LIBERO-PRO上,基线模型的成功率为40.2%;加入生成的子任务后,成功率达到45.3%;使用完整视觉规划后,成功率进一步提高至47.0%。
在LIBERO-Plus上,基线模型的成功率为60.7%;无论使用生成的子任务,还是使用完整视觉规划,成功率均达到62.6%。
在LIBERO上,基线模型和仅使用子任务信息的模型,成功率均为93.4%;使用完整视觉规划后,成功率达到94.2%。
除了机器人操作,VFlash还被用于自动驾驶规划。
在冻结的规划VLM和基于ReCogDrive构建的动作头上,VFlash在NAVSIM和Waymo数据集上取得了具有竞争力的自动驾驶表现,同时降低了解码延迟。
同一套可变长度解码器,也支持Alpamayo使用的轨迹输出。
在硬件上,研究团队使用TensorRT-Edge-LLM运行环境和TensorRT引擎,在Jetson Thor、DGX Spark和H100上进行推理测试。
其中,在Thor平台上,自回归解码占模型阶段实测延迟的75%至87%。
VFlash将这一阶段加速了12至42倍,最终在Jetson Thor和DGX Spark上实现了机器人推理速度提升5倍,NAVSIM自动驾驶推理速度提升超过3倍。
需要注意的是,这些数据是在批量大小为1,每次处理一个请求的条件下测出的。
模型阶段延迟通过CUDA事件测量,其中包括目标模型的特征准备时间。
所有加速比均在相同任务和硬件平台上,对比自回归解码与VFlash得出。
结语:物理AI不仅要看得懂,还要更快生成空间规划
随着视觉语言模型逐渐进入机器人和自动驾驶领域,模型不仅需要理解环境,还要能够以更快的速度将理解结果转化为具体的空间规划。
VFlash的做法是,先从解码环节入手,改变模型生成视觉信息的方式,利用视觉信息本身的几何结构,将原本逐个生成的坐标转变为并行预测的完整视觉基元。
三维机器人轨迹、稠密三维运动预测、子任务规划和机器人操作,以及自动驾驶测试,都可以看出VFlash的应用潜力。
但目前公布的结果主要来自基准任务和测试,它到底能否在复杂真实环境中保持精度和稳定性,还需要继续关注其下一步的部署。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”