


【微信开源 WeVisOne-VL 视觉模型】
让视觉模型在图里找东西,图中根本没有怎么办?微信团队开源的 WeVisOne-VL,可以直接返回 None。
它把检测、定位、计数、读文字、分割和抠图合进了同一个模型,提供 2B、4B 两个版本。团队在训练时逐条核对「图中没有」的样本,也同时训练漏检与误框两类错误,避免模型只学会一味拒绝。
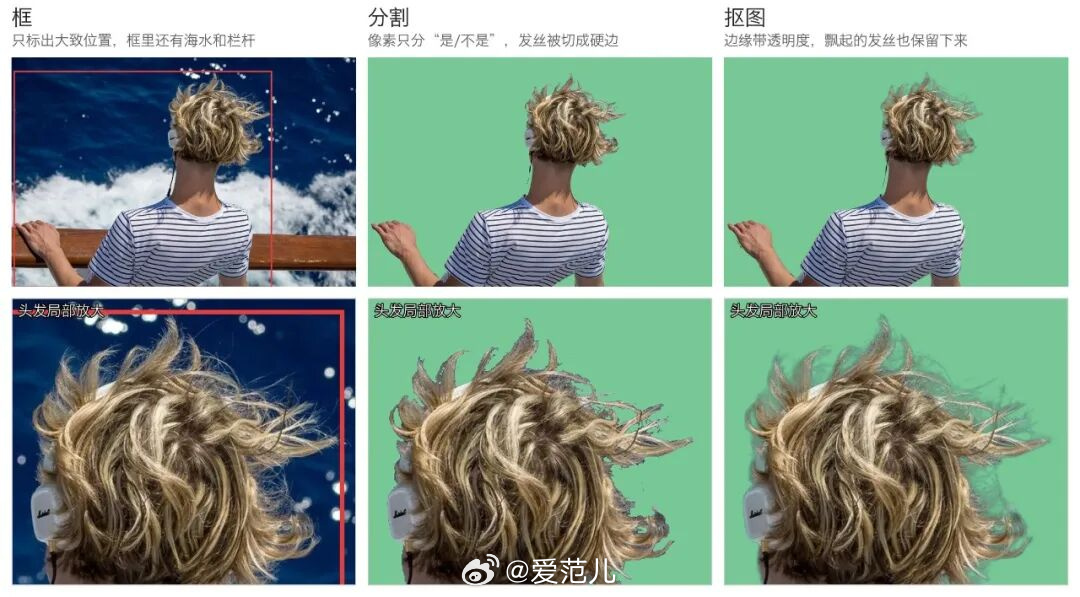
遇到需要抠图的任务,模型里的约 960 万参数像素解码器可以直接输出分割和透明度信息,无需再接一个 SAM。自动标注流程累计处理了超过 1 亿张图、约 36 亿个目标框。
代码、权重、技术报告、教程、评测流程和 Mask2Alpha 抠图标注工具都已公开,采用 Apache 2.0 许可。现在可以在线试用或本地运行,当前版本接受图片输入。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”