深度适配华为昇腾950DT,中科弘云发布训推一体大模型平台HyperLM V2.5
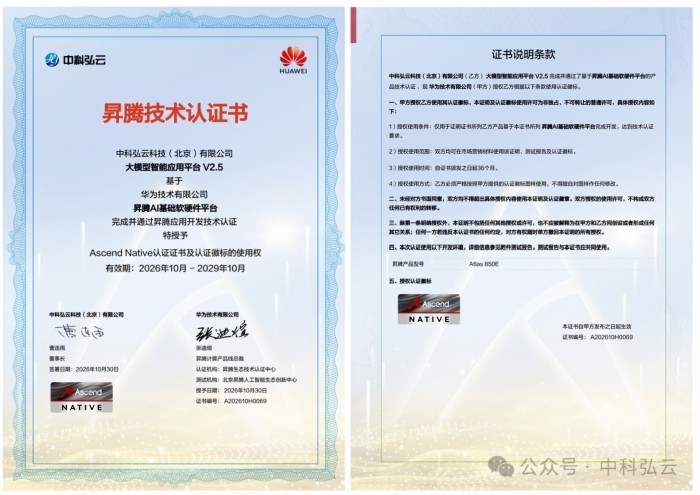
近日,中科弘云正式发布训推一体大模型平台 HyperLM V2.5。新版本率先完成昇腾 950DT 深度适配、全面兼容 Atlas 850E 风冷超节点,并通过华为 Ascend Native 官方昇腾原生技术认证。
"适配"两个字在行业里被用得太松。装得上、跑得通、能出 token,都被叫作适配。HyperLM V2.5 想回答的是另一个问题:高端算力买回来,性能到底能兑现几成。
四道坎:政企自建大模型,卡在"最后一公里"
政企大模型应用已经从小规模试点进入规模化商用的深水区。项目验收的措辞越来越硬:数据不出域、算力可管可控、业务稳定可运营、成本高效可集约。模型能不能跑起来早已不是问题,能不能长期、稳定、划算地跑下去才是。
但真正开工之后,四道坎几乎无人能绕:
·适配慢。 国产新算力迭代快,软件栈跟不上,新一代高端 NPU 的峰值性能只能兑现几成;
·利用低。 私有化集群缺乏精细化调度,高价值加速卡长期空转,并发吞吐上不去;
·运维难。 多模型混部、异构算力并存,资源切不开、任务排不匀、故障定位靠人;
·合规弱。 调用无留痕、权限无隔离、审计无抓手,过不了政务、能源、金融的安全红线。
四道坎指向同一个事实:算力买得到,但让算力跑满的那一层软件,国内长期缺位。HyperLM V2.5 的目标就压在这四点上。
原生适配:不是"能跑",是"跑满"
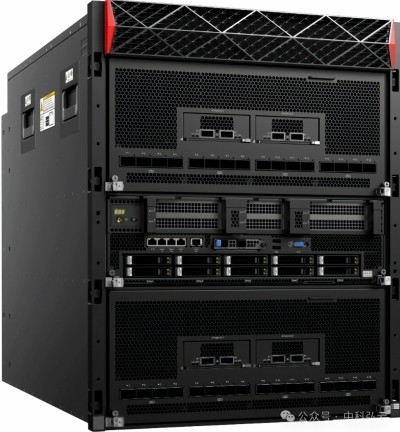
昇腾 950DT 是当前国产推理的旗舰算力,凭借超高带宽与超强互联能力,承担的是政企大规模对话、长文本处理、智能体持续推理这类"吃带宽、吃并发"的核心负载。搭配 Atlas 850E 风冷超节点,无需机房改造、交付周期短、运行稳定,高度契合政企存量数据中心的升级路径——这一点在预算和工期双重约束的现实项目里,往往比峰值参数更关键。
HyperLM V2.5 放弃了行业常见的"表层兼容"做法——只做接口对接、驱动能加载就算适配,性能损耗留给用户承担——转而实现指令级、算子级、调度级的全栈原生适配:
·互联层:深度适配灵衢 2.0 高速互联协议,释放整机 13.4 TB/s 互联带宽,长上下文与 PD 分离场景下的跨卡通信不再成为瓶颈;
·算子层:针对 mxFP4 高精度推理架构专项优化,充分激活单节点 14.2 PFLOPS 算力潜力;
·模型层:全面兼容 Qwen、GLM、DeepSeek 等主流开源大模型最新版本,新模型发布后可快速完成适配上线;
·调度层:基于 950DT 的显存与带宽特性重构资源调度策略,让新硬件的算力与带宽同步跑满,而不是"卡在显存墙外"。
四层改造叠加的结果,是新算力从"可用"走向"可交付":客户拿到的不是一块峰值参数漂亮的加速卡,而是一个能撑住业务高峰的大模型服务实例。
五项能力:把私有化部署的效率瓶颈逐项拆掉
HyperLM V2.5 的升级全部围绕私有化现场的真实约束展开——卡是固定的、预算是固定的、业务高峰是波动的。
1. PD 分离:从"抢资源"到"分车道"。针对高频长文本、多用户并发、智能体持续推理场景,平台原生支持 Prefill-Decode 任务分离调度。前后链路资源解耦、独立资源池化,解决传统架构下预填充与解码互相抢占、时延抖动、并发上不去的固有问题,高峰期整体吞吐与业务承载能力显著提升。
2. 多级 KV Cache:同样的卡,接住更多请求。 对系统提示词、高频上下文、固定会话模板做多级缓存复用,大幅减少重复预计算。同等 950DT 硬件规模下,模型服务并发上限提高、单 Token 推理成本下降——这是私有化场景里最容易被忽略、也最直接影响 TCO 的一项。
3. vNPU 精细化虚拟化:把算力切成"标准件"。 全面优化昇腾全系 NPU 虚拟化能力,支持 950DT / 910C / 910B 灵活切分、按需分配,实现 AI Core 算力与 HBM 显存的精细化配额与强隔离,适配小任务、多任务、多模型混部场景。同时支持 vNPU 热迁移与故障自动重调度,硬件维护、节点故障时业务无感,支撑 7×24 小时连续运行。
4. 统一模型网关:一个出口,接住所有模型。 收敛全部模型服务接口,兼容 OpenAI 标准协议,一次接入、全域调用。具备多模型智能路由、精细化限流、流量灰度、A/B 测试能力,可抵御业务潮汐与突发流量冲击,让大模型服务从"各部门各接一套"走向规范、可控、可迭代。
5. 全链路可观测:先看得见,才管得住。 对算力负载、显存占用、带宽吞吐、接口时延、QPS 做全维度实时监控,支持性能劣化预警、故障自动定位、多级业务优先级调度,优先保障核心政务与生产业务的算力供给,满足生产级高可用要求。
合规底座:过得了等保,扛得住审计
对政务、能源、交通、金融而言,合规不是加分项,是准入门槛。
HyperLM V2.5 从架构底层适配信创与等保建设规范:支持三员权限分立、分级密级管控、全流程操作留痕,深度适配国产软硬件环境;同时提供多维度算力计量、模型调用审计、项目用量统计能力,让每一次调用可追溯、每一份算力可核算。审计时拿得出记录,结算时算得清成本,这是政企把大模型从 "试点" 推向“规模化”落地的坚实基石。
未来:把国产算力的"能用"变成"好用"
未来,中科弘云将持续深度融入华为昇腾、海光 DCU 等国产算力生态,围绕异构算力调度、推理加速、智能缓存与 Agent 应用适配持续投入,打磨安全、稳定、高效、可运营的企业级 MaaS 平台,助力更多政企单位实现大模型业务的国产化、规模化、常态化落地。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”