
上海独角兽发布世界模型,少量图像即可构建可物理交互训练环境



机器人前瞻(公众号:robot_pro)
作者 | 刘俐杉
编辑 | 许丽思
机器人前瞻10月31日报道,昨天,大晓机器人联合南洋理工大学S-Lab发布面向具体环境构建,可探索、可交互的世界模型Mundo。Mundo具备场景重建、自由视角探索和时空模拟三项核心能力。
Mundo将物体的质量、摩擦等物理属性纳入场景程序,通过物理引擎计算运动、接触与碰撞。同时,Mundo可调用智能体,通过代码编辑场景中的物体、属性与动作,将少量影像转化为可自由探索、可编程交互、可用于机器人导航与操作训练的三维世界。
简而言之,它可以根据一个真实场景的少量照片或视频,搭建一个三维的机器人模拟练习场。同时,这个三维世界还能够让场景中的物体按照物理规律运动。
Mundo将机器人放入三维世界中,模拟导航和物体操作,生成机器人在不同视角下的观测画面与任务轨迹,为Real-to-Sim工作流中的机器人测试与训练提供支持。
Mundo进一步将场景中的物体和物理属性纳入可编辑的仿真系统,让环境不只是能够被观看,还能对动作作出计算和响应。
最终,该模型可以在同一个定制化环境中支持空间探索、物理交互、动态仿真以及机器人任务。
一、根据上下文图像构建定制化环境
Mundo首先需要解决的是,如何从少量图像中还原一个能够持续探索、可编辑的三维环境。
在输入端,Mundo在输入1至12张真实场景的上下文图像后,便可以沿着指定的相机运动路径生成新的视角。
即便只有一张图像、一个视角,系统也能够在图像所描绘的空间中生成相机运动路径,并将原图的视觉风格和可见结构延伸到新的视角中。
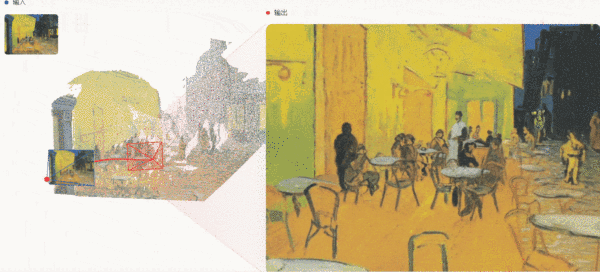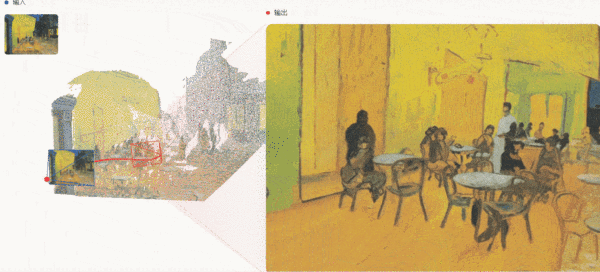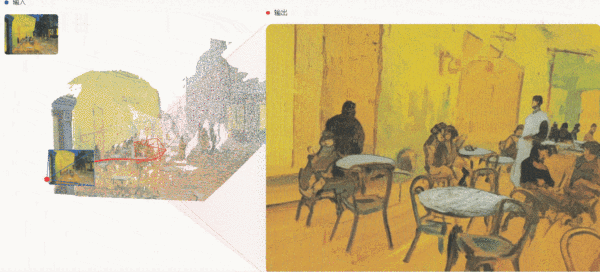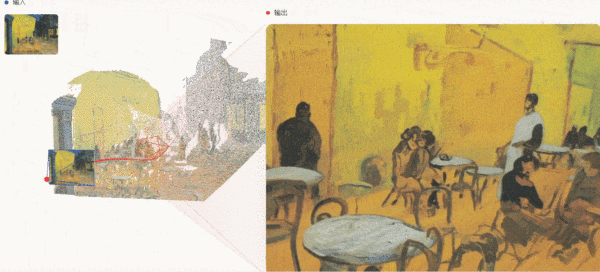
▲单一图像生成世界
当相机逐渐偏离原始视角时,Mundo还需要生成原图从未展示过的表面和区域。不过,对于没有被拍摄到的区域,需要模型自行推断,因此输入的参考图像越多,Mundo掌握的场景信息就越丰富,未拍摄区域需要模型自行推测的内容也就越少。
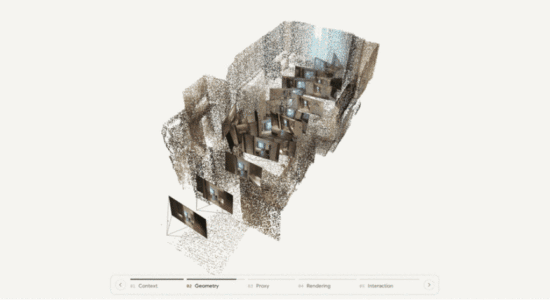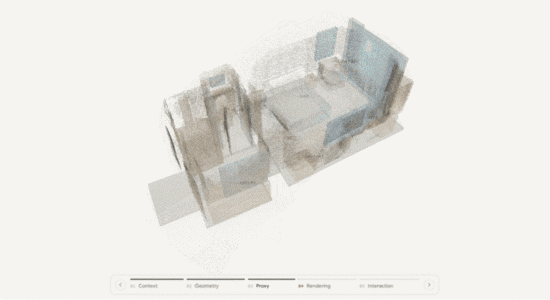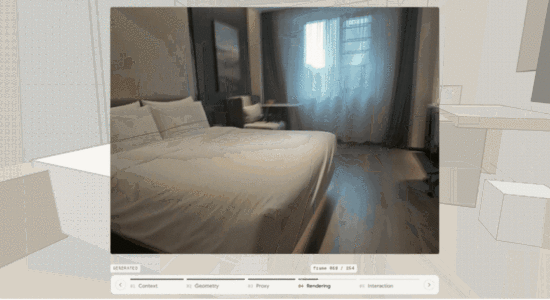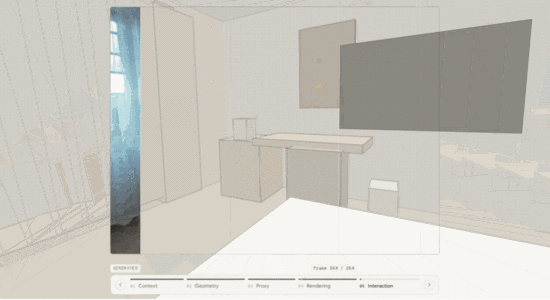
在场景重建阶段,该模型会先重建一个三维代理场景,确定输入图像中不同视角之间的空间关系。
构建代理世界分为两个阶段。
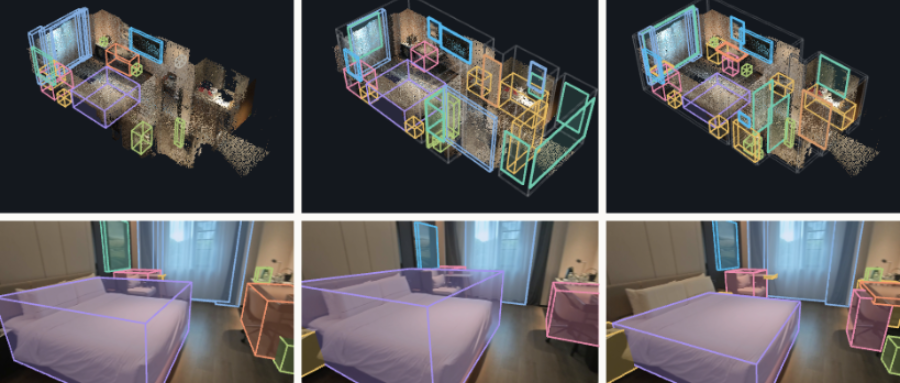
首先,三维基础模型可以根据输入视角,恢复相机位姿和稠密几何信息。接着,Mundo使用三维检测器,为每个主要物体生成一个初始边界框。
这里的三维边界框表示场景,主要记录物体的位置、尺寸和空间关系,尽可能让输入图像中的物体位置、尺寸与现实保持一致。
不过,三维检测器经常会漏检物体,或将物体识别为错误的类别。它们生成的边界框在空间位置和尺寸上也可能不够准确。
因此,该模型利用视觉语言模型(VLM)智能体,对三维代理场景进行调整。
具体而言,智能体会在渲染引擎中编辑场景程序,从输入图像对应的相机视角渲染代理场景,再将渲染结果与原始图像进行比较,并据此决定下一步如何调整。
在这个过程中,VLM负责判断问题出在哪里,可以识别是否存在物体缺失、开门方向错误等问题。数值优化负责精确拟合边界框的位置、尺寸和朝向。
只有当拟合结果在未参与优化的视角中也能与物体保持一致时,系统才会保留这次拟合结果。每轮编辑完成后,另一个独立的审核智能体会检查代理场景与所有输入视角是否一致,但不会直接修改场景。
如果审核智能体认可结果、场景几何拟合不再有明显改善,或者达到编辑次数与时间限制,整个迭代过程就会停止。否则,编辑智能体会根据审核结果继续进行下一轮调整。
在场景探索方面,探索大型环境需要的信息,远多于探索单个房间所需的信息。
面对大型场景,Mundo可以生成持续数十秒甚至数分钟的相机运动画面。对于每个视频片段,模型会根据相机即将经过的区域,从输入图像中挑选最相关的上下文照片,作为当前片段的参考
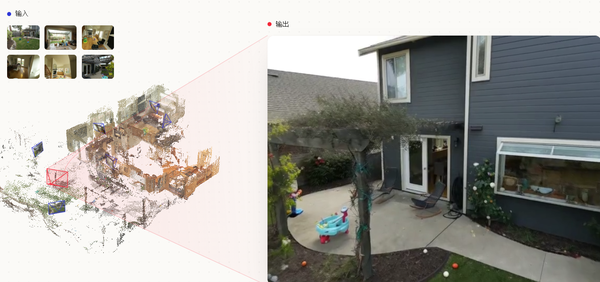
▲大型场景的长视频
为了让不同片段之间保持连贯,Mundo还会保留前后片段的部分重叠画面。生成下一个片段时,系统会将上一段视频末尾的部分画面作为固定参考,让相机能够沿着原来的路径继续移动。
二、代码定义物体属性,物理引擎计算交互过程
如果一个三维场景只能改变视角,却不能模拟物体运动,那么它对机器人操作训练的帮助仍然有限。
而Mundo可以为重建场景中的物体添加物理属性,模拟它们的运动和交互过程,再利用环境的上下文图像渲染这些运动,让重建出来的环境具有可计算的物理行为。
Mundo是通过代码运行和编辑三维世界的。
场景程序是一种代码化世界模型,在场景程序中,每个物体都有自己的名称、位姿和尺寸,以及质量、摩擦力等物理属性,它会明确记录场景中物体的信息,同时定义这些状态随时间变化的规则。
例如,在一个办公室场景中,可以设置椅子的质量和摩擦属性,再通过脚本让机器人推动椅子。物理引擎会根据物体属性、外力、重力和接触约束,计算椅子的运动过程。
其中,脚本负责指定物体动作和施加的外力。物理引擎则根据重力和接触约束,计算物体受到这些因素影响后的响应。
程序可以读取和修改这些状态,从而模拟重建场景中的物体运动和交互过程。
在仿真上,Mundo目前主要使用MuJoCo进行仿真任务,但其他仿真引擎或自定义脚本也可以承担类似的工作。
在仿真过程,系统会计算物体的运动轨迹、接触位置和碰撞力。随后,Mundo会在重建场景中渲染物体的运动过程。
完成物理计算后,Mundo还需要将仿真结果转化为人们能够看到的视频。
这一步由视频扩散模型负责。
Mundo会根据仿真世界和指定相机视角,生成相应的代理帧。
如下图所示,在这些画面中,不同类别的物体会用不同的纯色表示。
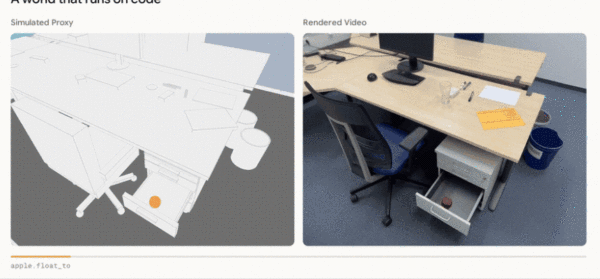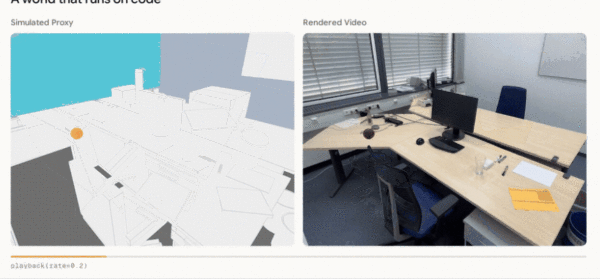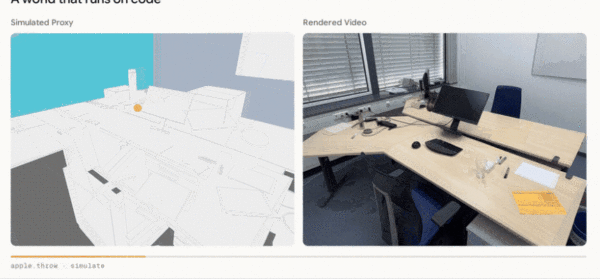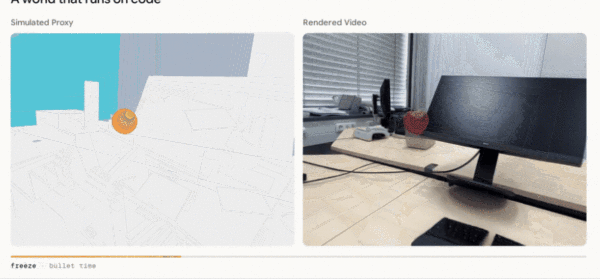
▲用纯色表示不同类别物体
随后,系统会将上下文帧,以及目标相机运动轨迹下生成的代理视频,一并输入视频扩散模型进行渲染,视频模型根据这些信息,生成符合原始环境外观的动态画面。
对于较长的视频,渲染器会采用流式推理,将视频拆分为多个片段。以研究团队使用的设置为例,每个视频片段包含124帧,其中最后34帧会被重新编码,并作为下一个片段的固定前缀。这样可以保证不同片段之间的运动连续性。
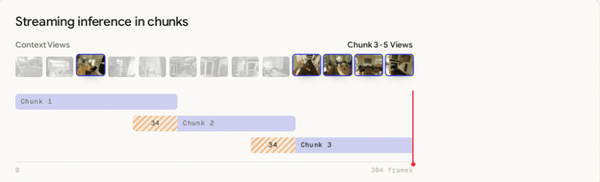
▲视频生成为124帧的片段
在模型训练方面,Mundo的渲染器使用成对的视频进行训练,一组是真实拍摄或渲染得到的视频,另一组是同一场景对应的代理视频。
训练数据包含约4万组视频对,来自多个数据集,覆盖真实室内扫描、合成室内场景、自动驾驶、手物交互、单个物体以及游戏画面等领域,同时也包括研究团队自行渲染的数据。
研究团队使用这些数据,对MiniMax-H3的Ref2VA模型进行了微调。训练视频片段为124帧,分辨率为640×480。
对于自行渲染的数据,研究团队可以自主选择相机运动轨迹、交互过程和上下文图像。
此外,训练数据还可以加入其他参考图像,例如一个即将进入场景的物体图像。
三、构建机器人虚拟训练环境,支持导航、操作和动态仿真
在场景重建和物理交互的基础上,Mundo进一步将能力延伸到机器人导航、操作和动态仿真。
Mundo可以在上下文图像所定义的特定环境中模拟动态行为。
具体而言,它构建的物理感知三维代理场景,为机器人导航和物体交互提供了场景基础。这使真实环境中的信息能够被引入仿真,用于Real-to-Sim测试与训练。
首先是机器人导航。
Mundo构建的三维代理场景包含物体类别、位置、障碍物和可通行区域等空间布局和语义信息,可以为机器人在特定环境中规划导航路径提供支持。
同时,Mundo可以从第一人称和第三人称视角,渲染不同机器人在同一环境中的导航过程,并在机器人沿路径移动时保留场景的上下文信息。
在物体操作方面,Mundo可以为交互中涉及的物体建立几何模型和物理属性。随后,不同机器人可以在这个环境中尝试执行相同的操作任务。
例如将苹果放入碗中、将罐子放上托盘或堆叠积木。在这些任务中,系统不仅能生成外部观察视角,还能生成机器人头部摄像头和腕部摄像头拍摄的画面。
同时,系统会保留任务运动轨迹和物理交互状态。
这些数据可以帮助研究人员同时分析机器人看到了什么、执行了什么动作,以及动作产生了怎样的结果。研究人员还可以在仿真环境中比较不同机器人的执行表现,再决定是否进入真实场景测试。
除导航和操作外,Mundo还支持四维时空模拟,即同时考虑空间和时间维度。
对于多摄像头记录的动态事件,系统可以从新的视角重新呈现事件过程。对于基于图像构建的模拟事件,则可以根据重力和接触动力学计算物体运动。
它可以利用多摄像头录像或单张图像作为上下文,从新的视角渲染动态事件。用户还可以将时间冻结在指定时刻,再移动相机,从不同角度观察场景。
此外,研究团队还展示了酒店场景中的机器人应用。
如下图所示,研究团队使用Mundo重建了酒店楼层和洗衣房环境,为机器人提供空间布局和语义信息。演示内容包括机器人在洗衣房中探索环境、打开洗衣机门、在仿真环境中的导航等交互过程。
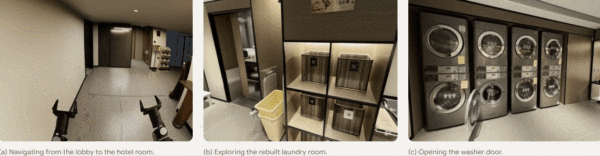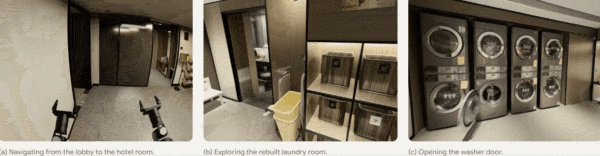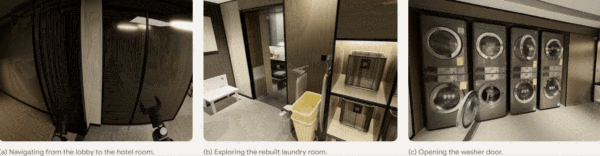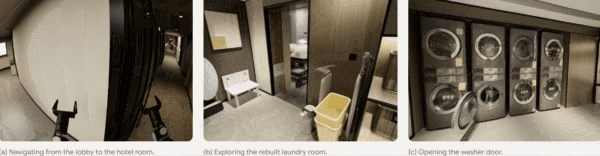
▲三种演示内容
智能体在这一楼层规划路线,并在移动过程中利用三维代理场景确定自身位置。
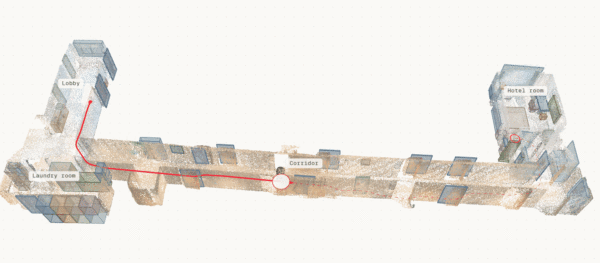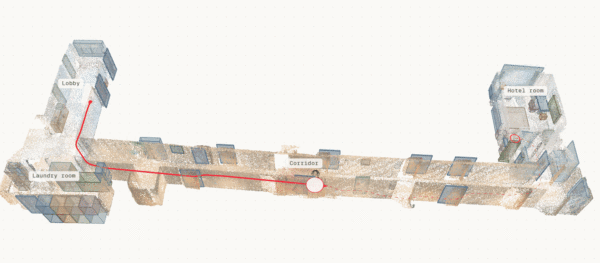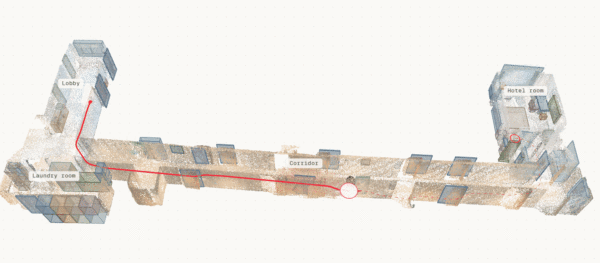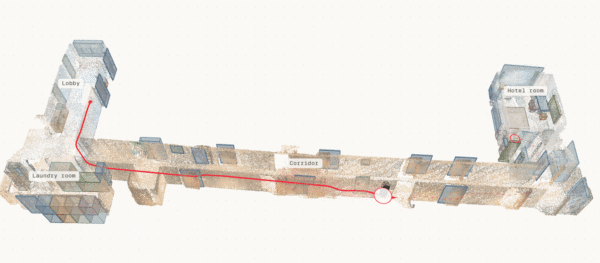
▲智能体在场景中确定自身位置
这类能力的价值在于,可以把真实场景中的环境信息转化为仿真环境,让机器人在进入真实场景之前,先进行路线规划、动作测试和策略调整。
结语:尝试拓展世界模型的边界,但仍有局限
Mundo的技术思路,是将三维场景表示、物理仿真和视频生成整合在一起,让真实环境能够被转化为可编辑、可交互的虚拟场景。
不过,它目前仍存在一定局限。
首先,在运行速度上,当前版本的Mundo运行速度还不够快。
研究团队公开信息显示,当前版本场景重建通常需要10至20分钟,在使用8张A800 GPU、执行20步推理的情况下,基于代理场景进行视频渲染的速度约为每秒1.5帧,研究团队目前还没有对视频模型的推理过程进行加速。
精细交互能力方面,在重建场景中,小物体往往会出现悬浮现象。
此外,当渲染涉及小物体操作的交互过程时,视频模型也容易产生幻觉,即生成与真实物理过程不符的内容。
同时,Mundo目前还没有长时程记忆机制。
虽然上下文图像有助于保持静态场景的一致性,但在经历长时间的动态变化后,Mundo仍可能无法持续保留场景细节。
因此,即便目前仍有不足,但对于机器人行业而言,Mundo尝试拓展了世界模型的能力边界,并展示了一条值得探索的技术路线,让真实场景不再只是机器人观察和识别的对象,还能转化为能够计算物理变化、模拟动作结果的训练环境。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”