如何让Token更便宜,Agent更可靠?网易有道、MiniMax、AMD等机构重算AI成本账
10月23日,2026中国计算机大会(CNCC 2026)“从Token到价值:可持续人工智能系统和产品的构建与实践”专题论坛在成都举行。论坛由网易有道主办,来自MiniMax、久痕科技、浙江大学滨江研究院、AMD及网易有道的嘉宾,围绕AI原生组织、智能体系统设计、可信AI治理、端侧计算和产品实践展开分享,并就成本优化与商业化路径进行讨论。
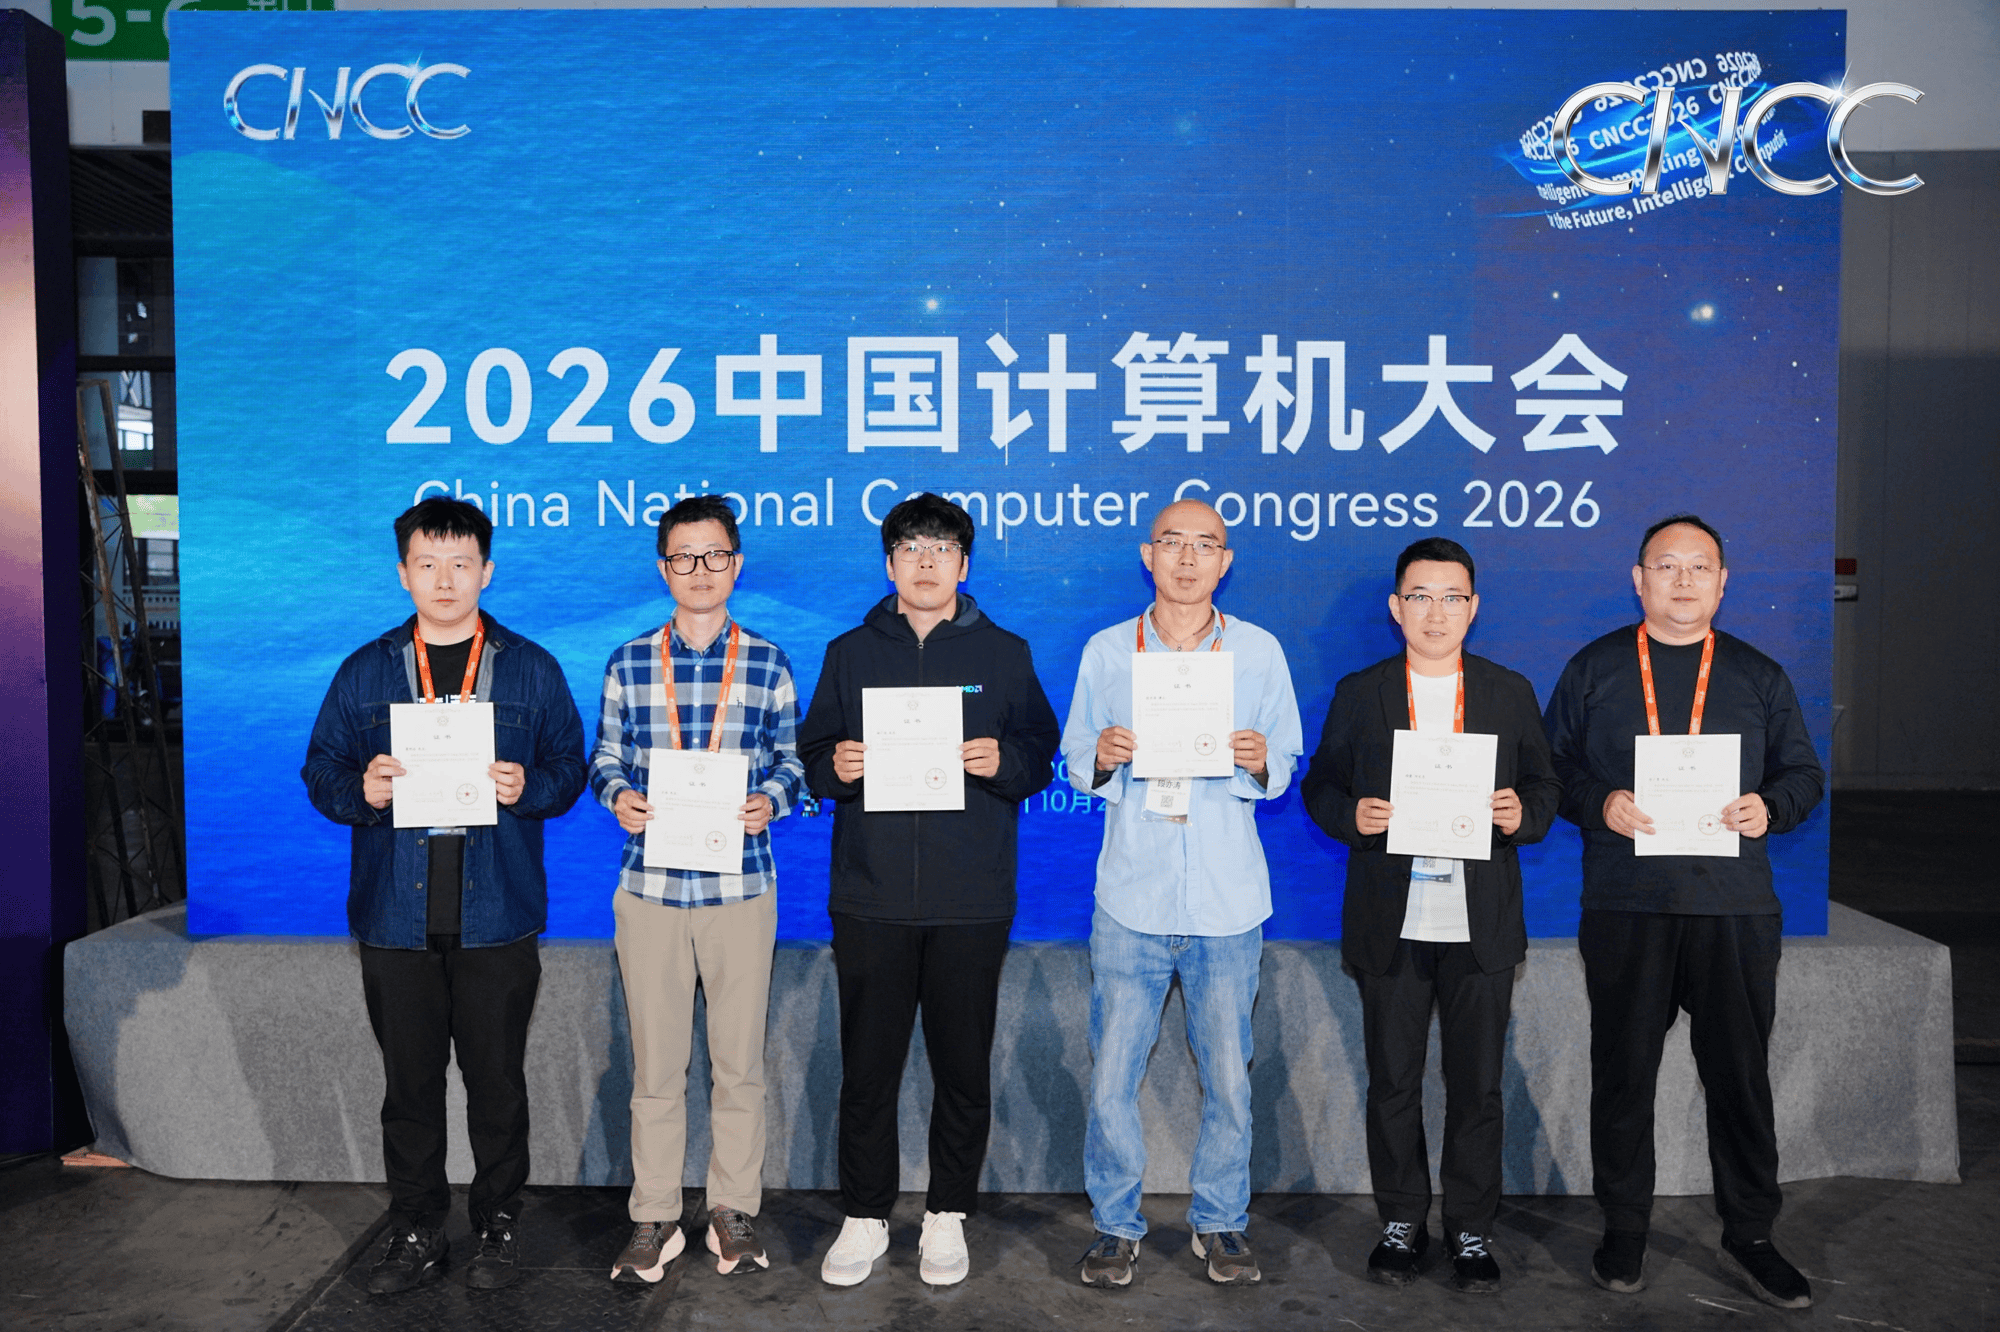
(图注:从左至右分别是MiniMax葛明放、久痕科技创始人汪源、AMD ISV 部门 AI 技术负责人杨广远、网易有道首席科学家段亦涛、浙江大学滨江研究院数智融合研究中心主任韩蒙、网易有道Infra负责人张广勇)
网易有道首席科学家段亦涛担任论坛主席和主持人。他在开场中提出,随着大模型能够完成的任务越来越多,行业需要回答一个关键问题:不断增强的AI能力,如何转化为真实、可持续的价值?
围绕这一问题,与会嘉宾从各自的实践出发,将讨论延伸到模型之外的组织、工程、治理和商业环节,站在行业最前沿,从算力,模型,Agent管理,模型等角度,提供了非常具有前瞻性的思考和洞见。
网易有道:围绕用户场景,让AI帮助人完成任务与积累能力
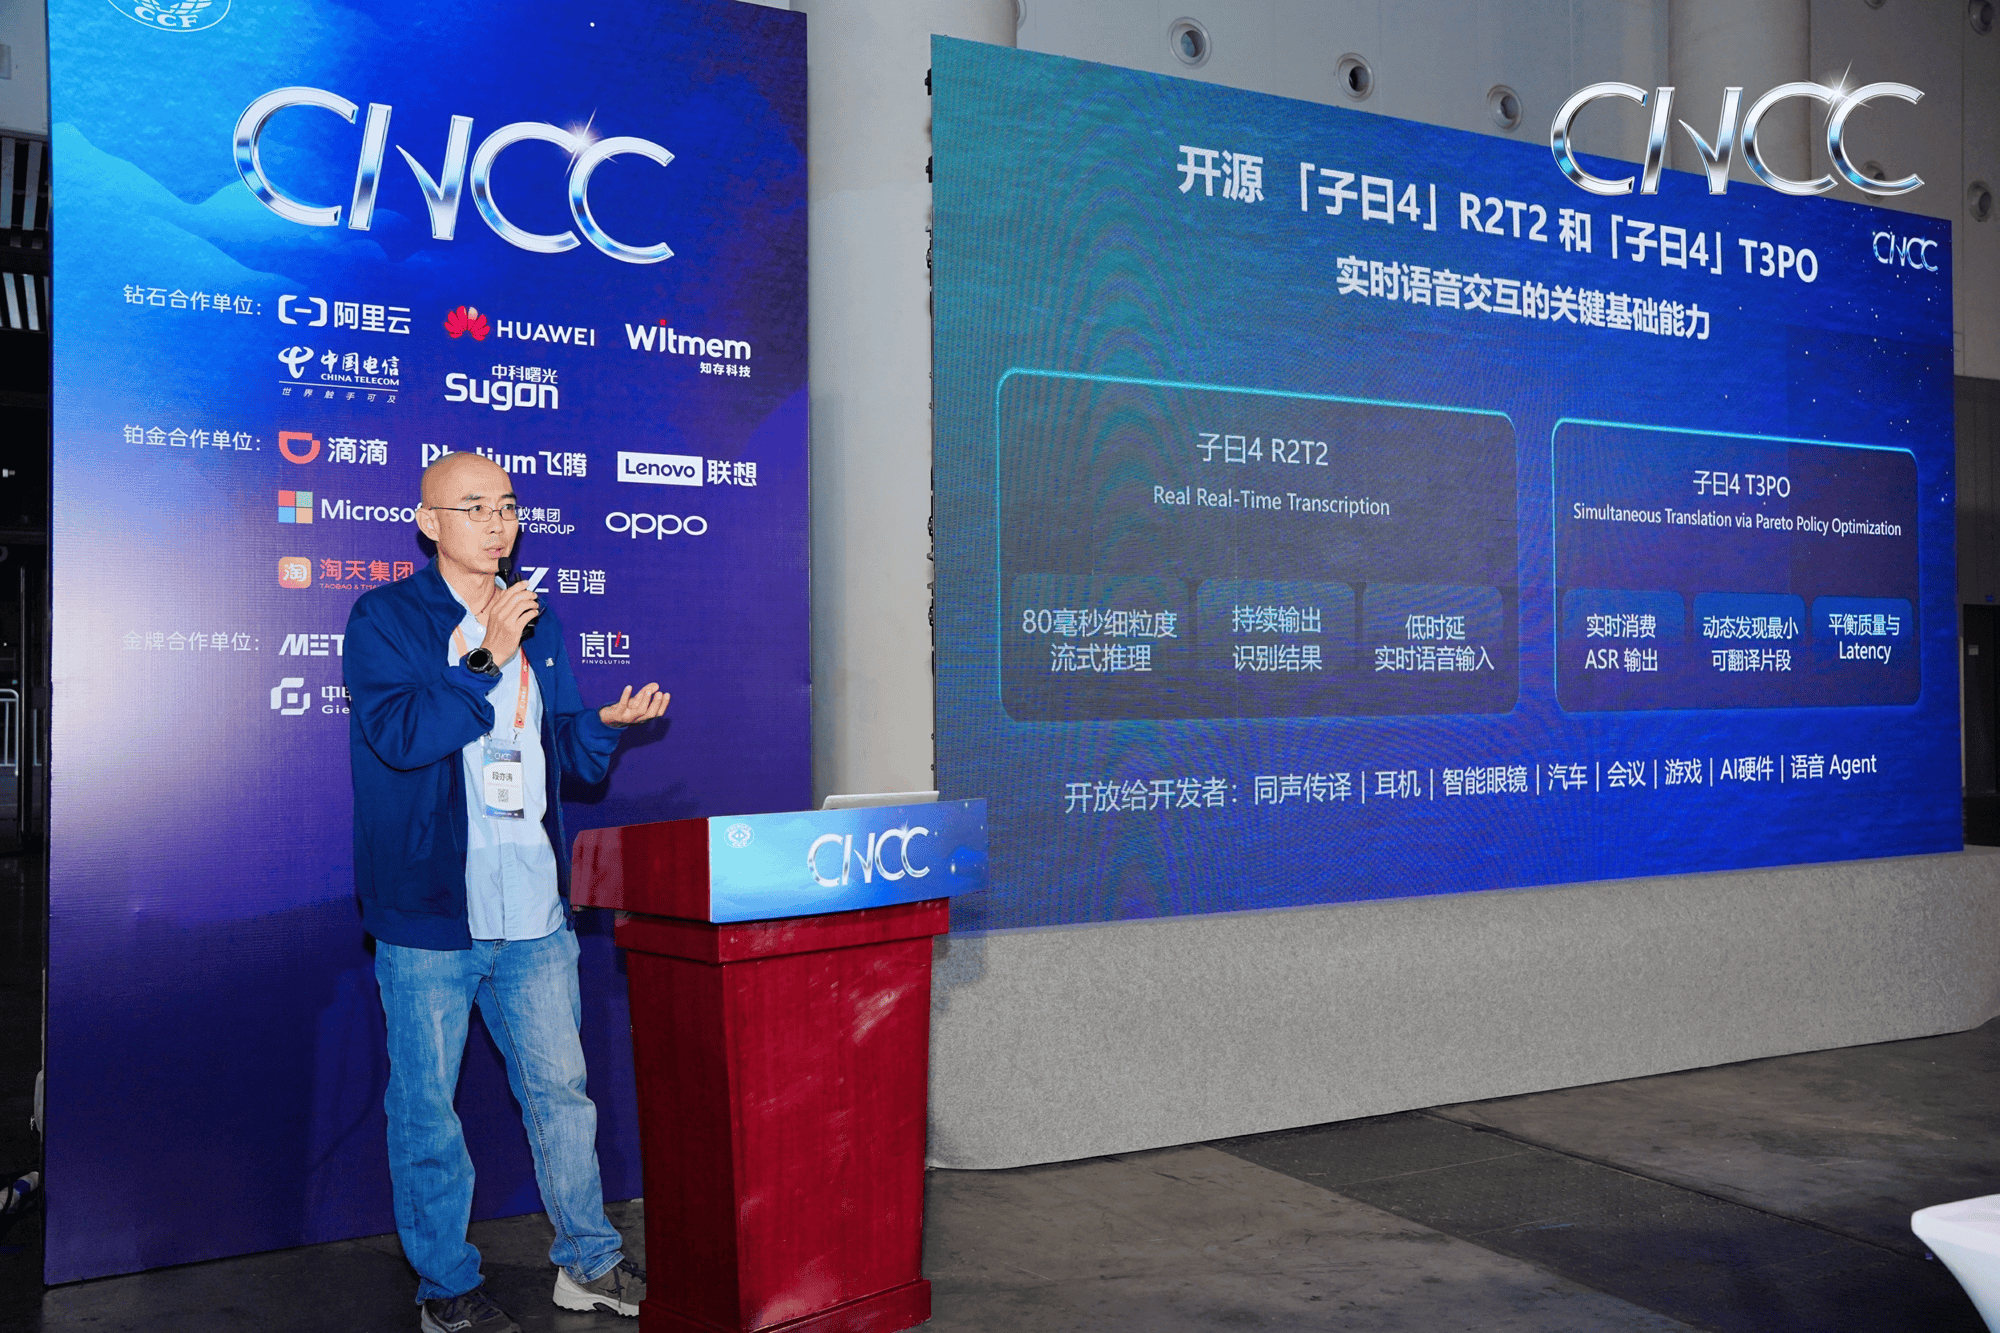
(图注 网易有道首席科学家段亦涛)
段亦涛从直接面向用户的产品实践出发,分享了有道推进AI落地的思路:围绕具体场景,把核心能力做好,并兼顾效果、成本与用户体验。
在实时交互领域,他介绍了两款上个月刚刚开源的流式语音识别模型R2T2和流式同声翻译模型T3PO。两者都面对信息尚不完整时如何作出判断的挑战,需要在输出质量与响应延迟之间找到平衡,进而改善字幕、语音输入和同传等场景的体验。两个模型开源之后都受到了开发者的欢迎,分别登顶了Hugging Face专区热榜,最高下载量突破16万。
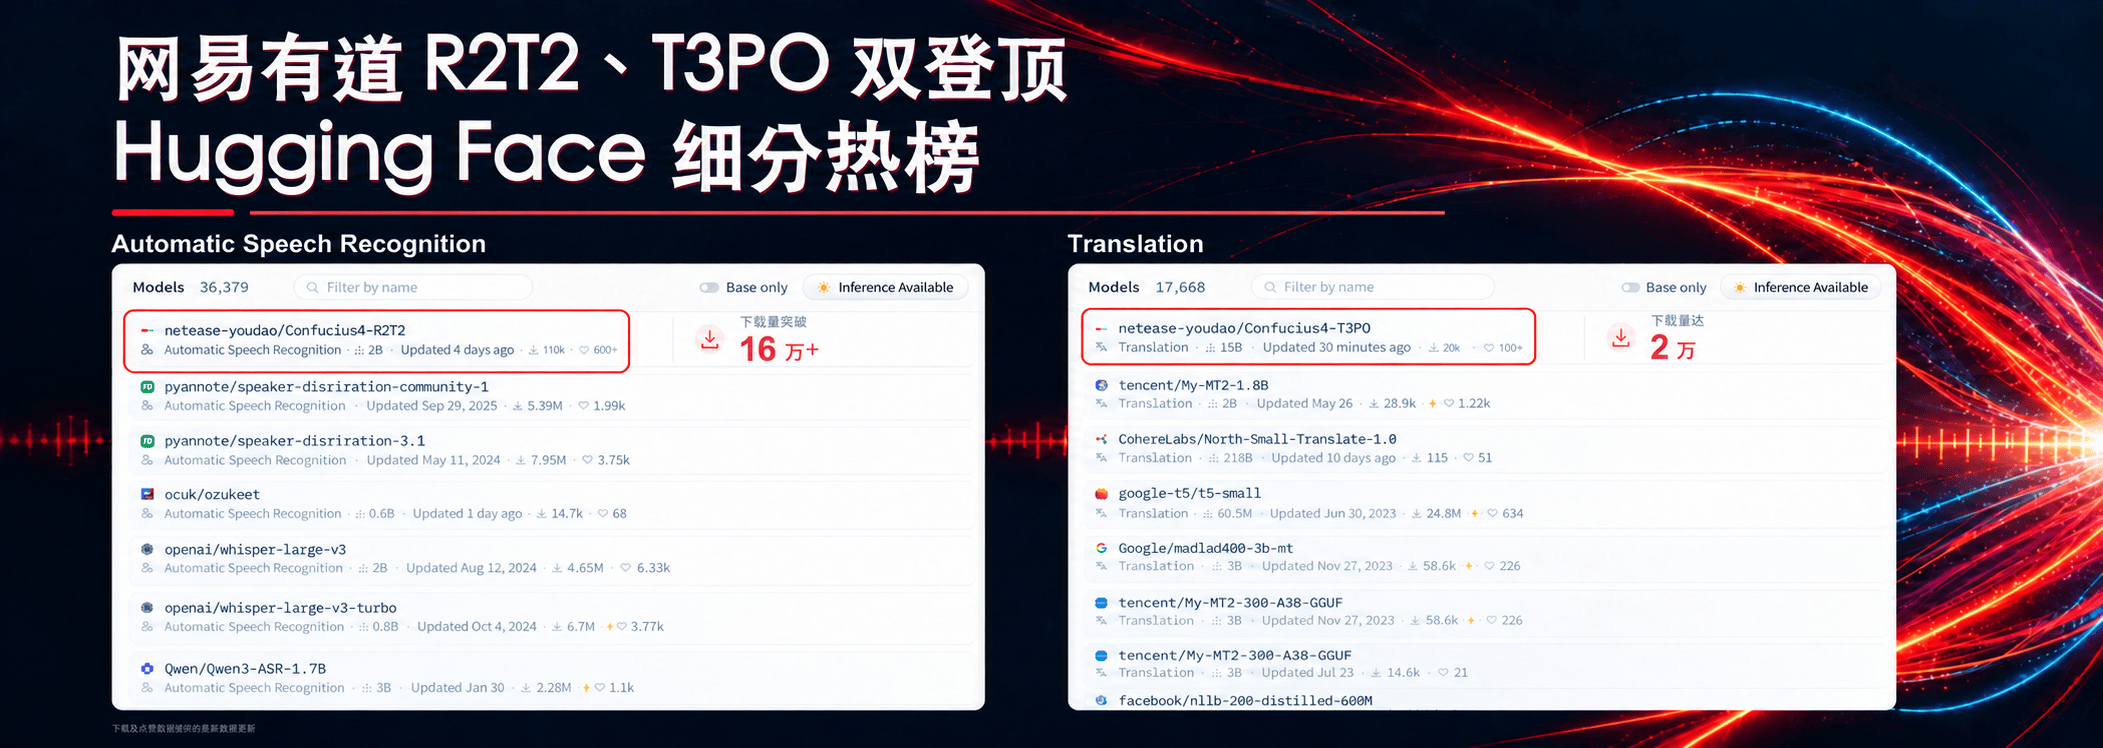
(子曰4 R2T2 和子曰4 T3PO 登顶情况介绍)
在智能体产品层面,段亦涛强调,需要通过Harness,将模型与专业数据、工具及工作流程结合起来,使其能够处理用户的实际任务。
以“有道有据”为例,这一产品将AI与研究工作台结合,支持资料检索、证据核验、论文阅读及内容创作,同时通过笔记、标注、追问和收藏帮助用户积累思考成果。
在段亦涛看来,AI产品的价值还包括人的成长:用户在完成任务的过程中,应当获得新的认知、知识和判断。他将这一理念概括为“双脑协作,1+1大于2”,希望AI既提升工作效率,也帮助用户形成长期能力。
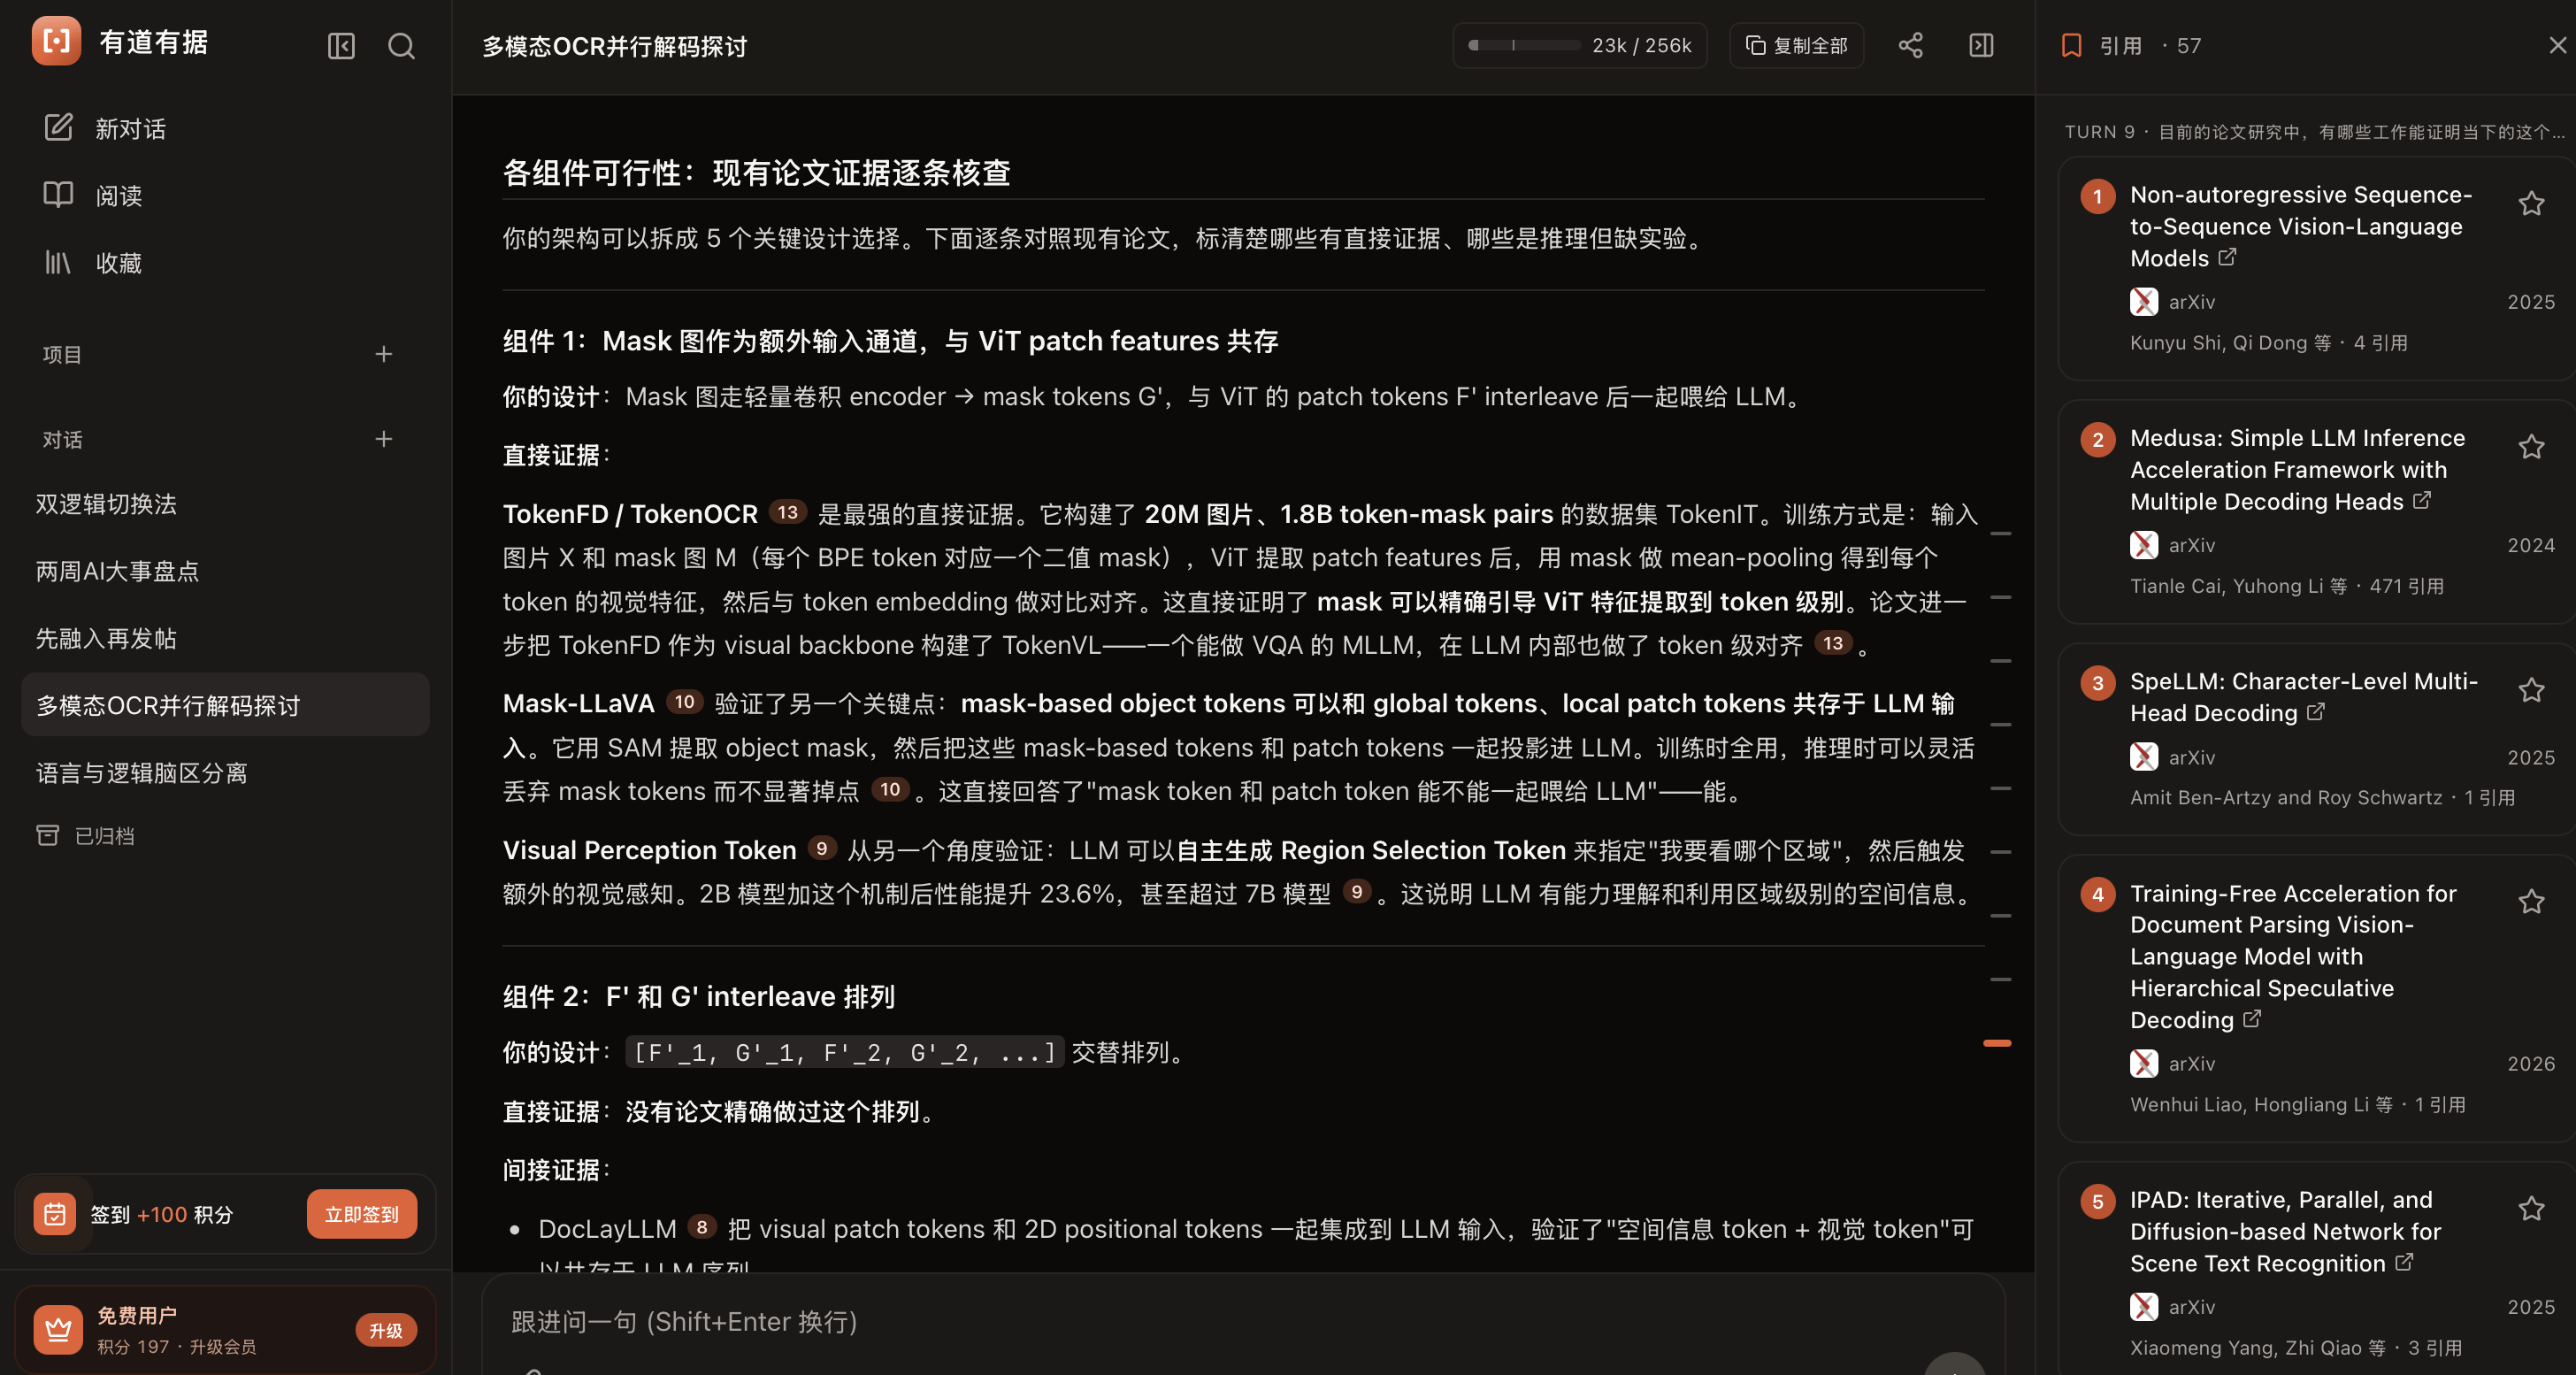
(有道有据截图)
MiniMax:让每个人都能指挥一支Agent团队
MiniMax 葛明放分享了公司建设AI原生组织的实践。在他看来,企业要将AI能力带入客户业务,首先需要成为AI的重度用户。
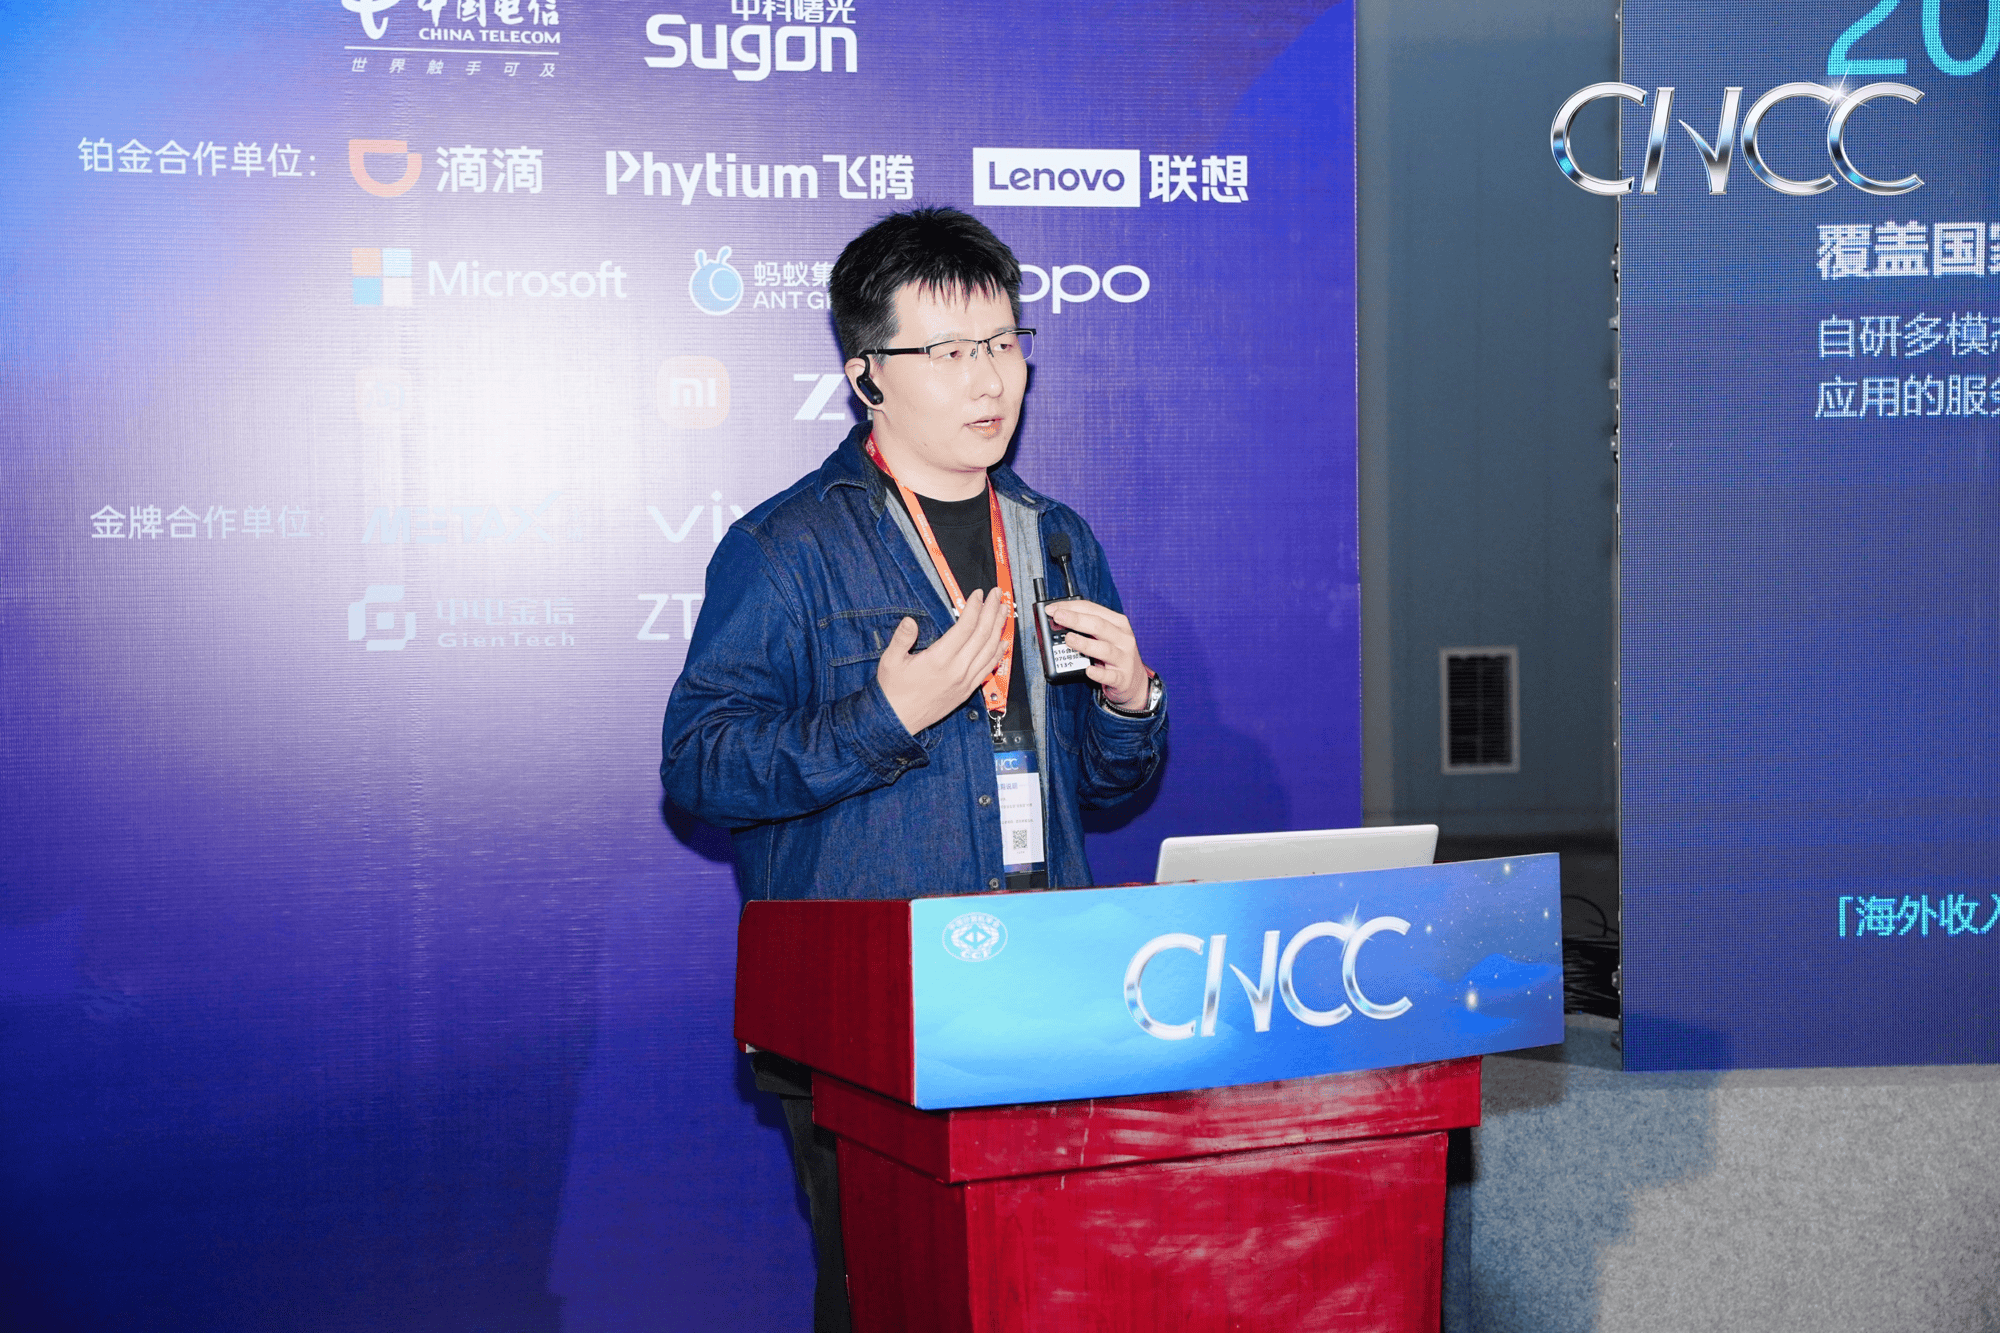
(图注 MiniMax 战略部大模型技术方案负责人葛明放)
MiniMax通过面向员工提供充足的Token资源、建立统一模型网关、开放工具选择等方式,降低员工探索AI的门槛。在此基础上,内部智能体逐步从个人使用的碎片化工具,发展为覆盖不同职能的“Agent实习生”,再进一步演进为能够处理完整任务的业务专家。
这一变化的关键,是让智能体具备明确的职责、权限和工作边界,并使任务过程可观察、可暂停、可恢复。例如,在客户问题排查中,智能体可以协助复现问题、整理记录、通知相关团队,部分工程问题还可以推进至代码修改和人工审核环节。
葛明放认为,员工在真实业务中使用AI的经验,也能反过来帮助改进模型。长流程任务中暴露的工具调用失误、上下文丢失等问题,是具有业务约束的改进信号。
AI原生组织的目标,是让每个人都能够组织和指挥Agent团队,将个人经验转化为整个组织可以复用的能力。
久痕科技:用更合适的任务表达,提高智能体执行效率
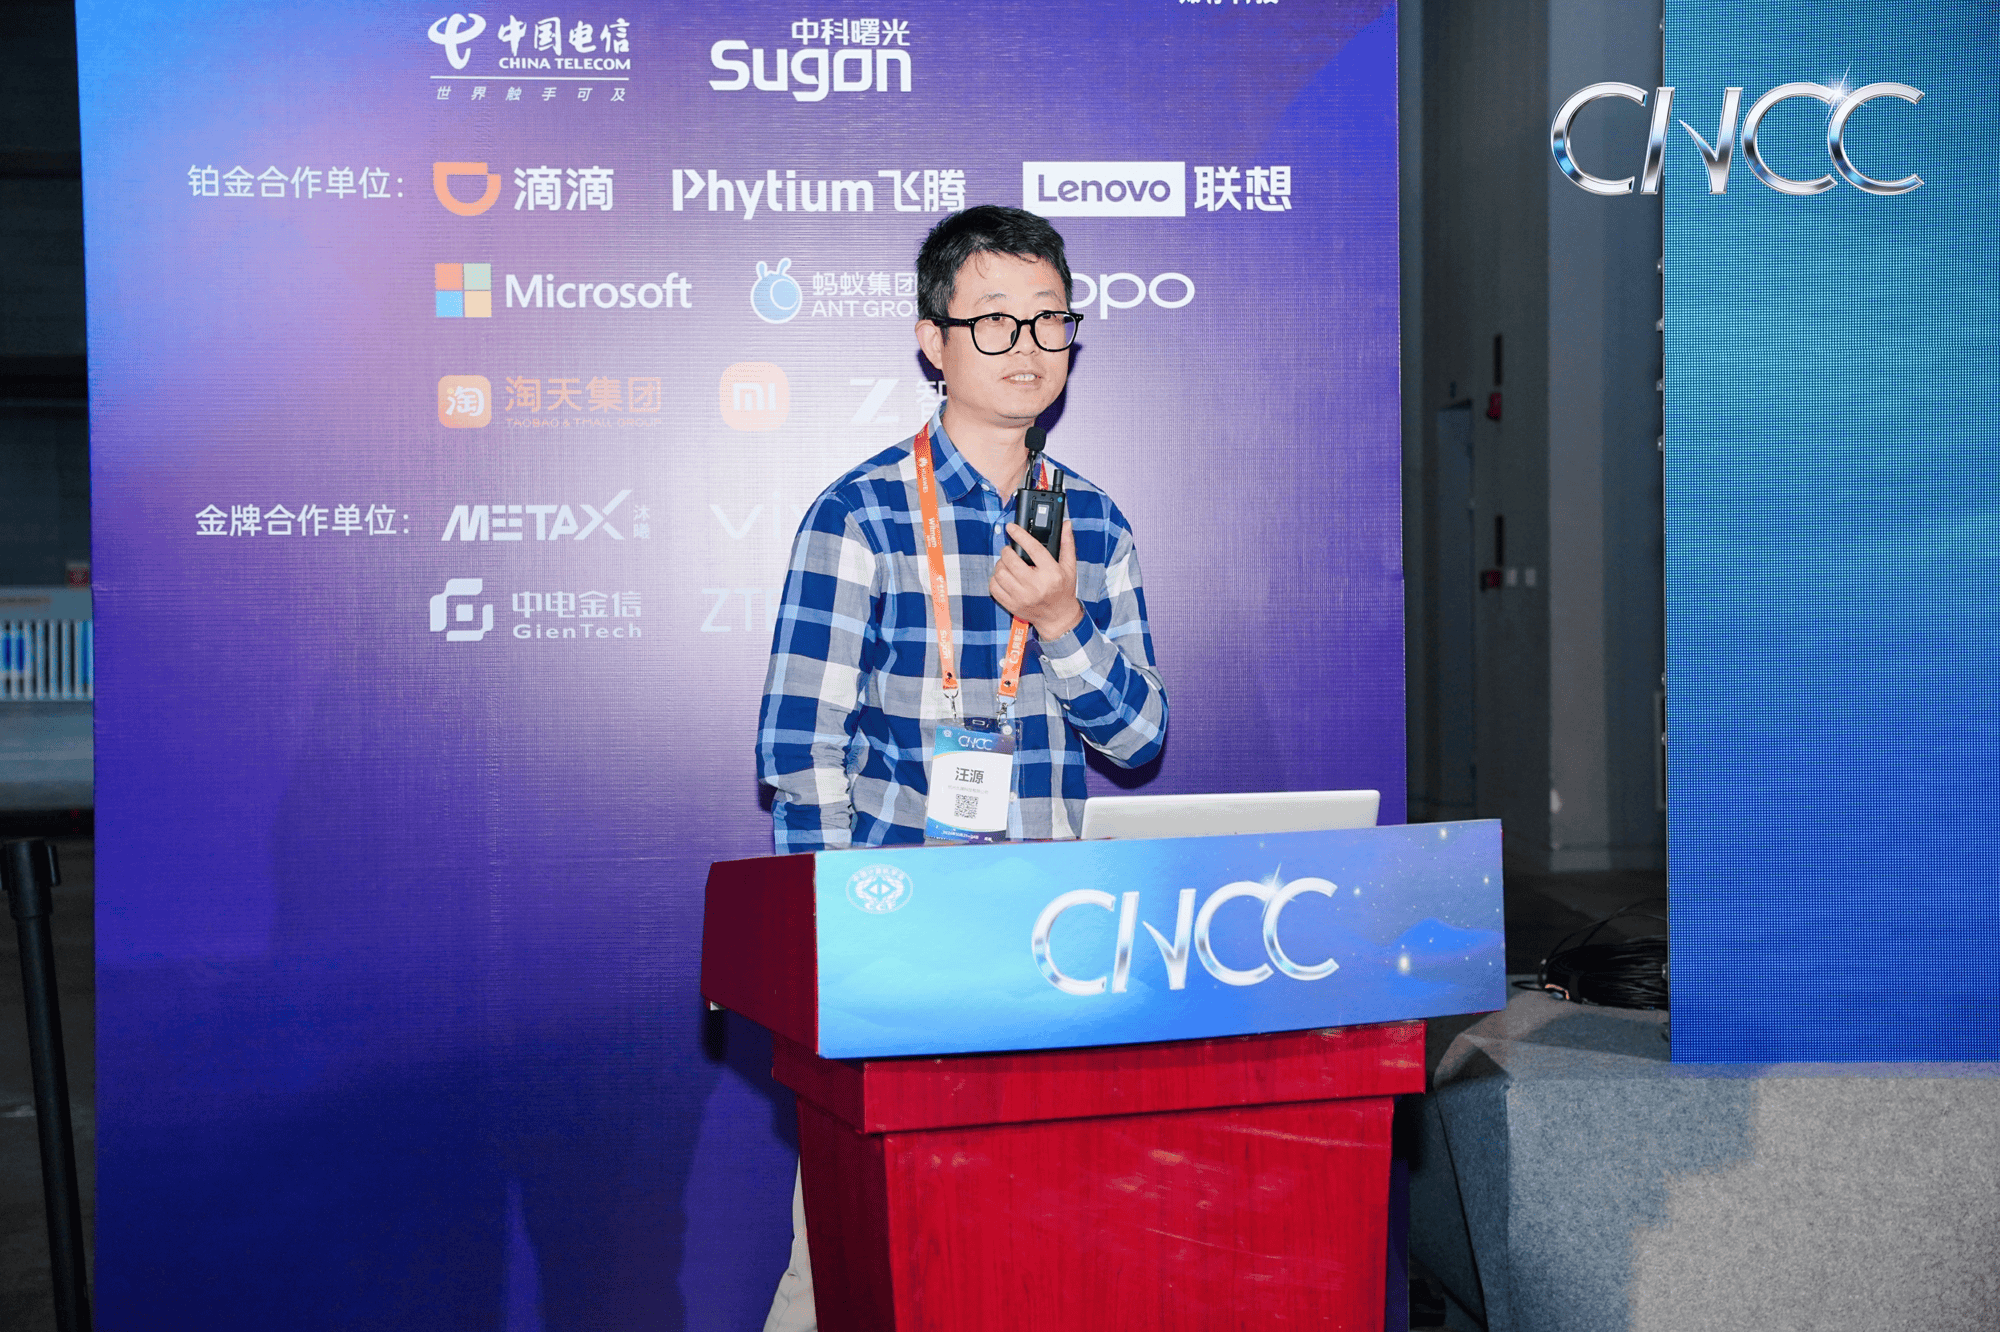
(图注 久痕科技创始人汪源)
久痕科技创始人汪源将分享聚焦于智能体系统的工程设计。他提出,当智能体已经能够跑通基本流程,产品进一步竞争的重点,就包括任务完成时间、Token效率以及交付结果的质量。
围绕这些问题,汪源介绍了领域专用语言(DSL)的作用:让模型理解的内容、上下文提供的信息和工具执行的操作,尽可能围绕同一套清晰、精炼、可验证的表达方式展开。
他以PPT生成和编辑为例指出,智能体在HTML、PPT原始格式、Markdown等不同表示之间反复转换,容易增加处理成本,也会给复杂版面的理解和修改带来困难。
久痕科技探索的知识表达语言KRL,旨在将复杂内容转化为可理解、可展示、可编辑的统一表示,让智能体能够在更高层次上处理任务,减少对底层复杂格式的直接操作。
这一实践体现了他的核心判断:提高智能体效率,需要同时改进模型处理任务的方式,以及模型与工具之间协作的机制。在圆桌讨论中,他进一步指出,上下文、记忆、任务分配和技能设计,都是值得持续优化的环节。
浙江大学滨江研究院:让AI的行动可验证、可追溯、可纠偏
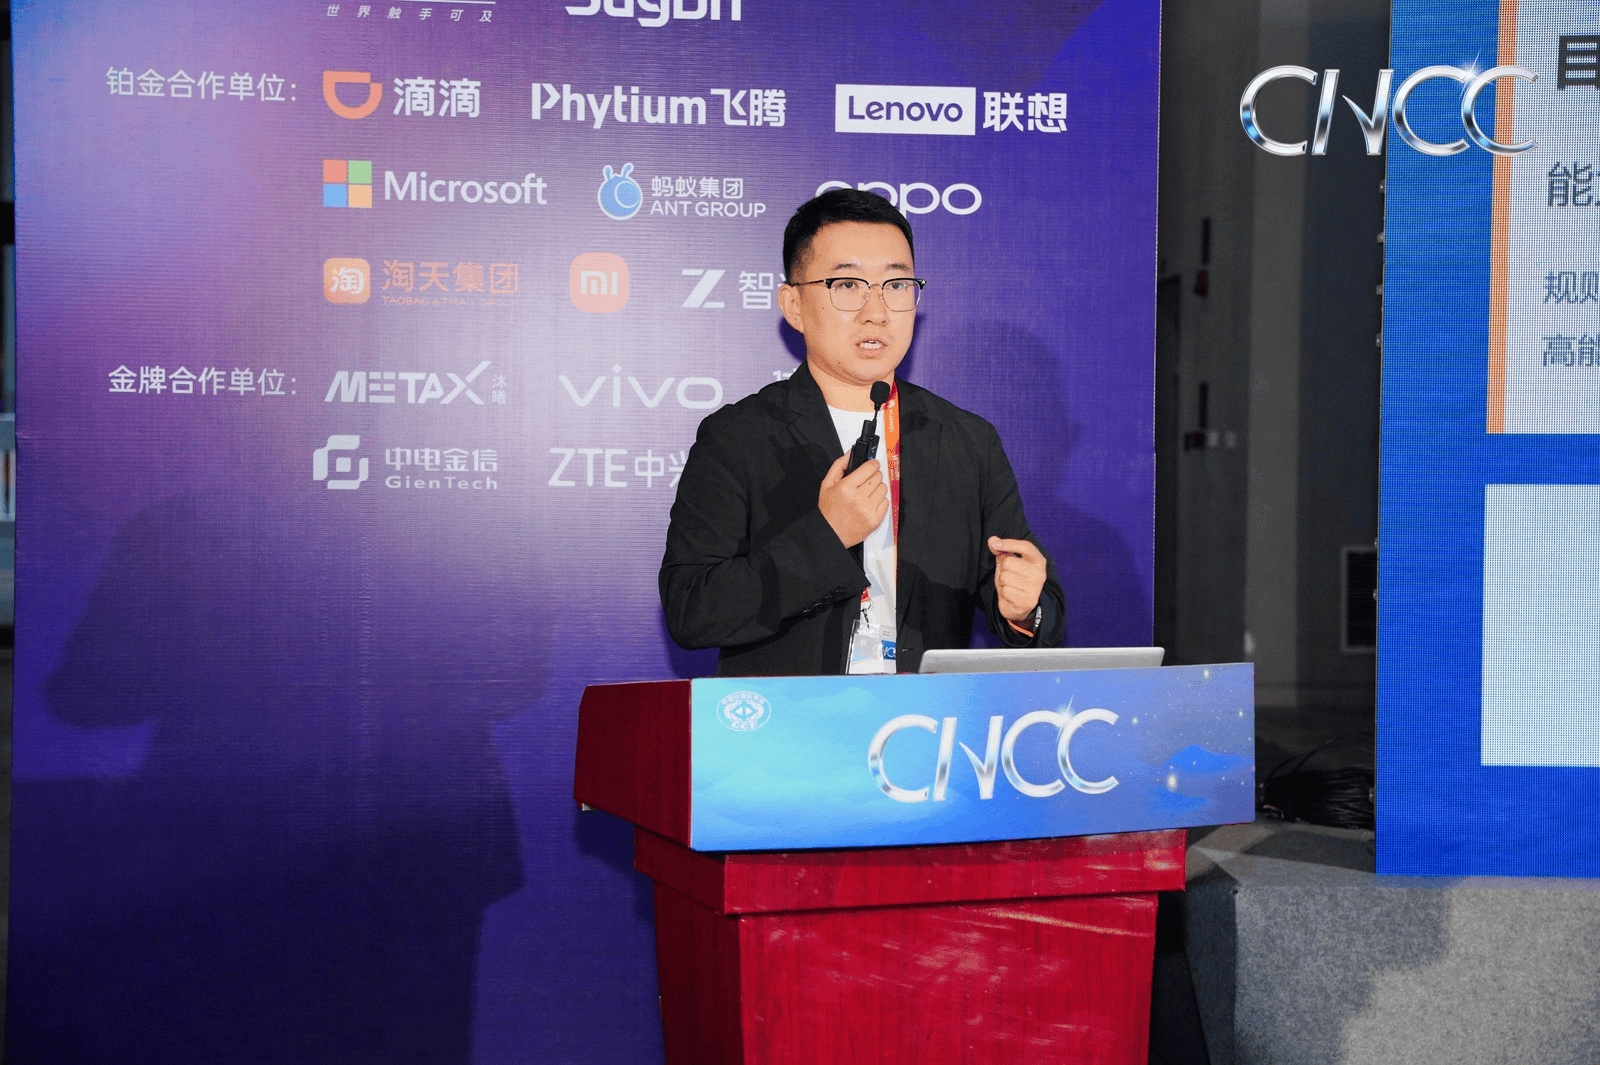
(图注 浙江大学滨江研究院数智融合研究中心主任 ,君同未来创始人韩蒙)
浙江大学滨江研究院韩蒙博士从可信AI的角度提出,随着AI从生成答案走向调用工具、执行任务,治理对象也随之扩展到模型、数据、权限、工具和完整任务链。
他提出了一个直接的问题:当智能体开始行动后,谁为结果负责?
在韩蒙看来,智能体的风险并不只来自外部攻击。即使没有恶意行为,也可能因为目标不完整、上下文偏差、工具调用错误或任务之间的相互影响而产生问题。单个模型表现可靠,也不意味着围绕它构建的智能体系统必然可靠。
因此,可信性需要贯穿执行前、执行中和执行后:既要明确有哪些智能体、获得了哪些授权,也要开展准入评测、运行监测、结果核验和追踪审计。
针对记忆、检索和多步骤任务,他还强调,应检查信息是否足以支撑结论,避免同一来源被反复引用后形成虚假的多重证据。
在圆桌讨论中,韩蒙将可信性与经济性联系起来:衡量AI成本,应关注完成一次有效任务、交付一个可靠结果需要付出多少。如果Token已经消耗,任务却没有完成,低廉的调用价格也难以形成实际价值。
AMD:通过端侧计算与异构调度,提高算力利用效率
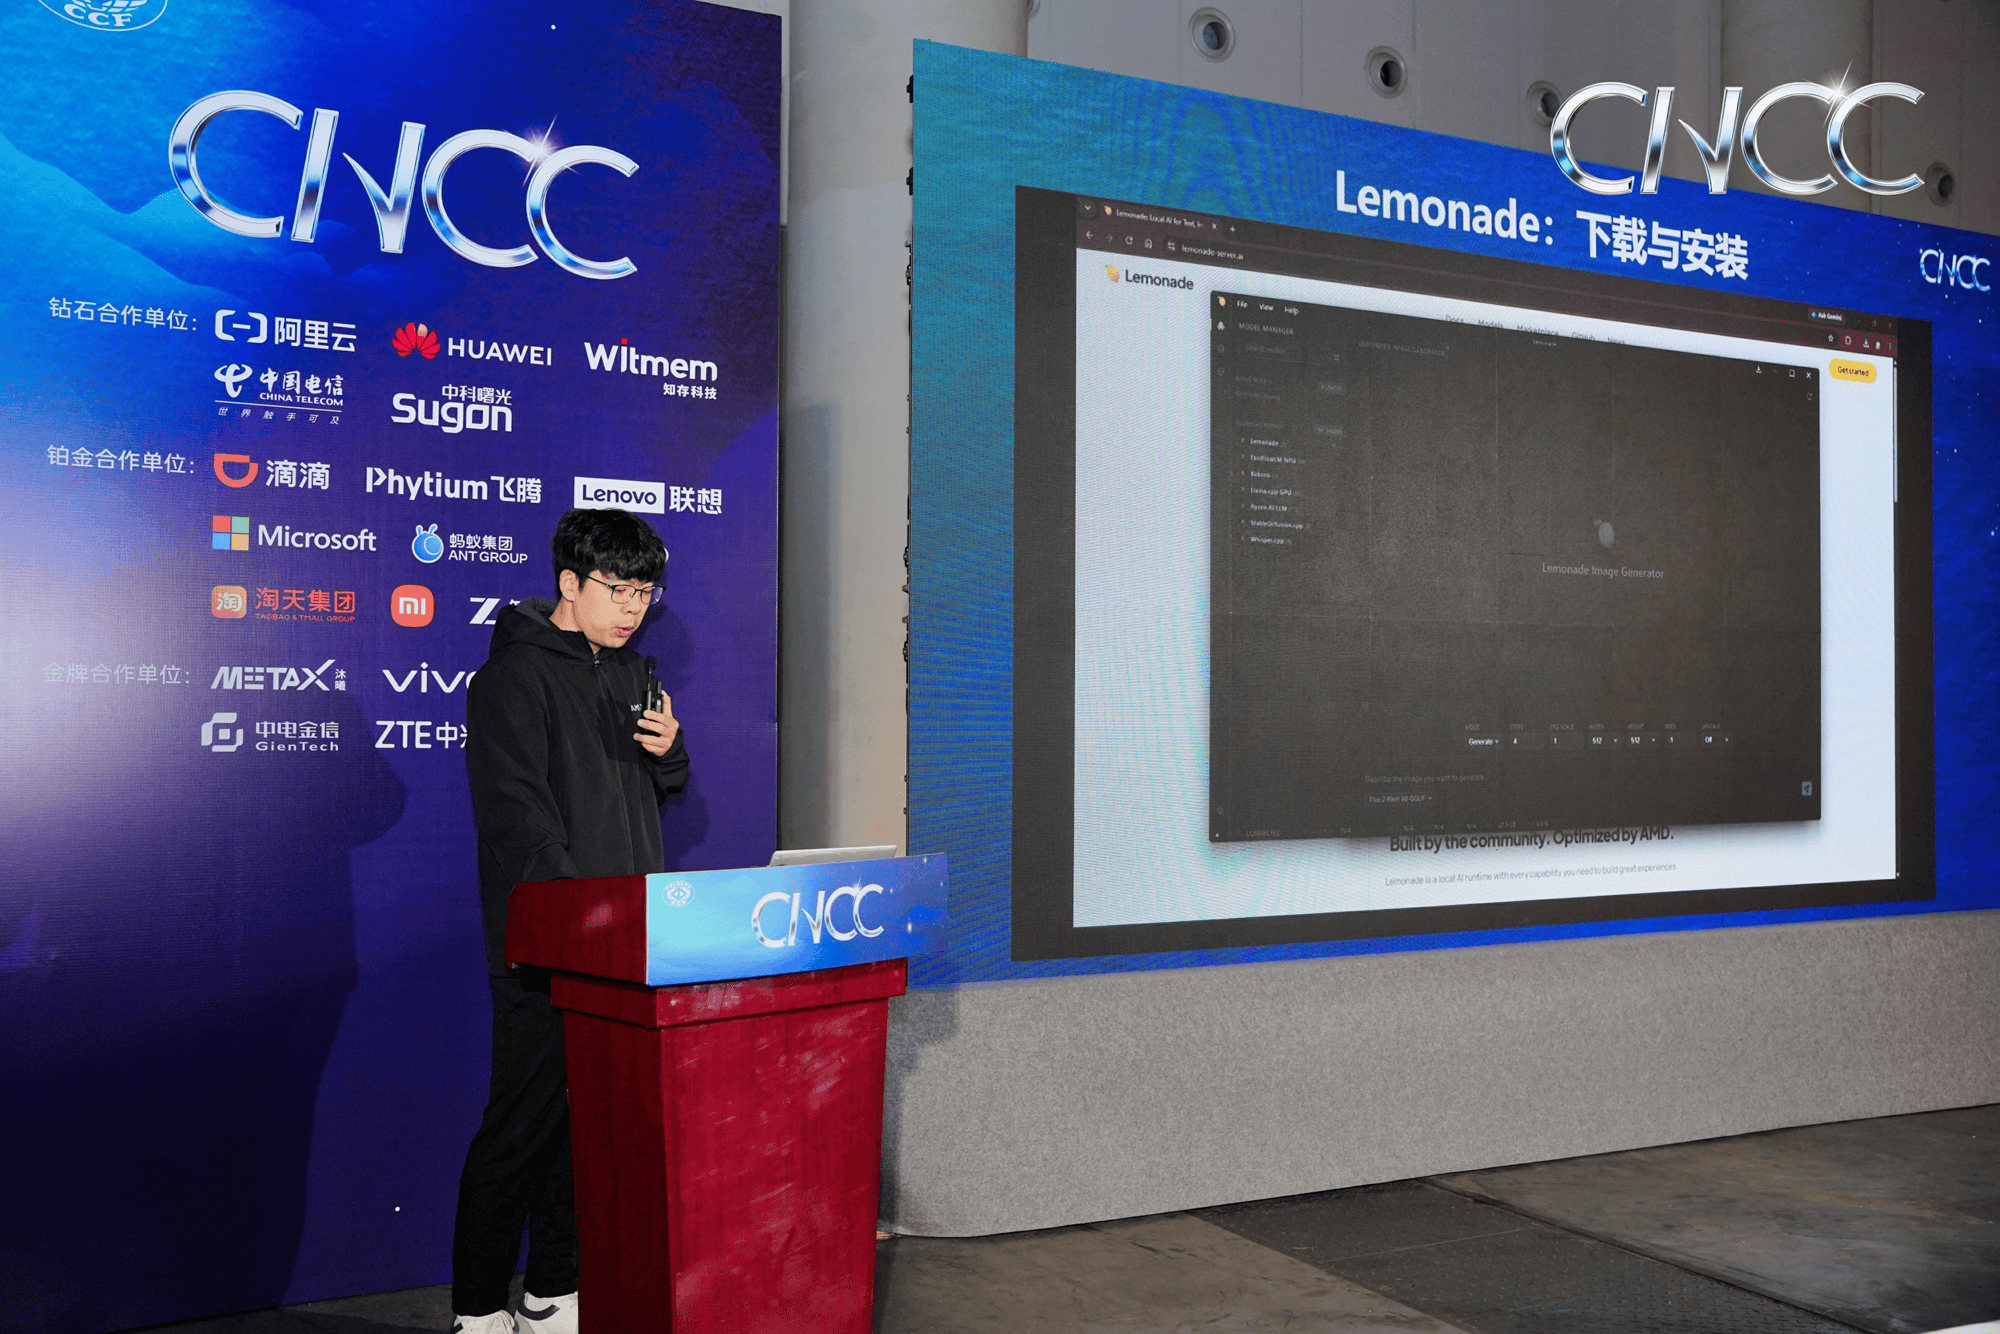
(图注 AMD ISV 部门 AI 技术负责人杨广远)
AMD嘉宾杨广远从计算平台出发,介绍了端侧模型应用的软硬件实践。他认为,随着智能体进入更多日常工作流程,持续增长的推理需求使端侧计算具有更重要的应用价值。
将适合的任务放到本地运行,有助于降低对云服务的依赖、改善响应速度,并减少部分持续调用带来的运营成本。但端侧AI能否发挥作用,还取决于模型效率、软件适配和硬件调度。
杨广远重点介绍了CPU、GPU与NPU的协作方式:CPU承担系统调度和部分轻量任务,GPU处理算力需求较高的任务,NPU则适合实时音频、后台感知等持续运行、重视功耗的场景。
例如,在一个同时需要语言理解和语音处理的应用中,可以将不同任务分配到适合的计算单元上,使其并行运行,提升整体资源利用效率。
围绕这一方向,AMD通过运行时、推理框架、量化工具和开发示例等软件支持,如Ryzen AI、Lemonade、FastFlow LM等,帮助开发者将模型部署到终端设备。其落点是:让AI PC等设备已经具备的算力真正被应用调用,并转化为用户能够感受到的体验。
从组织内部的Agent协作,到任务表达、可信治理、端侧算力与用户产品,本次论坛呈现了AI落地所需的多方面能力。“从Token到价值”的具体要求,是让每一次技术投入都更接近可靠的任务交付、可感知的用户收益,以及能够持续运转的商业模式。
如何持续服务好用户,创造稳定的用户价值,是整个行业要关注的核心问题,依赖于AI行业从最底层的芯片层,到最接近用户的应用层持续的优化和不断的创新。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”