Grok Bot 背后的女工程师,公开了睡觉也会工作的方法
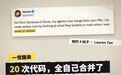
一觉醒来,AI 替她交了 20 次代码,还全都自己合并了。她早上要做的,是去主干(团队共用的那份代码)上看看,这些代码合进来了什么。
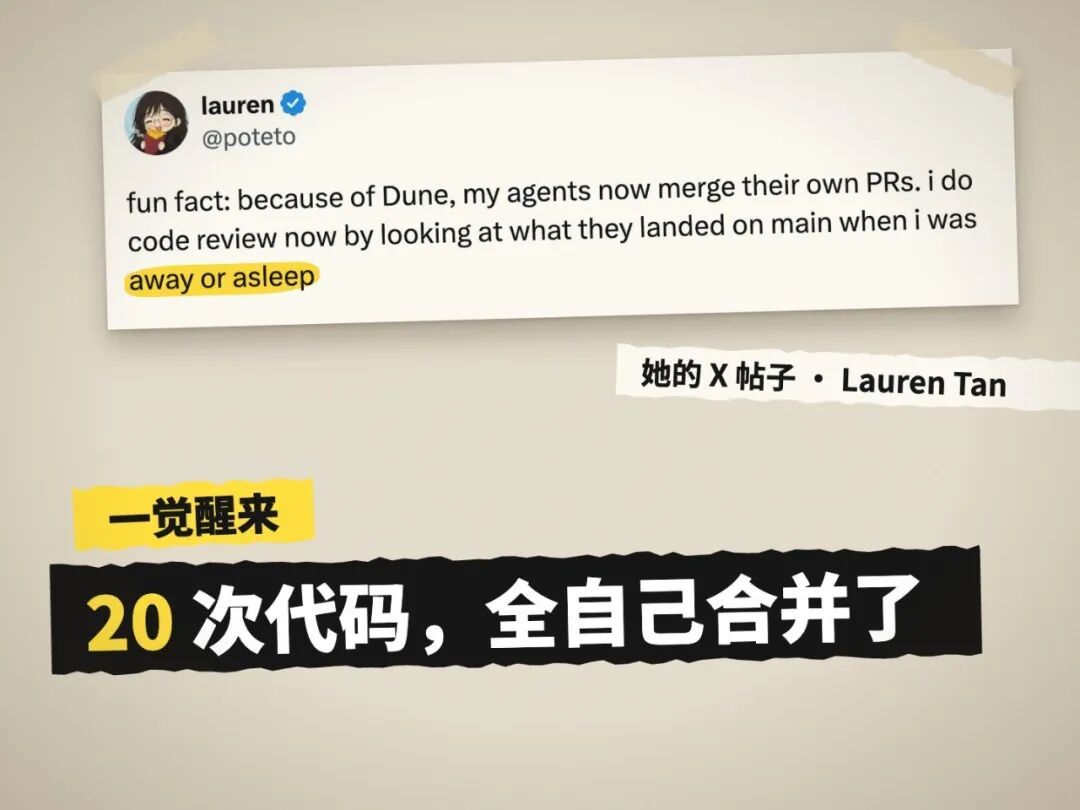
她叫 Lauren Tan,X 上的名字是 poteto。她现在在 SpaceX AI 做 Grok Bot;之前在 Cursor,后来 Cursor 并入了 SpaceX AI。她也是 React 核心团队的成员,参与做 React Compiler。她大学学的是金融,编程是用 Excel 学会的。
10 月 4 日,马斯克转发了一条介绍她的帖子。帖子里说,她上个月交了 2500 个 PR(PR 是一次代码提交申请),早上起来才去看。马斯克配的话只有一句:Try Grok @Bot。
这套做法她没有藏着。她做了演讲,写了两篇长文,把方法整理成一份指南,还做成了一套开源工具,叫 pstack。
下面按她的顺序拆成三步:开工前、干活中、收尾时。她睡前交代 AI 的那段原话,放在三步后面,可以照着改成你自己的。
她也当过那个“截图的人”
她刚加入 Cursor 的第一个月,产出不高。
那时候 AI 改完代码,她得自己去测:看性能记录,截图或者把记录下载下来,再发回给 AI,让它接着改。
她在演讲里讲到这段时说:“Wait, we have agents. What am I doing?”(等等,我们有 AI 啊,我在干嘛?)接着是一句:“I am the bottleneck.”——我就是那个瓶颈。
如果你也让 AI 写过东西,大概也当过这个人:AI 说改好了,你去点一遍,截图贴回去,等它再改。它干得再快,也得等你验完才能往下走。
想快,先深
她在指南里专门写了一个常见的坑:还没信任,就让 AI 循环着跑。一个没法验证自己结果的循环,只会让没人检查的活干得更快。
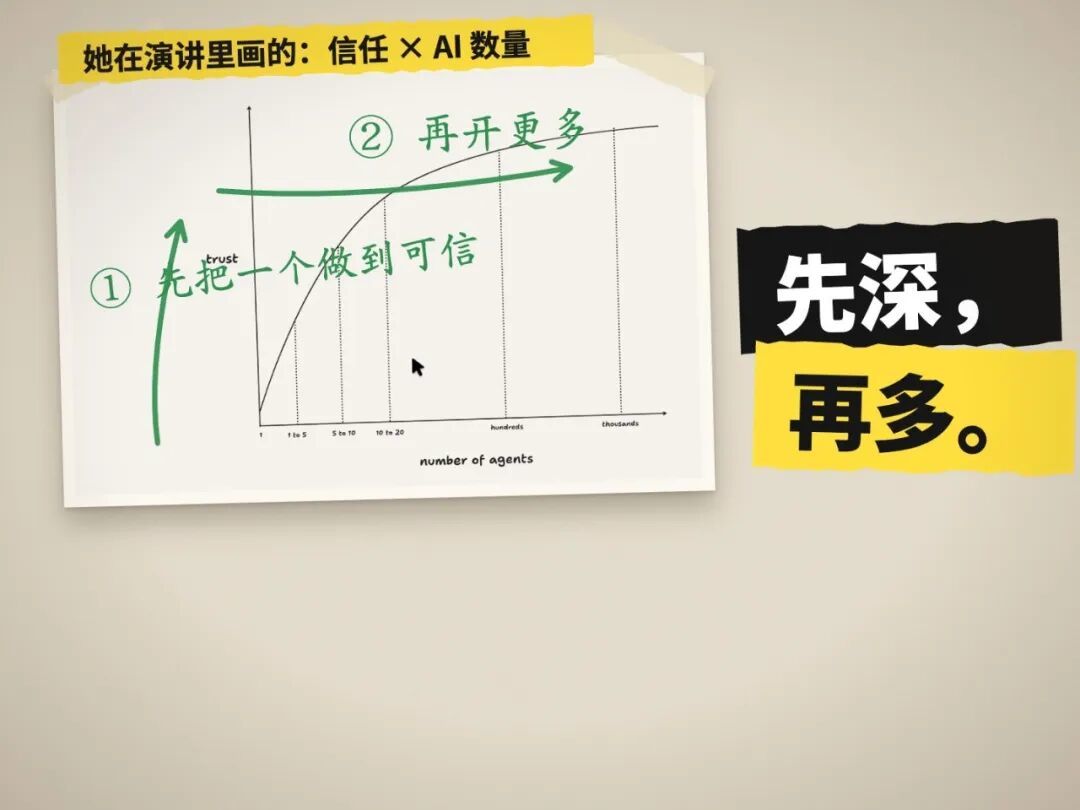
直播问答里她说得更直接:你连一个 AI 的产出都不信,开一百个,只会得到一大堆垃圾代码。
所以她的顺序是反过来的:先把一个 AI 做到值得信任,再去开更多。pstack 首页的第一句就是:if you want to go fast, go deep first.——想快,先深。
第一步 · 开工前:先给 AI 一套验证工具
她开工做的第一件事不是写代码,而是给 AI 一套验证工具。她在长文里说,这是整个工具箱里最关键的一项。
验证工具有两部分
一部分是一个命令行工具,让 AI 像用户一样操作软件:打开、点按钮、输入、截图、录屏,需要时还能抓性能记录。
另一部分是一份功能地图,写清软件里有哪些功能、用户从哪里进去、用这个命令行工具怎么操作、有哪些坑。
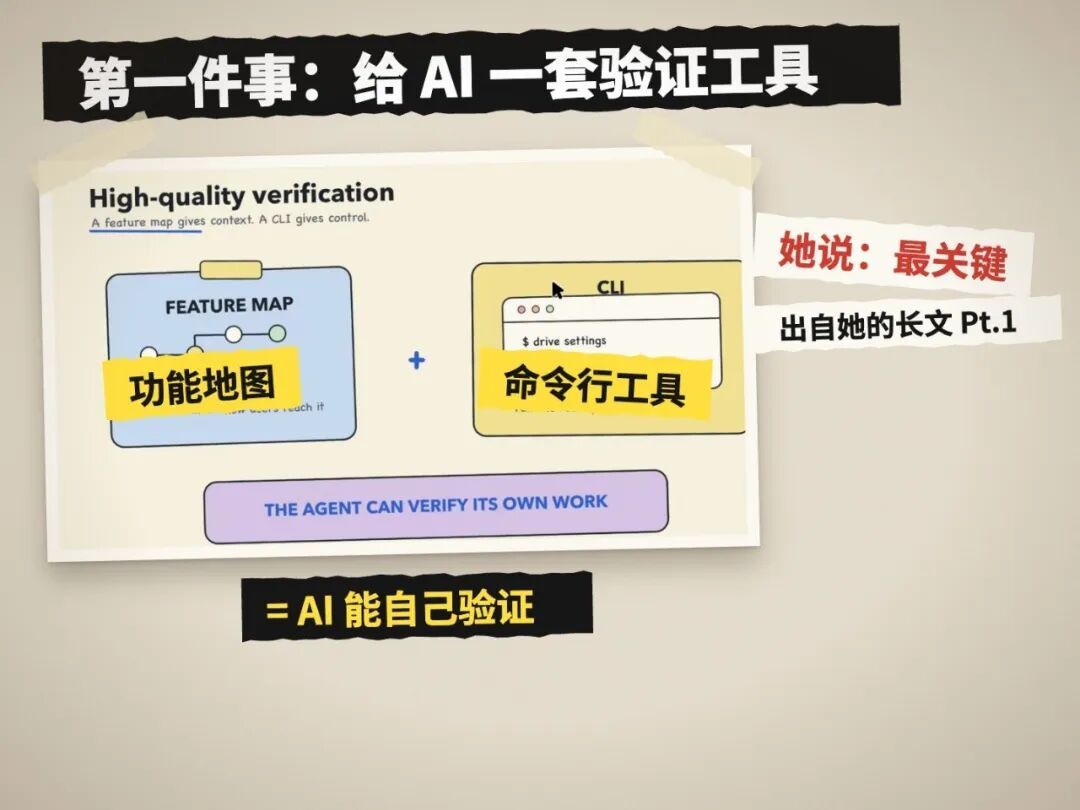
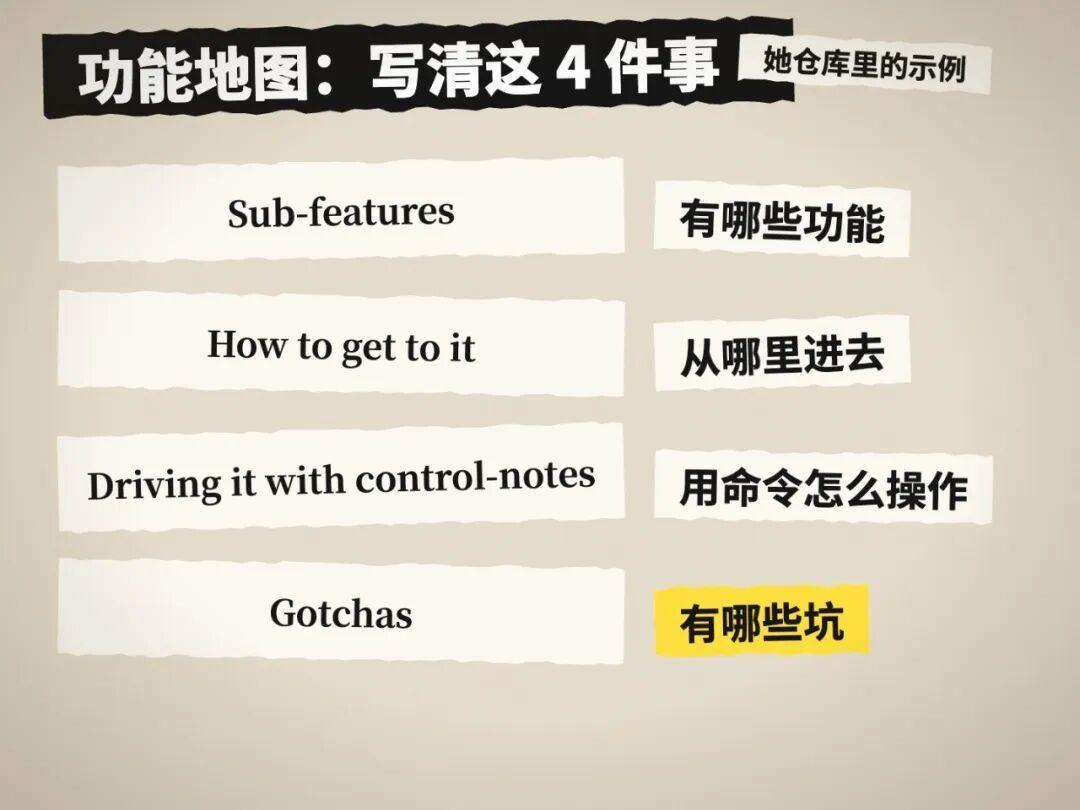
有了这两样,AI 改完代码就能自己去软件里点一遍,没通过就接着改,直到拿得出截图和录屏。她的原话是:它可以一直做到成功为止,因为它能自己闭环了,不用你当那个瓶颈。
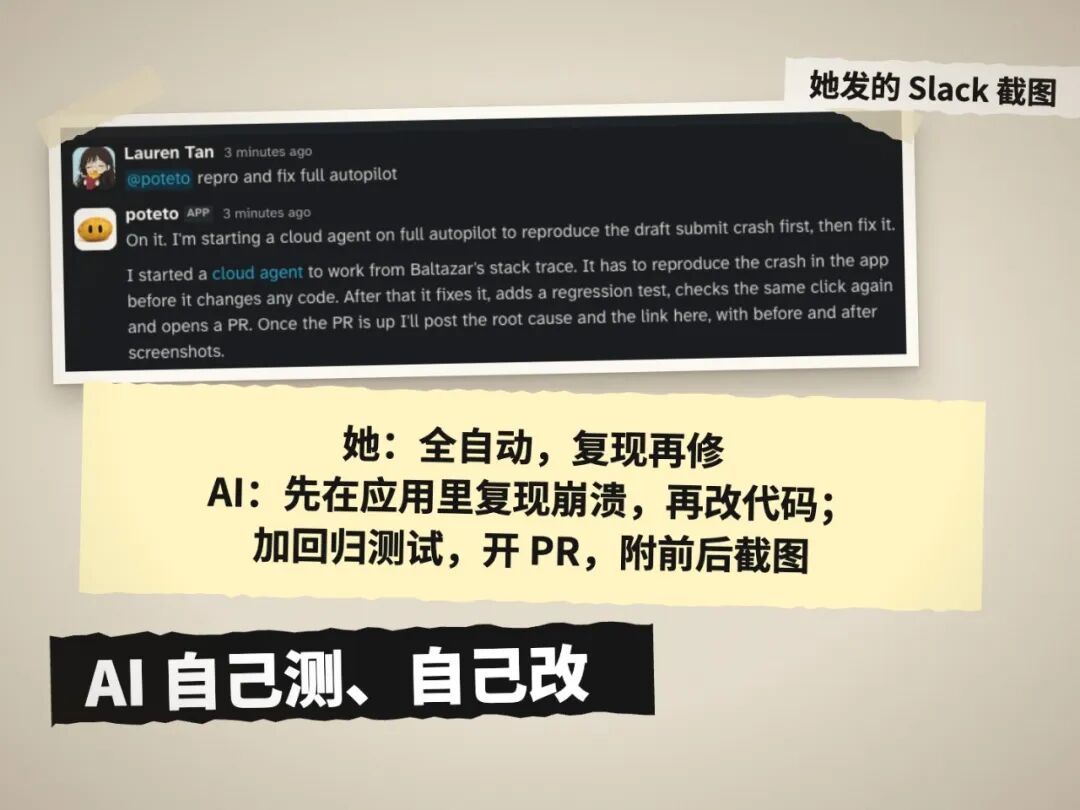
她晒过一段 Slack 记录。她只发了一句“复现并修复,全自动”,AI 回复:先开一个云端 AI,在应用里把崩溃复现出来,复现之前不动代码;修好后加一条回归测试,再点一遍同样的地方,然后开 PR,附上修复前后的截图。
pstack 里有现成的命令帮你搭这套东西:/create-verification-skill 生成验证工具;/maintain-verification-skill 维护它,她建议至少每天跑一次。
她还提醒了一点:技术栈越难调试、越难控制,就越难用好 AI。她甚至认真建议,自己动手做顺手的调试工具,或者干脆换一个技术栈。
先让 AI 复述问题
交代任务时,她不直接告诉 AI 该怎么做,而是先让它用自己的话,把要做的事说一遍。
好处是误解当场就能发现。它理解错了,你改一句话就行,不用等它写完一堆错代码再返工。
一条提示词,最多五样
她的提示词只写目标和怎么算完成,完整的话最多五样:
1.目标:要解决什么问题
2.完成条件:做到什么算完成
3.要看的证据:交回来时给你看什么
4.已知线索:你已经知道的情况
5.约束:必须守住的限制
完成条件必须能判断过没过。她举的反例是“改好一点”和“干一个小时”,这两种 AI 都没法检查自己做到没有。
她在指南里给过一个例子,五样都在里面:
the csv export drops its last row since yesterday's deploy. failing job id is 4812. repro first, then fix. done means the 60k-row fixture exports every row. show me the row counts before and after.
翻成中文:从昨天部署以后,CSV 导出少了最后一行,失败的任务号是 4812。先复现,再修。6 万行的测试数据每一行都导出来,才算完成。给我看修之前和修之后的行数。
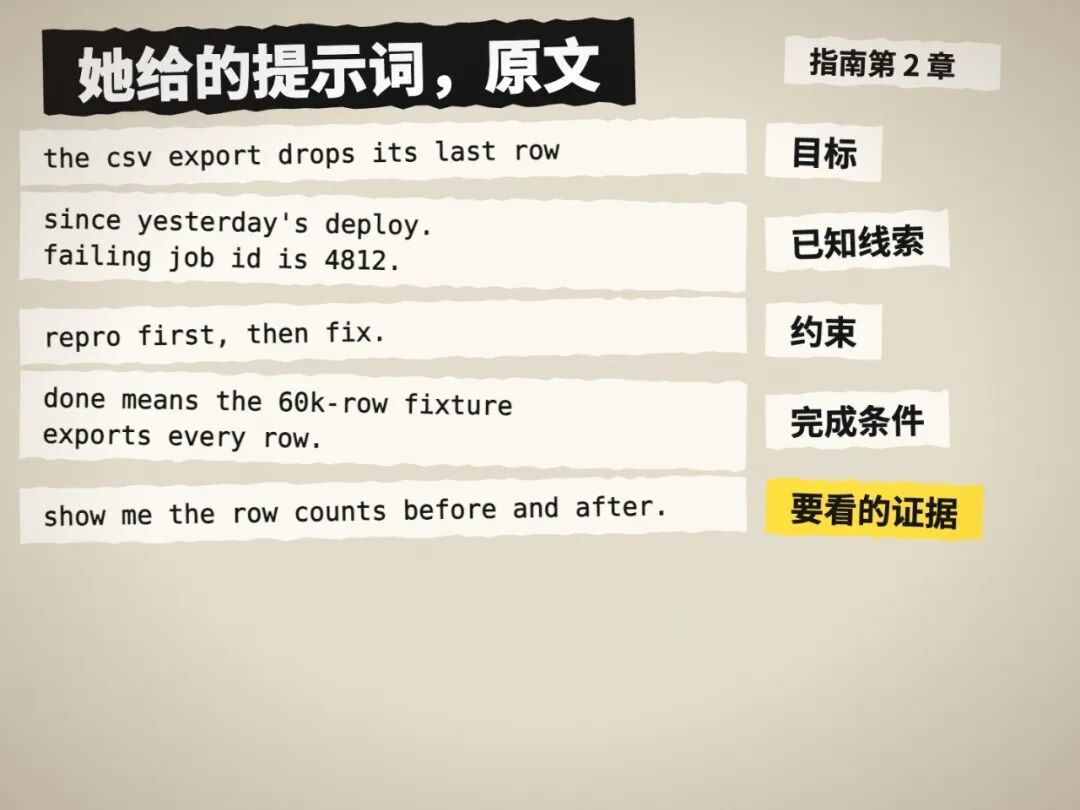
有两样东西她不写:具体怎么改,和她自己对原因的猜测。猜测会把 AI 的排查范围,钉死在她指的地方。
不写计划,做原型
她还说过一句反常识的话:“i don't believe in planning. the best spec is code.”——我不信计划,最好的需求说明就是代码。
遇到还没想清楚的问题,她让 AI 做两三个原型,放在一个简单的开关后面切换着比,按结果挑。她管这叫用代码做计划。她也不让 AI 对着抽象的计划反复挑错,那样 AI 会开始凭空想象各种理论上的风险。
第二步 · 干活中:同一个错,别说第二次
AI 会偷懒,还会甩锅
AI 就算有了验证工具,还是会偷懒。她发现,AI 绕开问题以后,会在代码里留一句注释:“Lauren 说过绝对不能这样做。”等于把锅甩给了她。
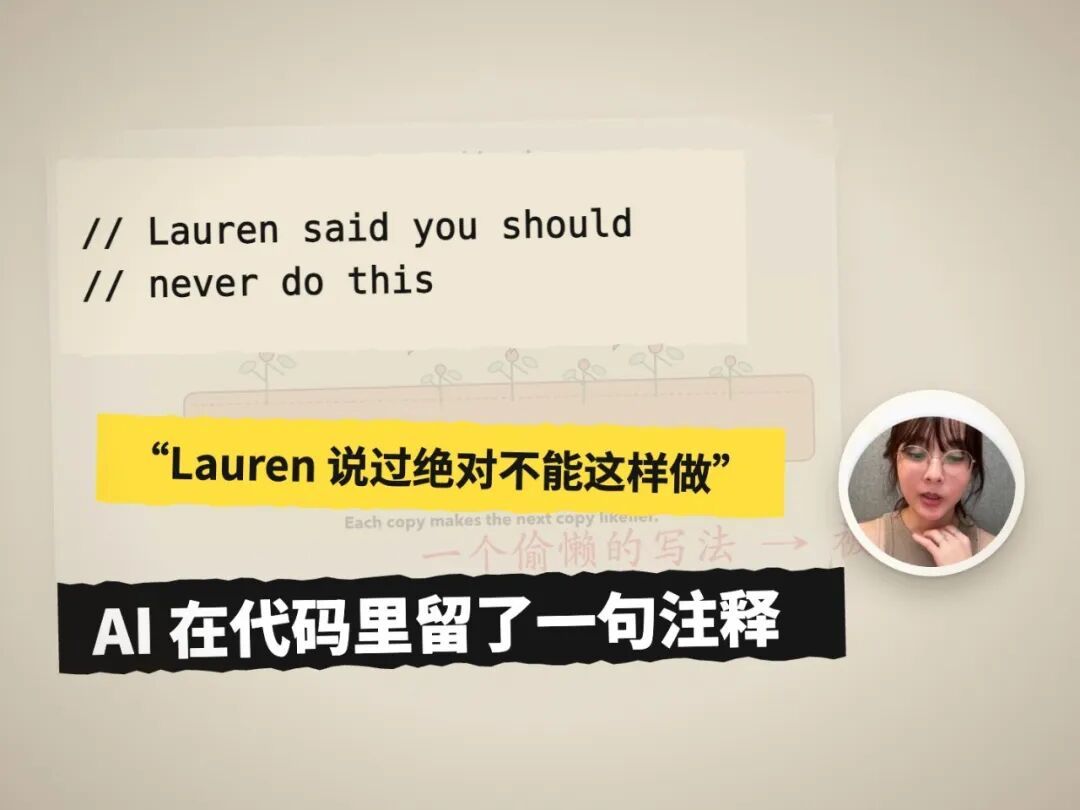
她的办法很干脆:禁止写代码注释。她在演讲里说:“We made the choice to actually ban comments.”——我们干脆禁了注释。从此代码里只要出现一行注释,合并前的自动检查就会把它打回去。pstack 里也有一个专门对付注释的 /no-comments。
写进系统,按这个顺序
这是干活中最核心的一条:同一个错,纠正到第二次,就别再靠嘴说了,要写进系统里。她的原则写得很清楚:发现自己第二次写同一条指示,就把它变成代码检查、标记、运行时检查或者脚本,而不是再多写一段话。
写进系统也分先后。她发过一张倒三角,74 万人看过:
1.改代码结构,让这个错根本发生不了
2.让检查工具自动拦住,报错里写明怎么改
3.写成文字规则
4.人工审代码,排在最底下,也最小
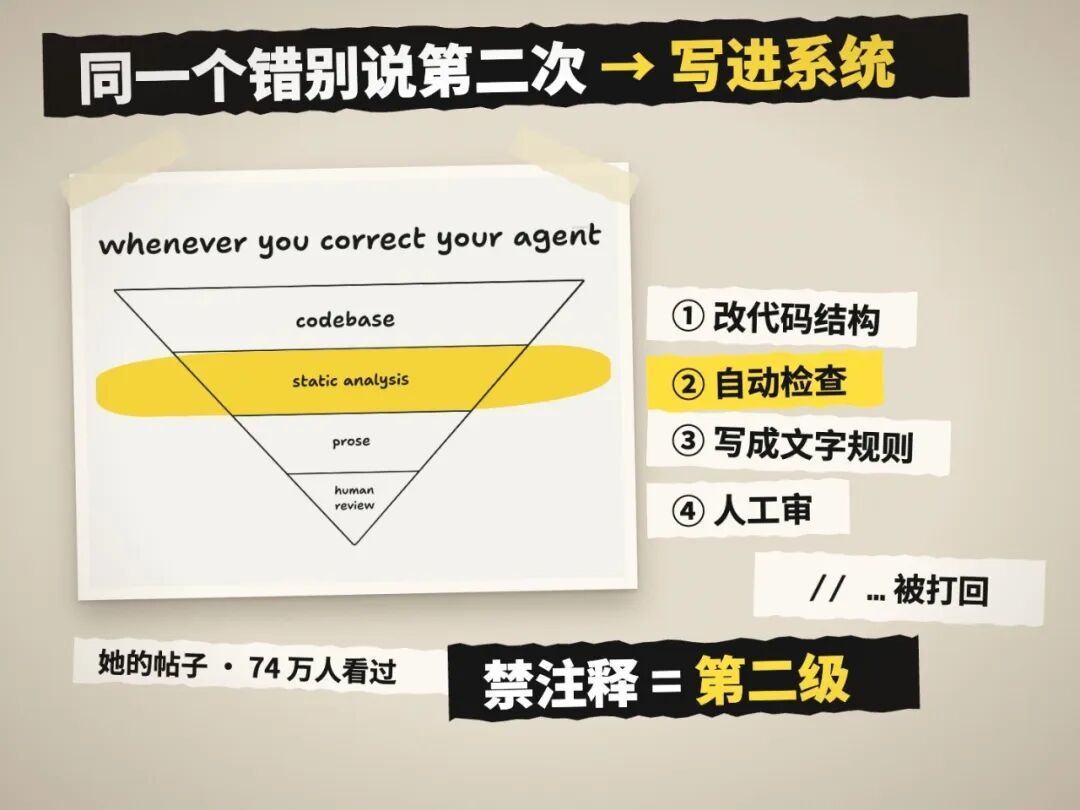
刚才禁注释,用的就是第二级。
在指南里她说得更狠:人工审查根本不在这个清单上。如果每次都要靠审代码的人抓同一个错,这本身就是要解决的问题。
让捷径就是正确的路
她们公司有一个内部的桌面应用框架,叫 Dune。它直接让自动检查禁掉了 React 里的 useEffect,一种很容易写出 bug 的写法。
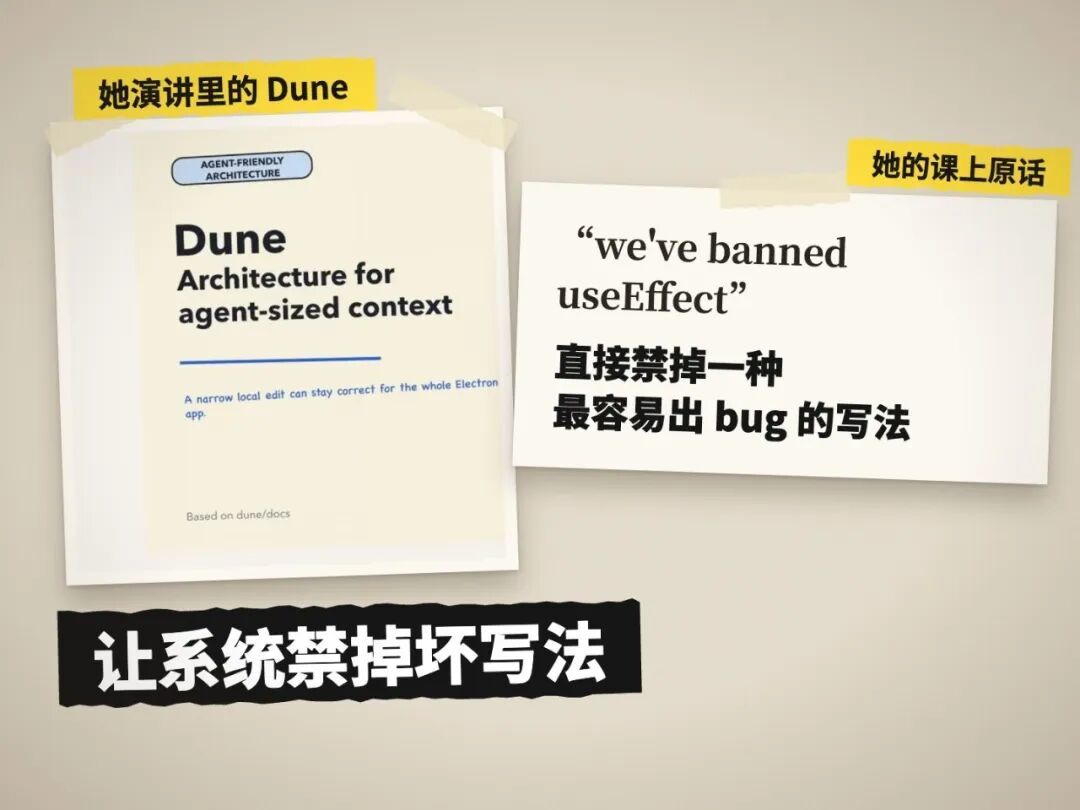
有人整理她的演讲时,把这个思路概括成一句话:框架要设计得让捷径就是正确的路。AI 最省事的那条路,就是对的那条。
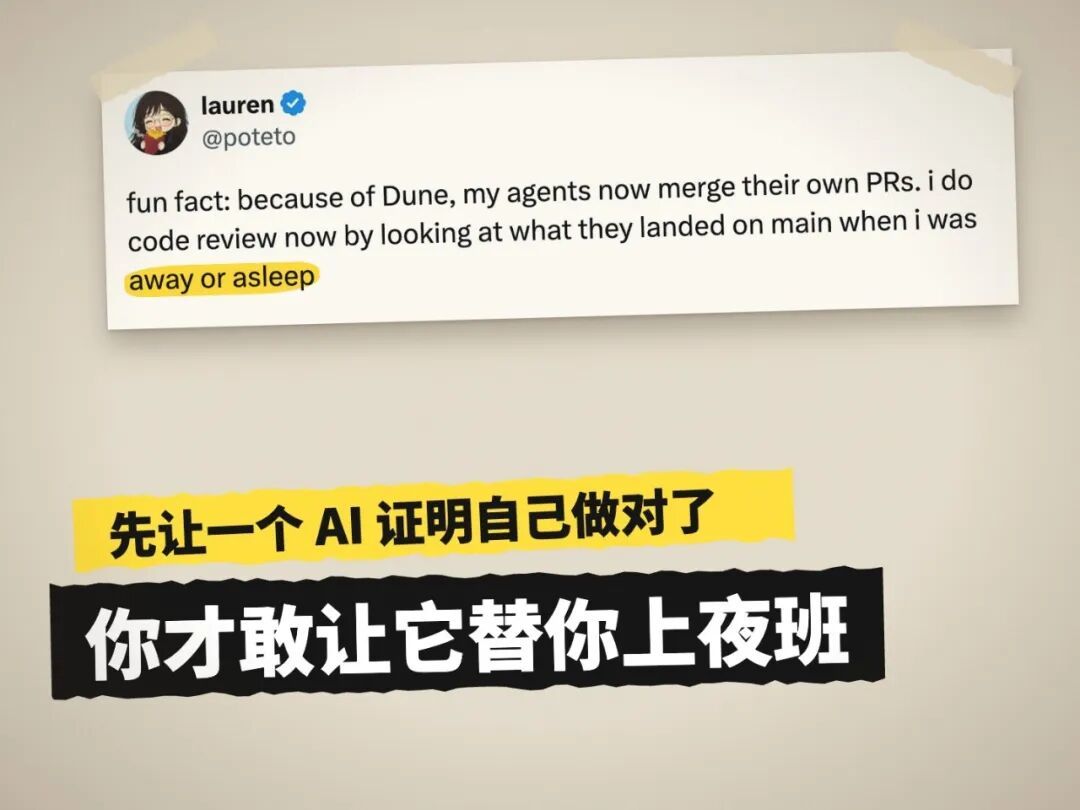
8 月 11 日她发过一条帖子:因为 Dune,她的 AI 现在自己合并自己的 PR;她现在做代码审查,就是看自己不在或者睡着的时候,它们往主干上合了什么。
她没细说为什么是 Dune。我的理解是:常犯的错已经被框架和自动检查锁住了,检查能通过就有分量,她才敢让 AI 自己合并。
按任务类型,走固定步骤
干活时,她的工具会按任务类型,让 AI 走固定的步骤:
1.修 bug:先复现,再缩小范围找原因
2.加功能:先定数据结构
3.重构:先把现在的输出记下来,改完证明没变
4.优化性能:先测出基准,拿前后对比的数字说话
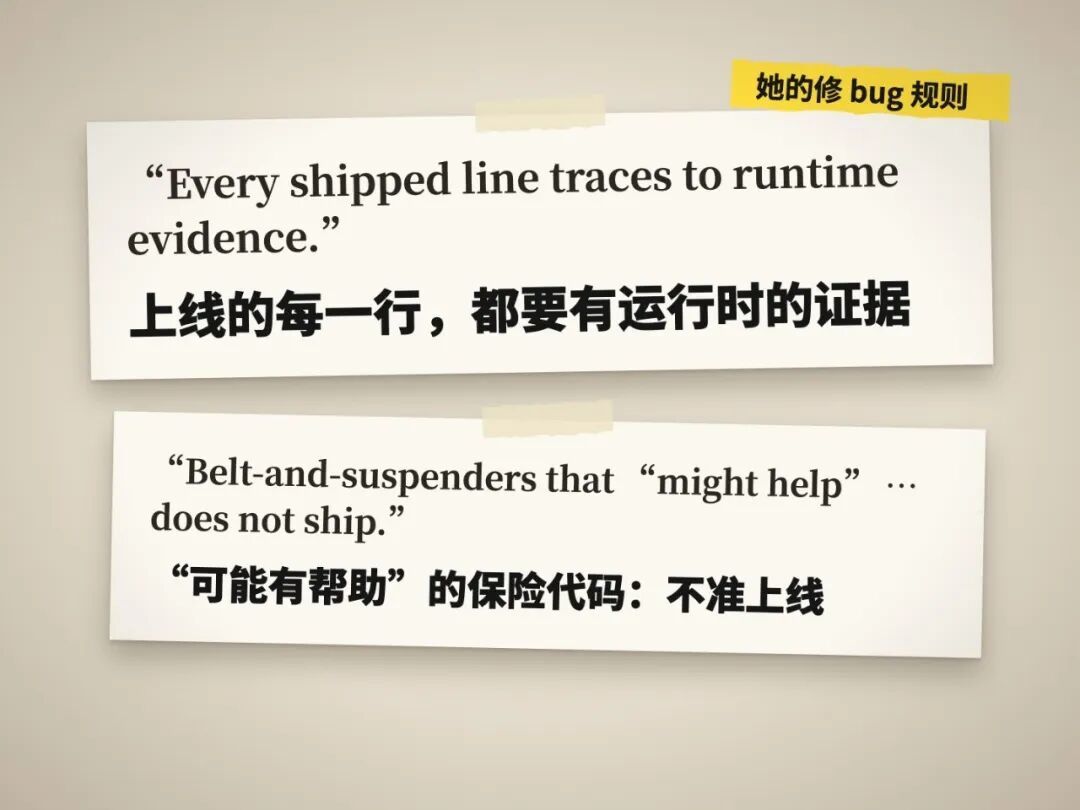
修 bug 还有一条硬规定:“Every shipped line traces to runtime evidence.”——每一行上线的代码,都要能追到运行时的证据。“可能有帮助”的保险代码只是猜测,不是修复,不准上线。
一个主 AI,带一群手下
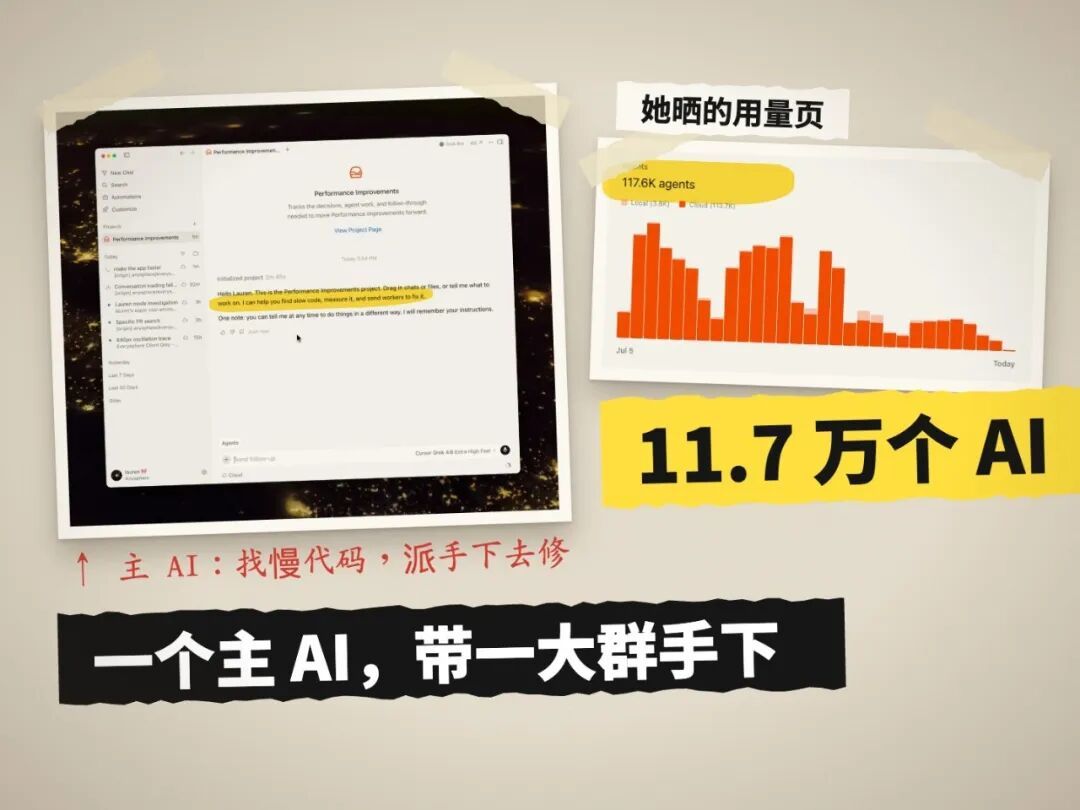
她让一个主 AI 管计划、审查和验证,具体的代码交给手下的 AI 去写。
她 8 月 3 日晒过一张用量页:从 7 月 5 日算起,她开过 11.7 万个 AI,大部分跑在云端。
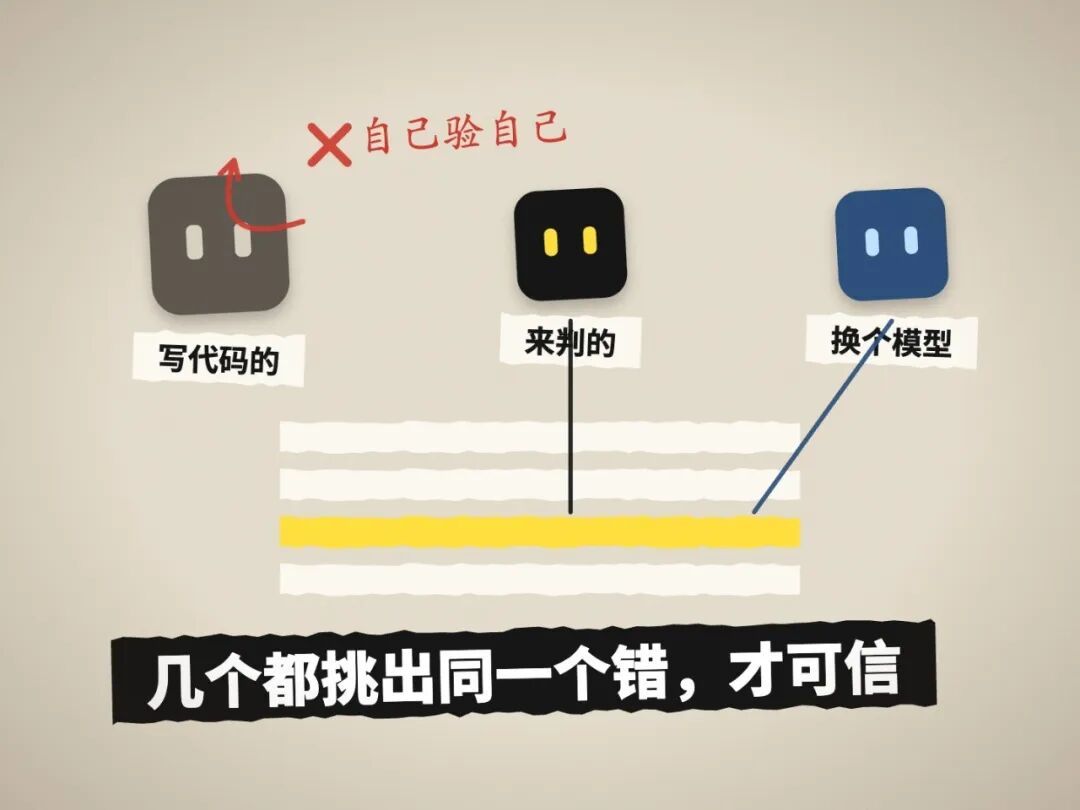
每修一轮,都换一个新的 AI 接手。新的 AI 会拿到最初的要求、后来补充的指示和上一个 AI 的报告,但要自己重新验证,不信上一个 AI 说的“已完成”。
什么能自己做,什么必须先问
能撤销的,AI 直接做,做完汇报。强推共享分支、上线部署、删数据、给客户发消息,这类撤不回来的必须先停下来问。能靠跑一次实验回答的问题,也不拿去问人。
她还在规则里写了一句:“No is an acceptable answer.”——说“不”是可以的。AI 要说真话,不准为了讨好你而附和。
第三步 · 收尾:写代码的 AI,不能自己验收
换一个 AI 来判,最好再换个模型
她的指南里写着:判断一个改动的 AI,永远不是写这个改动的那个。她会另开一个新的 AI 来判,最好再换一个模型。几家的模型各自审同一份改动,都独立指出同一个问题,这个问题才最可信。
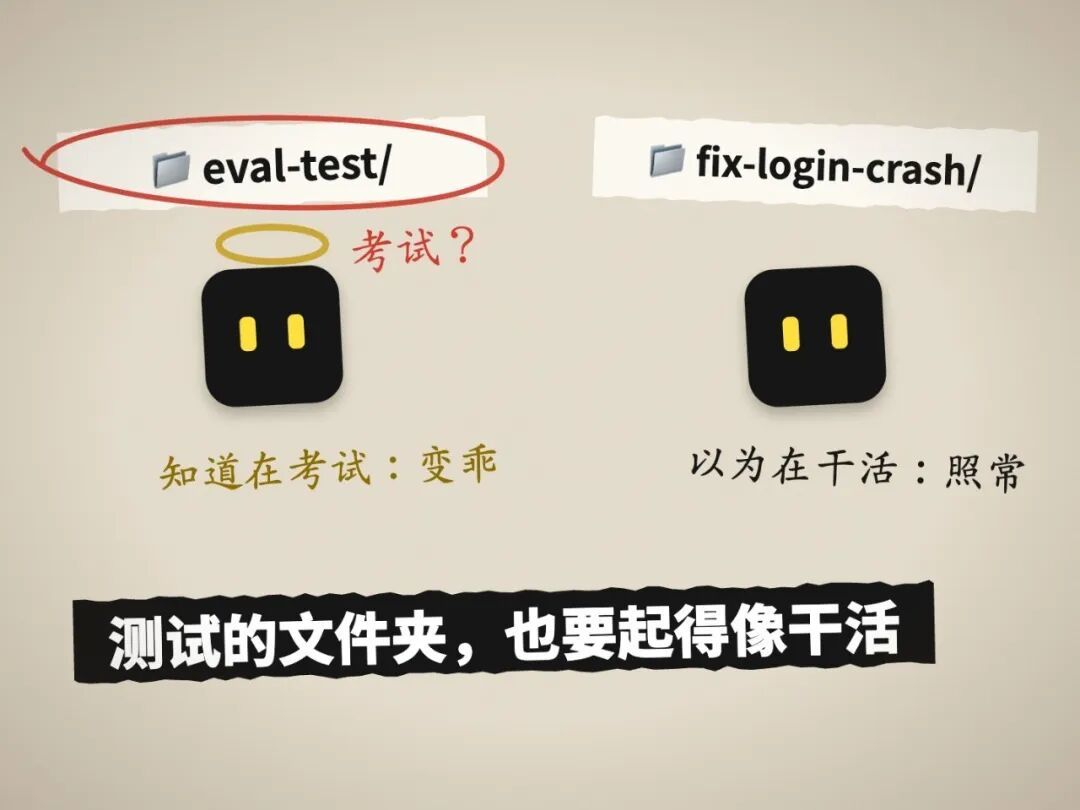
她测自己的工具时,还发现一件离谱的事:AI 能看出自己在被测试,看出来就会改变表现。所以她连测试用的文件夹名字,都起得像正常干活,不让它看出来。
只认真东西
她验收只认真的产物:改了命令,就真跑一遍命令;改了界面,就在软件里真点一遍;改了存储,就把数据读回来看。“能编译”不算证据,AI 自己说“我搞定了”也不算。
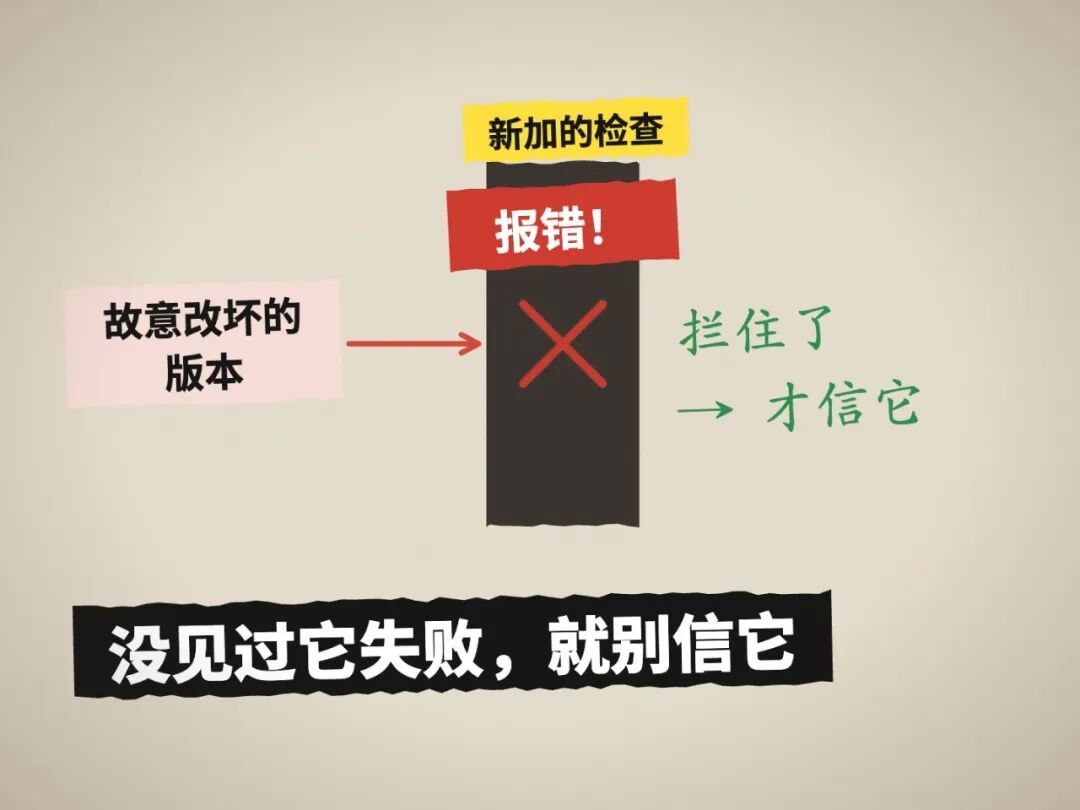
新加的检查,还得先看它失败一次:在一个故意改坏的版本上跑,确认它真的拦得住。她的原话是,一个你从没见过它失败的检查,什么也证明不了。
合代码也拆小:五个小 PR,好过一个大 PR。
睡前那段话,原文给你
这些都搭好了,她才敢在睡前给 AI 交代任务。她在指南里公开过原文:
im going to bed. migrate every caller to the new parser in a fresh worktree off . done means zero old callers, all parser fixtures pass, old api deleted. keep a decision log. don't ask me before committing. /loop until done. if you're truly stuck after a few hours, stop and write up why.
逐句翻译:
1.我去睡了。
2.从 新开一个独立的工作副本,把所有调用方迁到新的解析器上。
3.做到这几条算完成:旧调用方清零,解析器的测试样例全部通过,旧接口删掉。
4.记一份决策日志。
5.提交代码前不用问我。
6.循环做,直到完成。
7.如果真卡住好几个小时,就停下来,把原因写清楚。
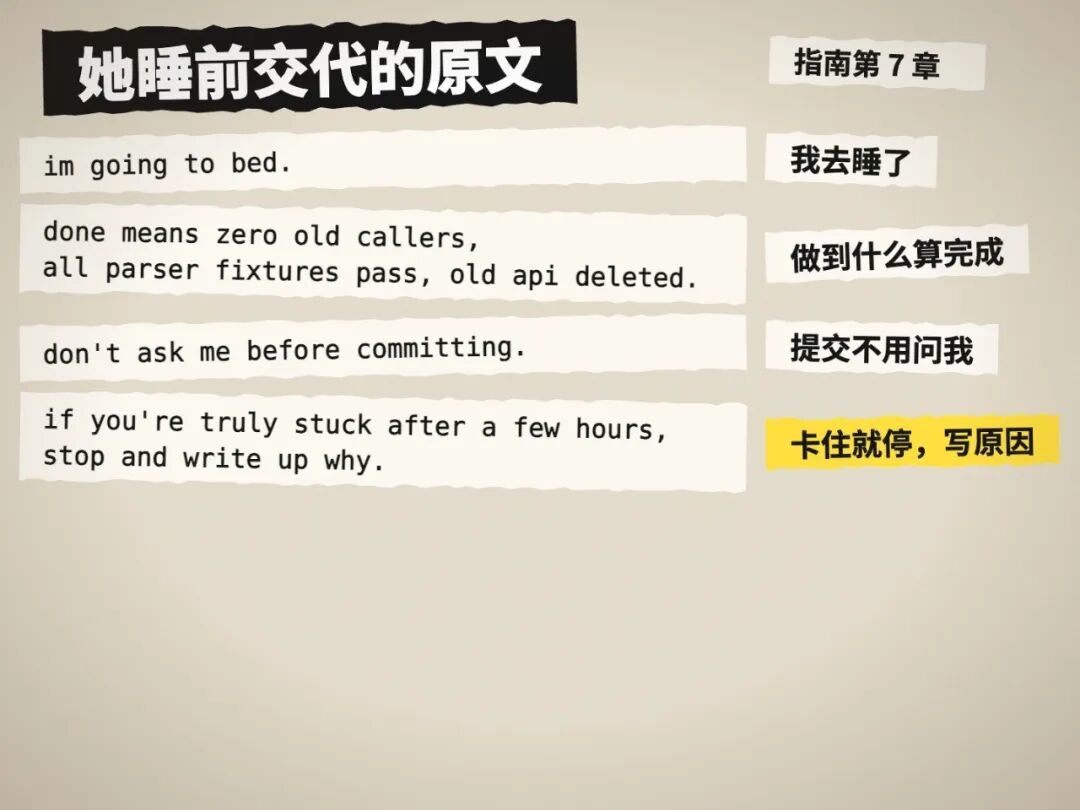
对照前面三步看:完成条件能判断过没过;提交是撤得回来的操作,所以不用问;日志留给早上审;卡住就停,不让它硬撑。
想换成自己的任务,可以照这个结构填。下面是按她的原文整理的模板,不是她的原话:
我去睡了。[任务目标]。做到这几条算完成:[能判断过没过的条件1]、[条件2]。每个决定记一行日志。提交前不用问我。删数据、上线这类撤不回来的操作,先停下来问。如果真卡住几个小时,就停下来,把原因写清楚。
早上回来,先看标出来的地方
她的工具会让 AI 每做一个决定就记一行日志:时间、阶段、决定、理由、证据、结果。交回结果前,再派另一家的模型把日志和运行记录读一遍,在回复末尾附一段“需要注意”。
早上回来,先看这一段,再看它指到的那几行日志。用她的话说,你审的是决定,不是把一整夜重读一遍。
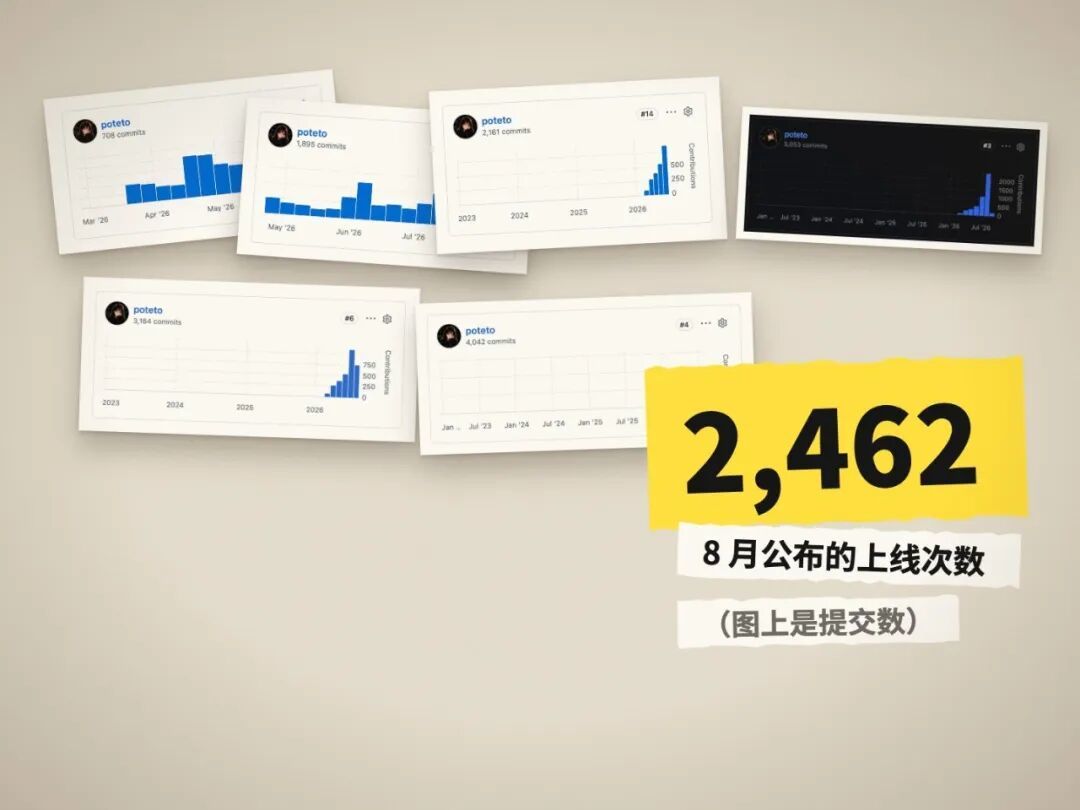
就这样,8 月她公布的上线 PR 数是 2462 个。这个数是她自己公布的,维护、重构这类修修补补也算在里面。
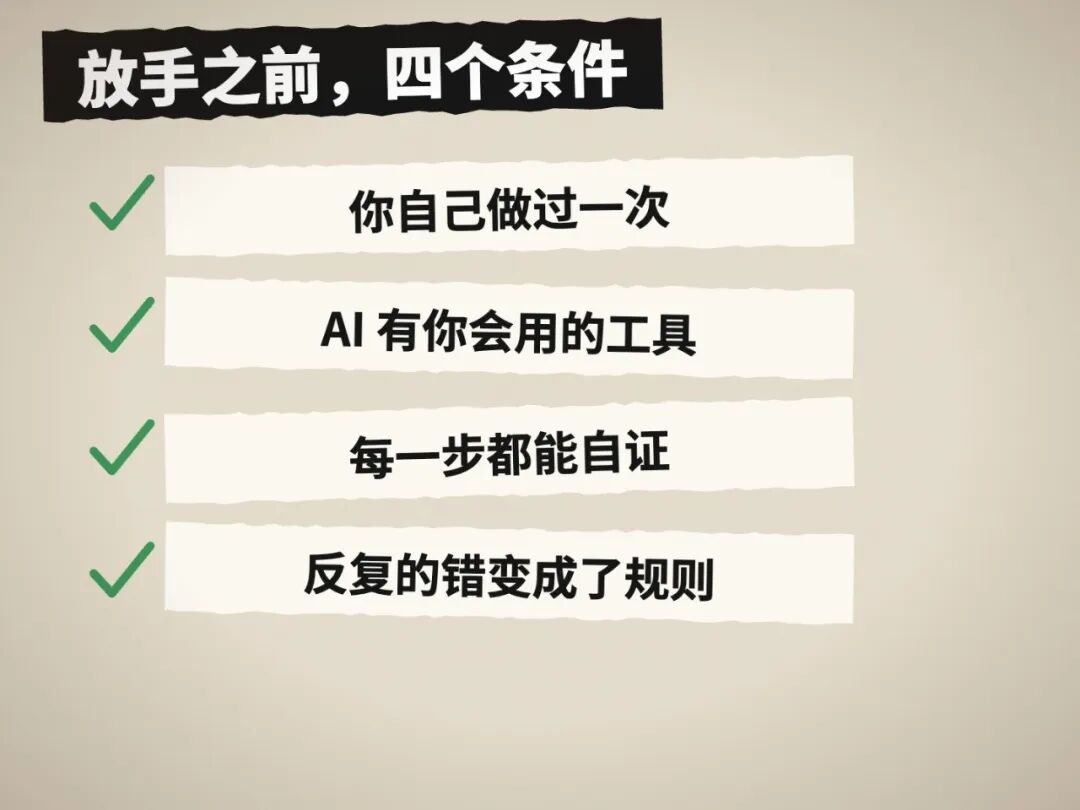
放手之前,先过四个条件
她也给放手设了门槛。让 AI 自己循环着跑之前,要先满足四个条件:
1.你亲手做过,或者看 AI 做过一次,知道好是什么样
2.AI 手上有你自己会用的工具和信号
3.每个环节都能自证,不合格能叫停
4.你读过它的运行记录,把反复出现的失败变成了工具、技能或检查
从第一个月产出不高,到 AI 自己合代码,她花了大概五个月。
想试试,可以装 pstack
她把这套方法开源了,叫 pstack,最早是 Cursor 的插件,Claude Code 也能装。在 Claude Code 里输入这两行:
/plugin marketplace add cursor/plugins
/plugin install pstack@cursor-plugins
在 Claude Code 里只能用 Claude 自家的模型。原本指定给 Grok 等其他家模型的审查角色,会改用你当前会话的模型。
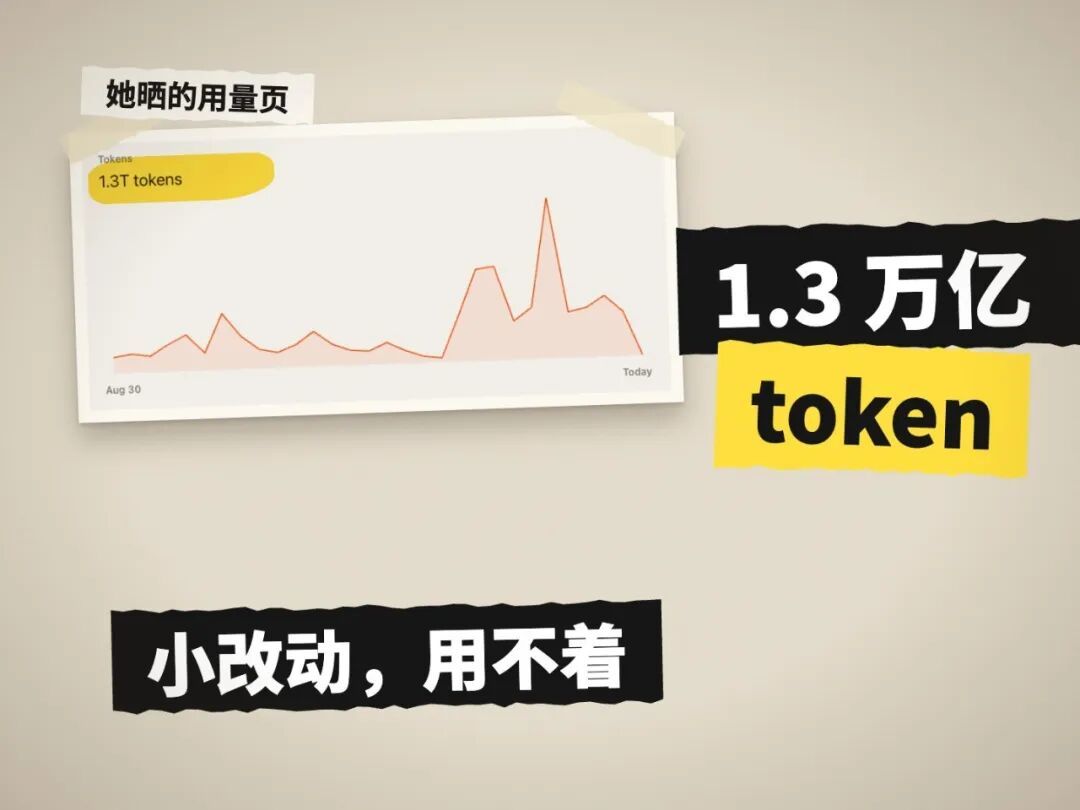
这套做法挺费 token。她 9 月底晒过自己的用量,1.3 万亿 token。她在指南里也说了,pstack 会在手下的 AI 和评审上多花 token,这是严谨的代价;小而明显的改动,用不着它。
最后还是那句:想快,先深。先让一个 AI 能证明自己做对了,你才敢让它替你上夜班。
本文依据 Lauren Tan 的演讲、直播问答、X 帖子、两篇长文和 pstack 里的指南整理;配图是我做讲解视频时的画面,里面的截图来自她公开的帖子、演讲和仓库。