DeepSeek把成为斩杀线的本事也开源了



作者|董道力
微信|ddl941110
10 月 20 日,DeepSeek 开源了内部推理框架 DeepInfer。
DeepInfer 是干什么的?简单来说,它是一套让大模型跑得更快、更省钱的软件。大量用户同时向 AI 提问时,它负责安排计算任务,协调多张显卡一起工作,尽量减少机器空转和重复计算,让同样一批机器能服务更多人,用户也能更快得到回答。
这套框架已经在支撑 DeepSeek V4.1 Flash 的大规模服务。
DeepSeek V4.1 Flash 每回答一次问题,都要消耗算力。机器用得越充分,处理一次请求的成本就越低,也就有了更大的降价空间。这也就是为什么 DeepSeek 一直能提供低价 API 的原因之一。
就像很多公司下载了开源模型,但未必能做到同样的运行效率。
这次开源 DeepInfer,可以说 DeepSeek 把一部分支撑低成本服务的工程实现也交了出来。
不光如此, DeepSeek 还分享了一份以 DeepInfer 为核心,DeepSeek 怎样部署和运行 V4.1 Flash 的大规模推理服务。
1
DeepInfer 是如何运转的
DeepInfer 的优化,深入到了模型运行的每一步。
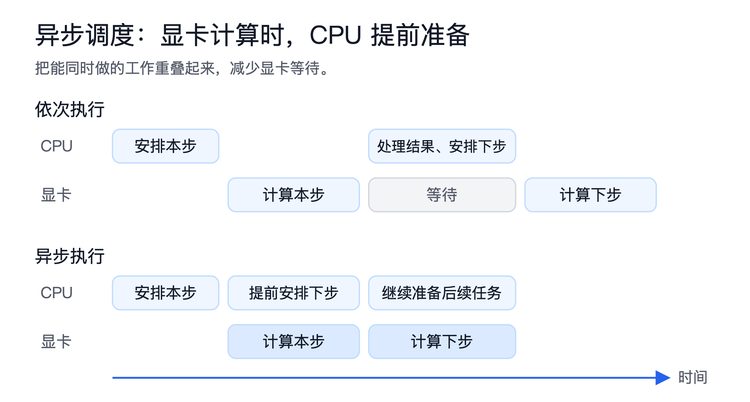
模型生成内容时,显卡负责计算,CPU 负责安排任务和处理结果。如果这些工作依次进行,就会造成显卡等CPU,等待期间,显卡发呆,算力却没有充分用起来。
DeepInfer 采用异步调度,让两边同时工作。显卡计算当前这批任务时,CPU 提前安排下一批,尽量减少交接时的空等。这类优化省下的时间很短,但模型生成一次长回答,要反复执行很多步,积累起来就会影响效率。
生成内容的方式,也有优化空间。
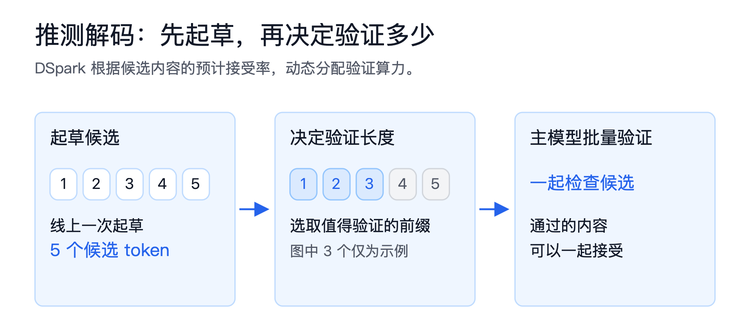
通常,大模型需要逐步生成 token。DeepInfer 使用的 DSpark 推测解码,会先起草几个候选 token,再交给主模型批量验证,通过的部分就能一起接受,减少逐步生成的开销。
DeepInfer 还会判断,这些候选内容值不值得全部验证。把算力花在很可能被拒绝的候选上,同样是一种浪费。因此,它会根据候选 token 的预计接受率,动态调整验证长度。报告显示,在 DeepSeek 的线上部署场景中,相比每次固定验证 5 个 token,这项改动提高了约 6% 的吞吐。
另一项更直接的节省,发生在处理输入的阶段。
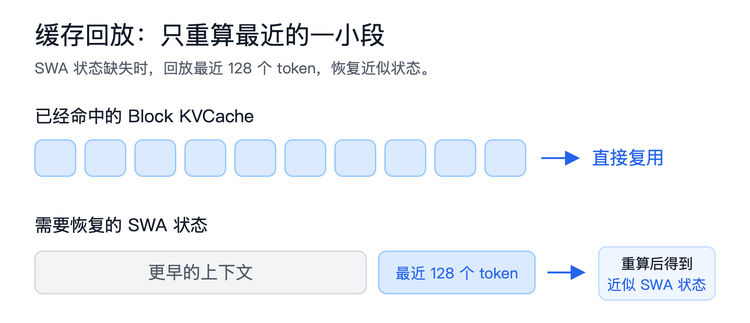
模型处理长文本时,会产生一些供后续计算使用的中间状态。其中一类叫滑动窗口缓存,如果需要恢复,精确重算的代价可能很高。DeepInfer 使用 SWA Bounded Replay,通过重算最近一小段内容来恢复近似状态。报告介绍的做法,只需回放最近 128 个 token。
这项机制也用于 V4.1 的解码部分,为开始生成回答准备所需状态。配合模型本身的架构,报告称它让输入处理阶段的总计算量近乎减半。省下的是这一阶段的计算,对于需要处理大量长文本的业务,很有帮助。
让显卡算得更快,只是大规模服务的一部分。大量请求同时涌进来,还得分配好任务,减少排队,也尽量避免把相同的内容反复计算。
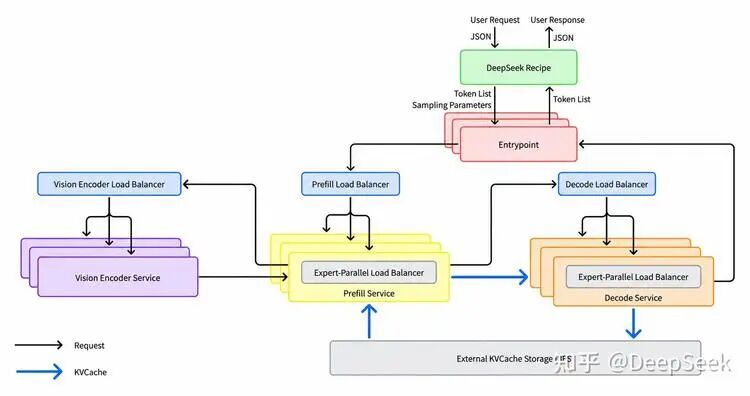
围绕 DeepInfer,DeepSeek 把处理输入和生成回答的机器分开部署,根据各自的负载调整资源。同时,系统把已经算过的中间结果存下来,后续请求遇到相同的上下文,就能复用一部分计算。显卡内部省下来的时间,要靠这些配套工作,才能变成整个集群的效率。
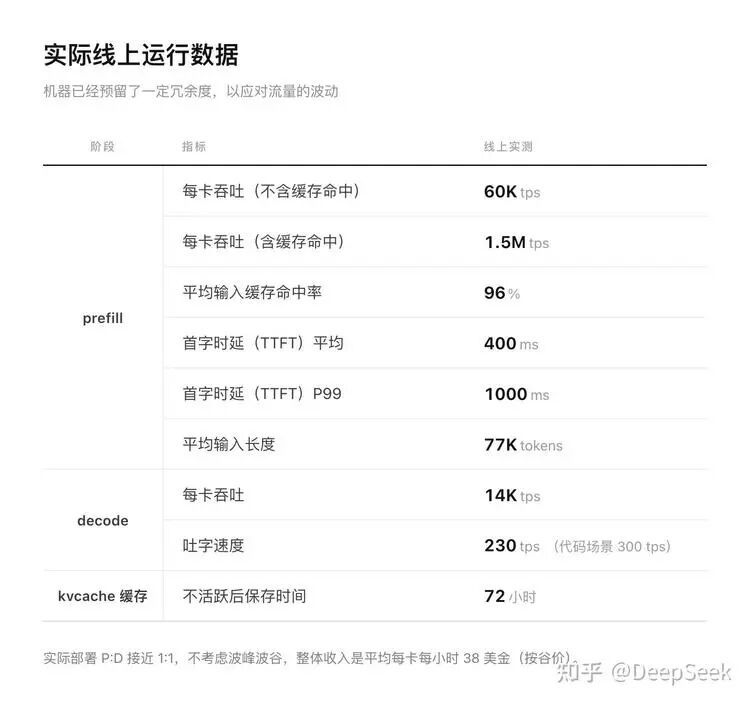
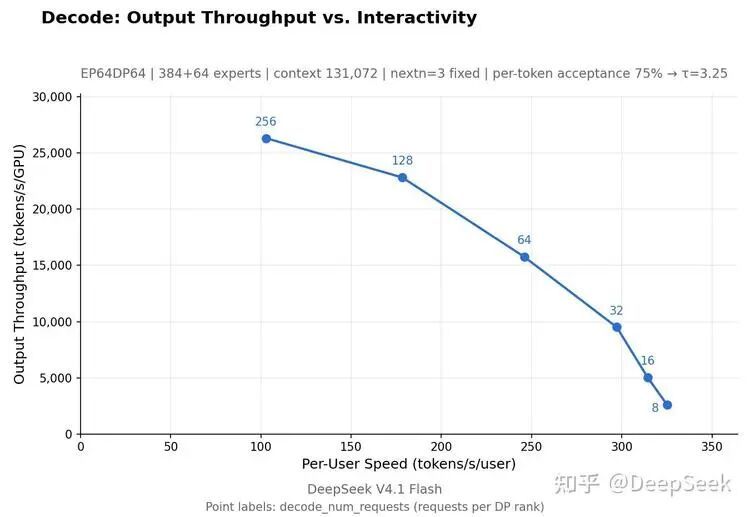
按照部署报告披露的数据,V4.1 Flash 单一集群每天的服务吞吐达到 155 万亿 token,平均约 0.4 秒开始返回结果,生成速度达到每秒 230 token。
这些数字来自 V4.1 Flash 的整套线上服务,是模型、硬件和软件共同配合的结果。
这也让 DeepInfer 的开源价值变得更清楚。其他公司拿到模型后,可以进一步研究 DeepSeek 怎样调度任务、减少重复计算,把已经用于生产服务的实现用到自己的部署中。许多原本要自己摸索、测试的工程问题,如今有了可以参考和修改的代码。
2
重新定义开源:把家底都开了才行
DeepInfer 的开源延续了 DeepSeek 一贯的做法。它公开的东西,已经从模型本身,逐渐深入到模型背后的工程系统。
最为人熟悉的是 V3 和 R1。模型权重开放后,开发者可以把模型部署到自己的服务器上,再按业务需要调整。
模型运行时,大量时间花在一些反复执行的基础计算上。DeepSeek 开放的 DeepGEMM 和 FlashMLA 就在优化这些地方:前者是高性能矩阵计算,后者主要处理注意力计算。
机器多起来以后,数据传输也会拖慢计算。DeepEP 优化了混合专家模型在多张卡之间交换数据的过程;训练环节的 DualPipe,则让计算和通信尽量同时进行,减少流水线上的等待。
连存储系统,DeepSeek 也拿了出来。开源的 3FS 把多台机器上的存储资源组织起来,为训练和推理提供高速读写。前面提到的缓存复用,就需要这类基础设施支撑。
到了这次,DeepInfer 把一部分已经开放的底层能力组织进推理引擎。同步发布的 deepseek-recipe,则负责把不同格式的 API 请求转换成模型能处理的输入,再把模型输出转换回相应的响应格式。这些细节做好了,其他团队搭建服务时就能少处理一些接口兼容问题。
开发者不但可以拿到模型,还能看到它怎样计算、怎样在多张卡之间传递数据,以及怎样把结果存下来继续使用。
一家模型公司的低成本,本来可以是只属于自己的优势。
同样的模型,自己运行得更便宜,就有更大的定价空间。同行即便拿到了权重,也得重新投入工程师和机器,摸索怎样把服务做好。
DeepSeek 却把其中一部分公开了。拿到代码的人,可能是做研究的学生,可能是为客户部署模型的公司,也可能就是它的竞争对手。
这就让开放更有分量。
DeepSeek 自己受益于这种协作。DeepInfer 的官方仓库写明,它早期主要基于 vLLM 构建,也借鉴了 SGLang 和 TensorRT-LLM。社区已有的工作帮它往前走了一程。
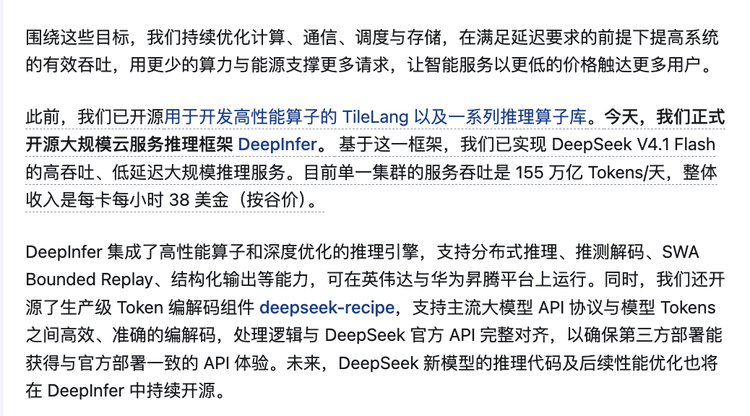
而这一次它把开源这事又往前推了一步。在开源的公告里,DeepSeek也透露了这个框架能有多赚钱:DeepSeek提到,基于这一推理框架实现 DeepSeek V4.1 Flash 的高吞吐、低延迟大规模服务,做到了单一集群吞吐155万亿Tokens/天,整体收入相当于每卡每小时38美元。
对 DeepSeek 自己来说,今天积累的工程优势,可以拿来保住一段时间的利润,但它看起来对此不感兴趣。它选择把“斩杀线”的秘方公开出去,这样的开源能让整个行业在更高的起点上继续竞争。
让更多的斩杀线出现,让AI的成本下降来的更猛烈些吧。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”