正面硬刚DeepSeek!MiniMax M3.1 Flash发布,输出卷到200+TPS,价格砍到1/2



智东西
作者 | 王涵
编辑 | 漠影
火爆AI圈的匿名模型Space Bunny,终于被认领了!
智东西10月19日报道,刚刚,MiniMax 正式发布M3.1 Flash,定位为Coding/Agent优化轻量级模型,拥有100万token上下文。
几乎前后脚,10月17日,DeepSeek V4.1 Flash-1017上线。(梁圣又掀桌了!DeepSeek新模型斩杀GPT-6,许愿式编程时代降临)
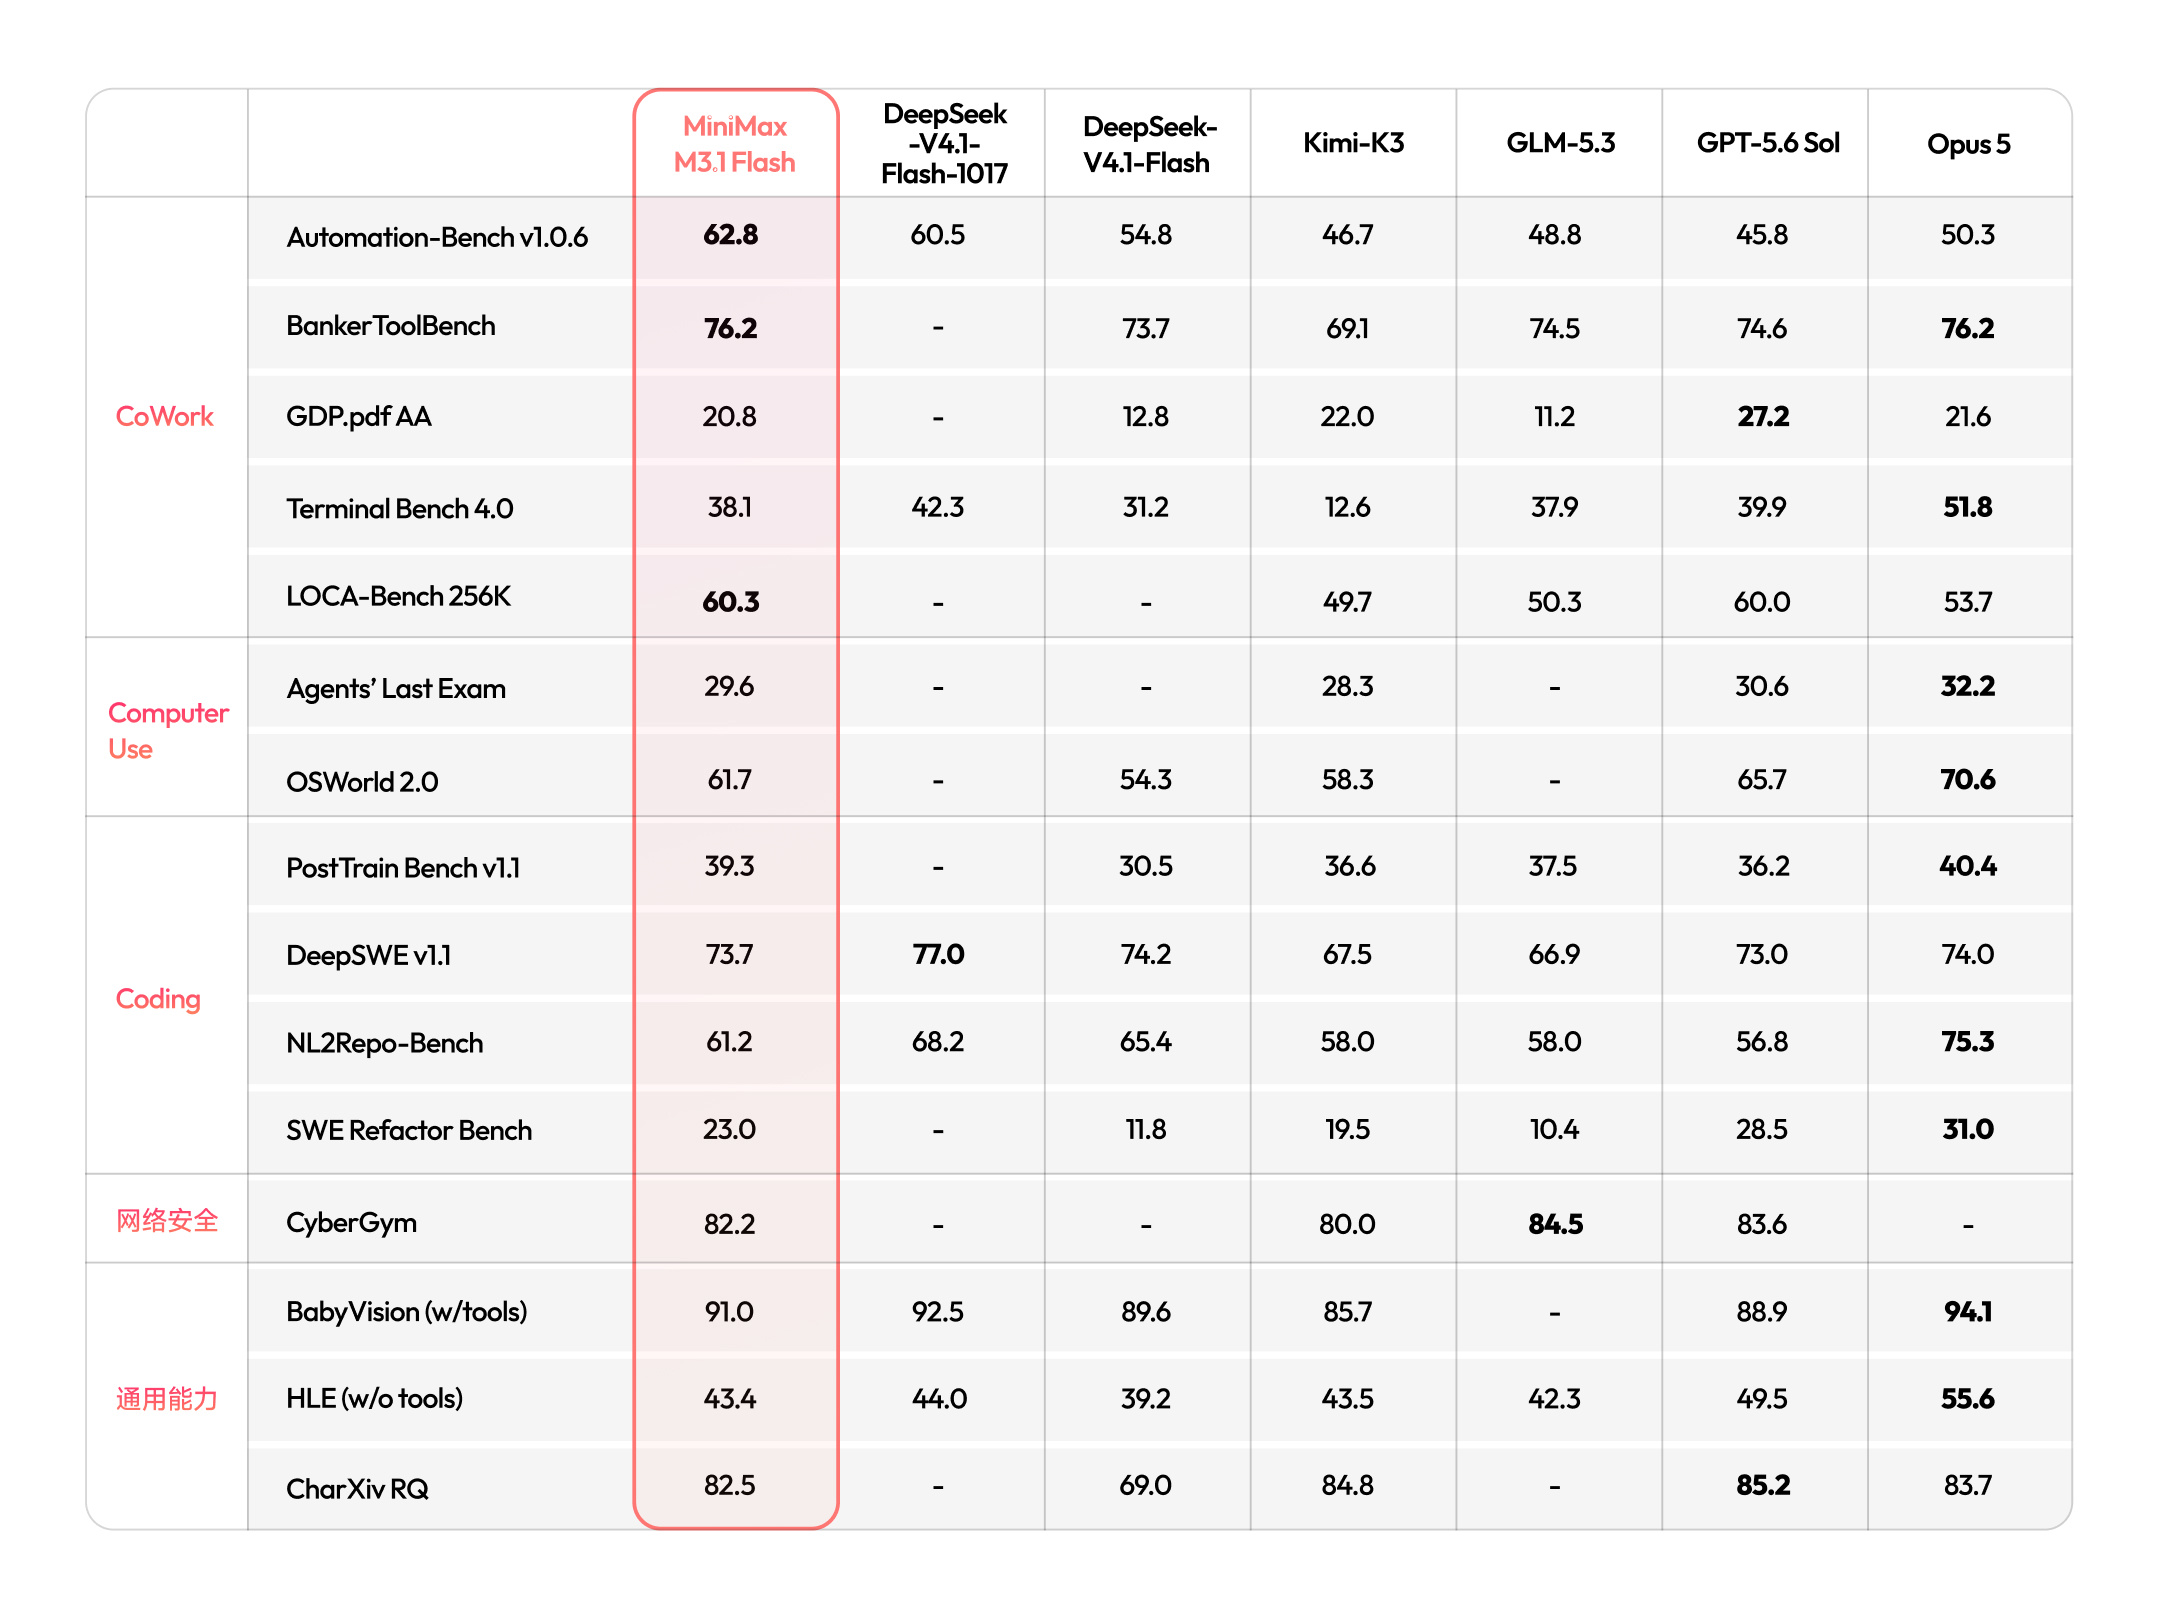
根据M3.1 Flash的基准测试成绩,该模型在Agentic任务、编程、Computer Use及网络安全能力等方面实现了大幅提升,与DeepSeek V4.1 Flash-1017基本追平。
价格上也进一步打穿了“斩杀线”。M3.1 Flash的输入价格为每百万Token 1元,输出价格为每百万Token 4元,缓存读取价格为每百万Token 0.1元。据MiniMax团队发布信息,在Agentic类任务中,该模型的综合使用成本较前代模型降低了70%。
DeepSeek V4.1 Flash-1017定价为闲时输入(缓存命中)每百万Token 0.02元、未命中每百万Token 1.0元、输出每百万Token 4.0元,高峰时段输入(缓存命中)每百万Token 0.04元,未命中每百万Token 2.0元,输出每百万Token 8.0元。
能力上你追我赶,价格上更是不甘示弱,这两款“Flash”模型接连落地,国产模型在Flash段位第一次有了“双强”的格局。
一、拆解硬核成绩单:性价比之王,多项成绩超过Kimi K3和GLM-5.3
Space Bunny匿名期积累的社区口碑,让正式版的M3.1 Flash承载了极高的期待,那它成绩究竟如何呢?
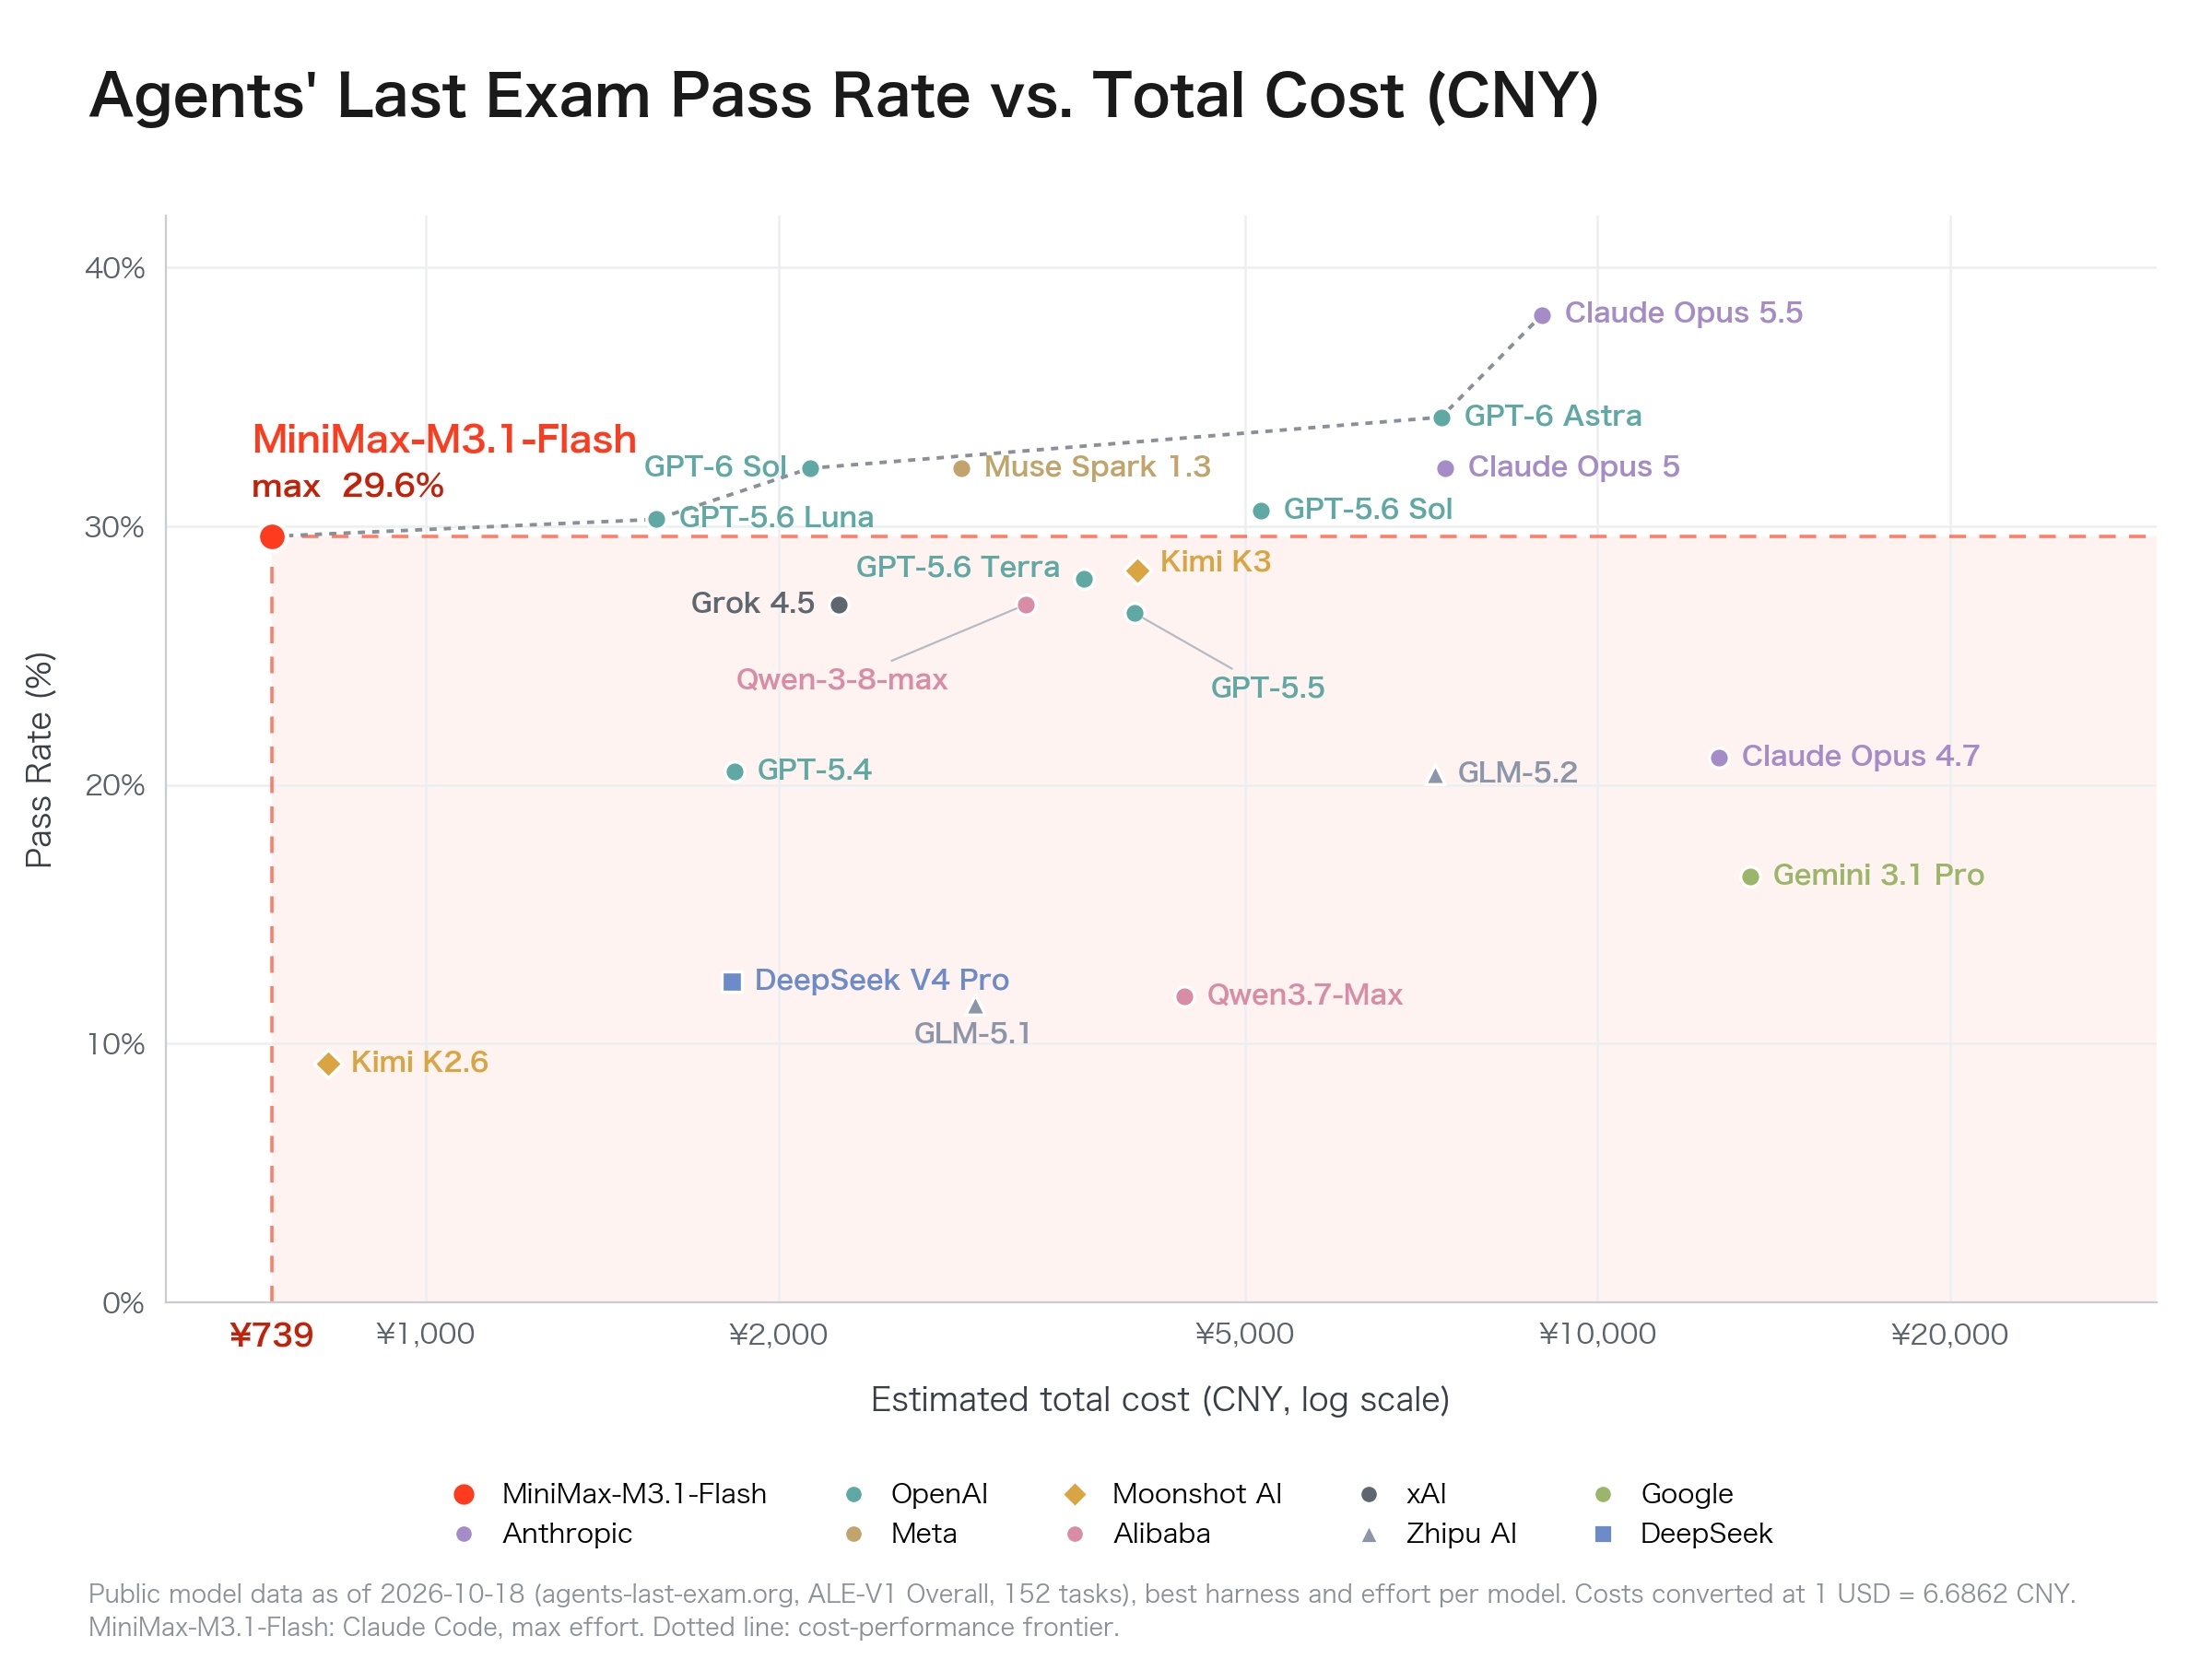
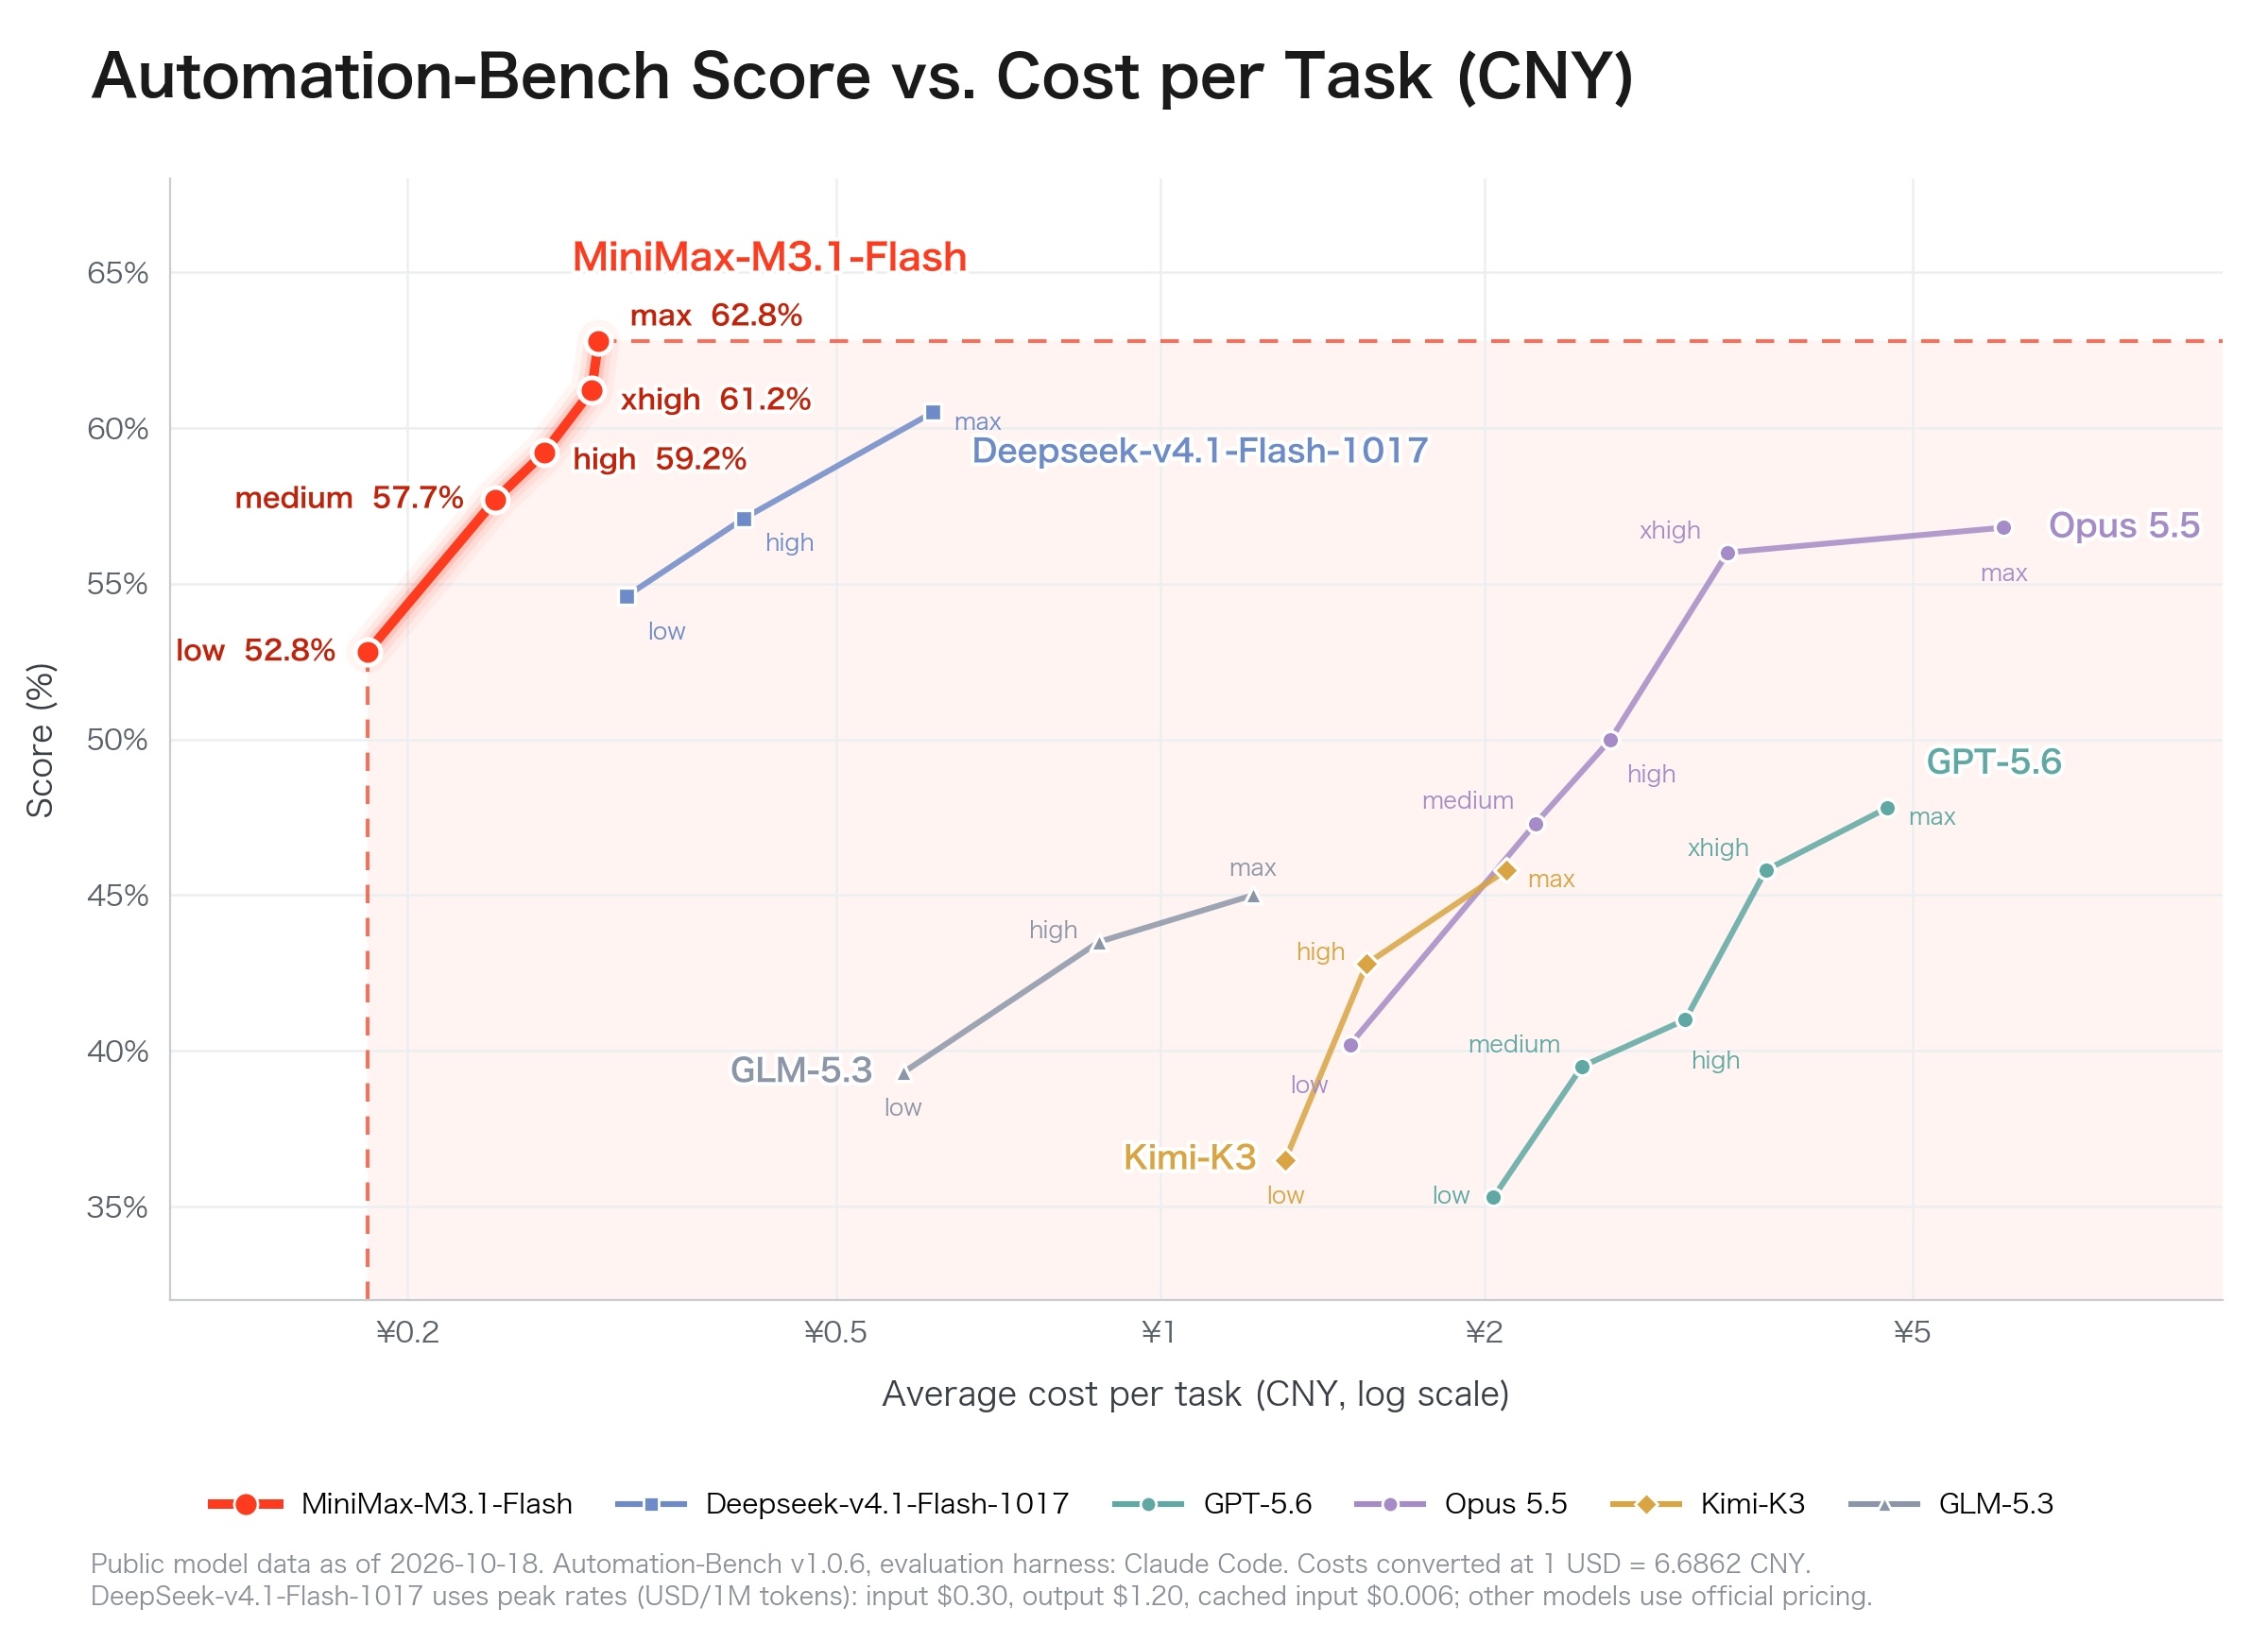
在复杂任务与自动化上,M3.1 Flash实现反超。 在评估智能体长程、多步骤真实任务的Agents’ Last Exam中,M3.1 Flash跑出了29.6%的通过率和739元的成本,处在“低成本-高通过率”的最前沿区间,性能远超同价位模型。
而在考察真实业务流程跨应用自动化的Automation-Bench v1.0.6中,M3.1 Flash拿下62.2分,反超了DeepSeek V4.1 Flash-1017的60.5分,更是将Opus 5甩在身后。
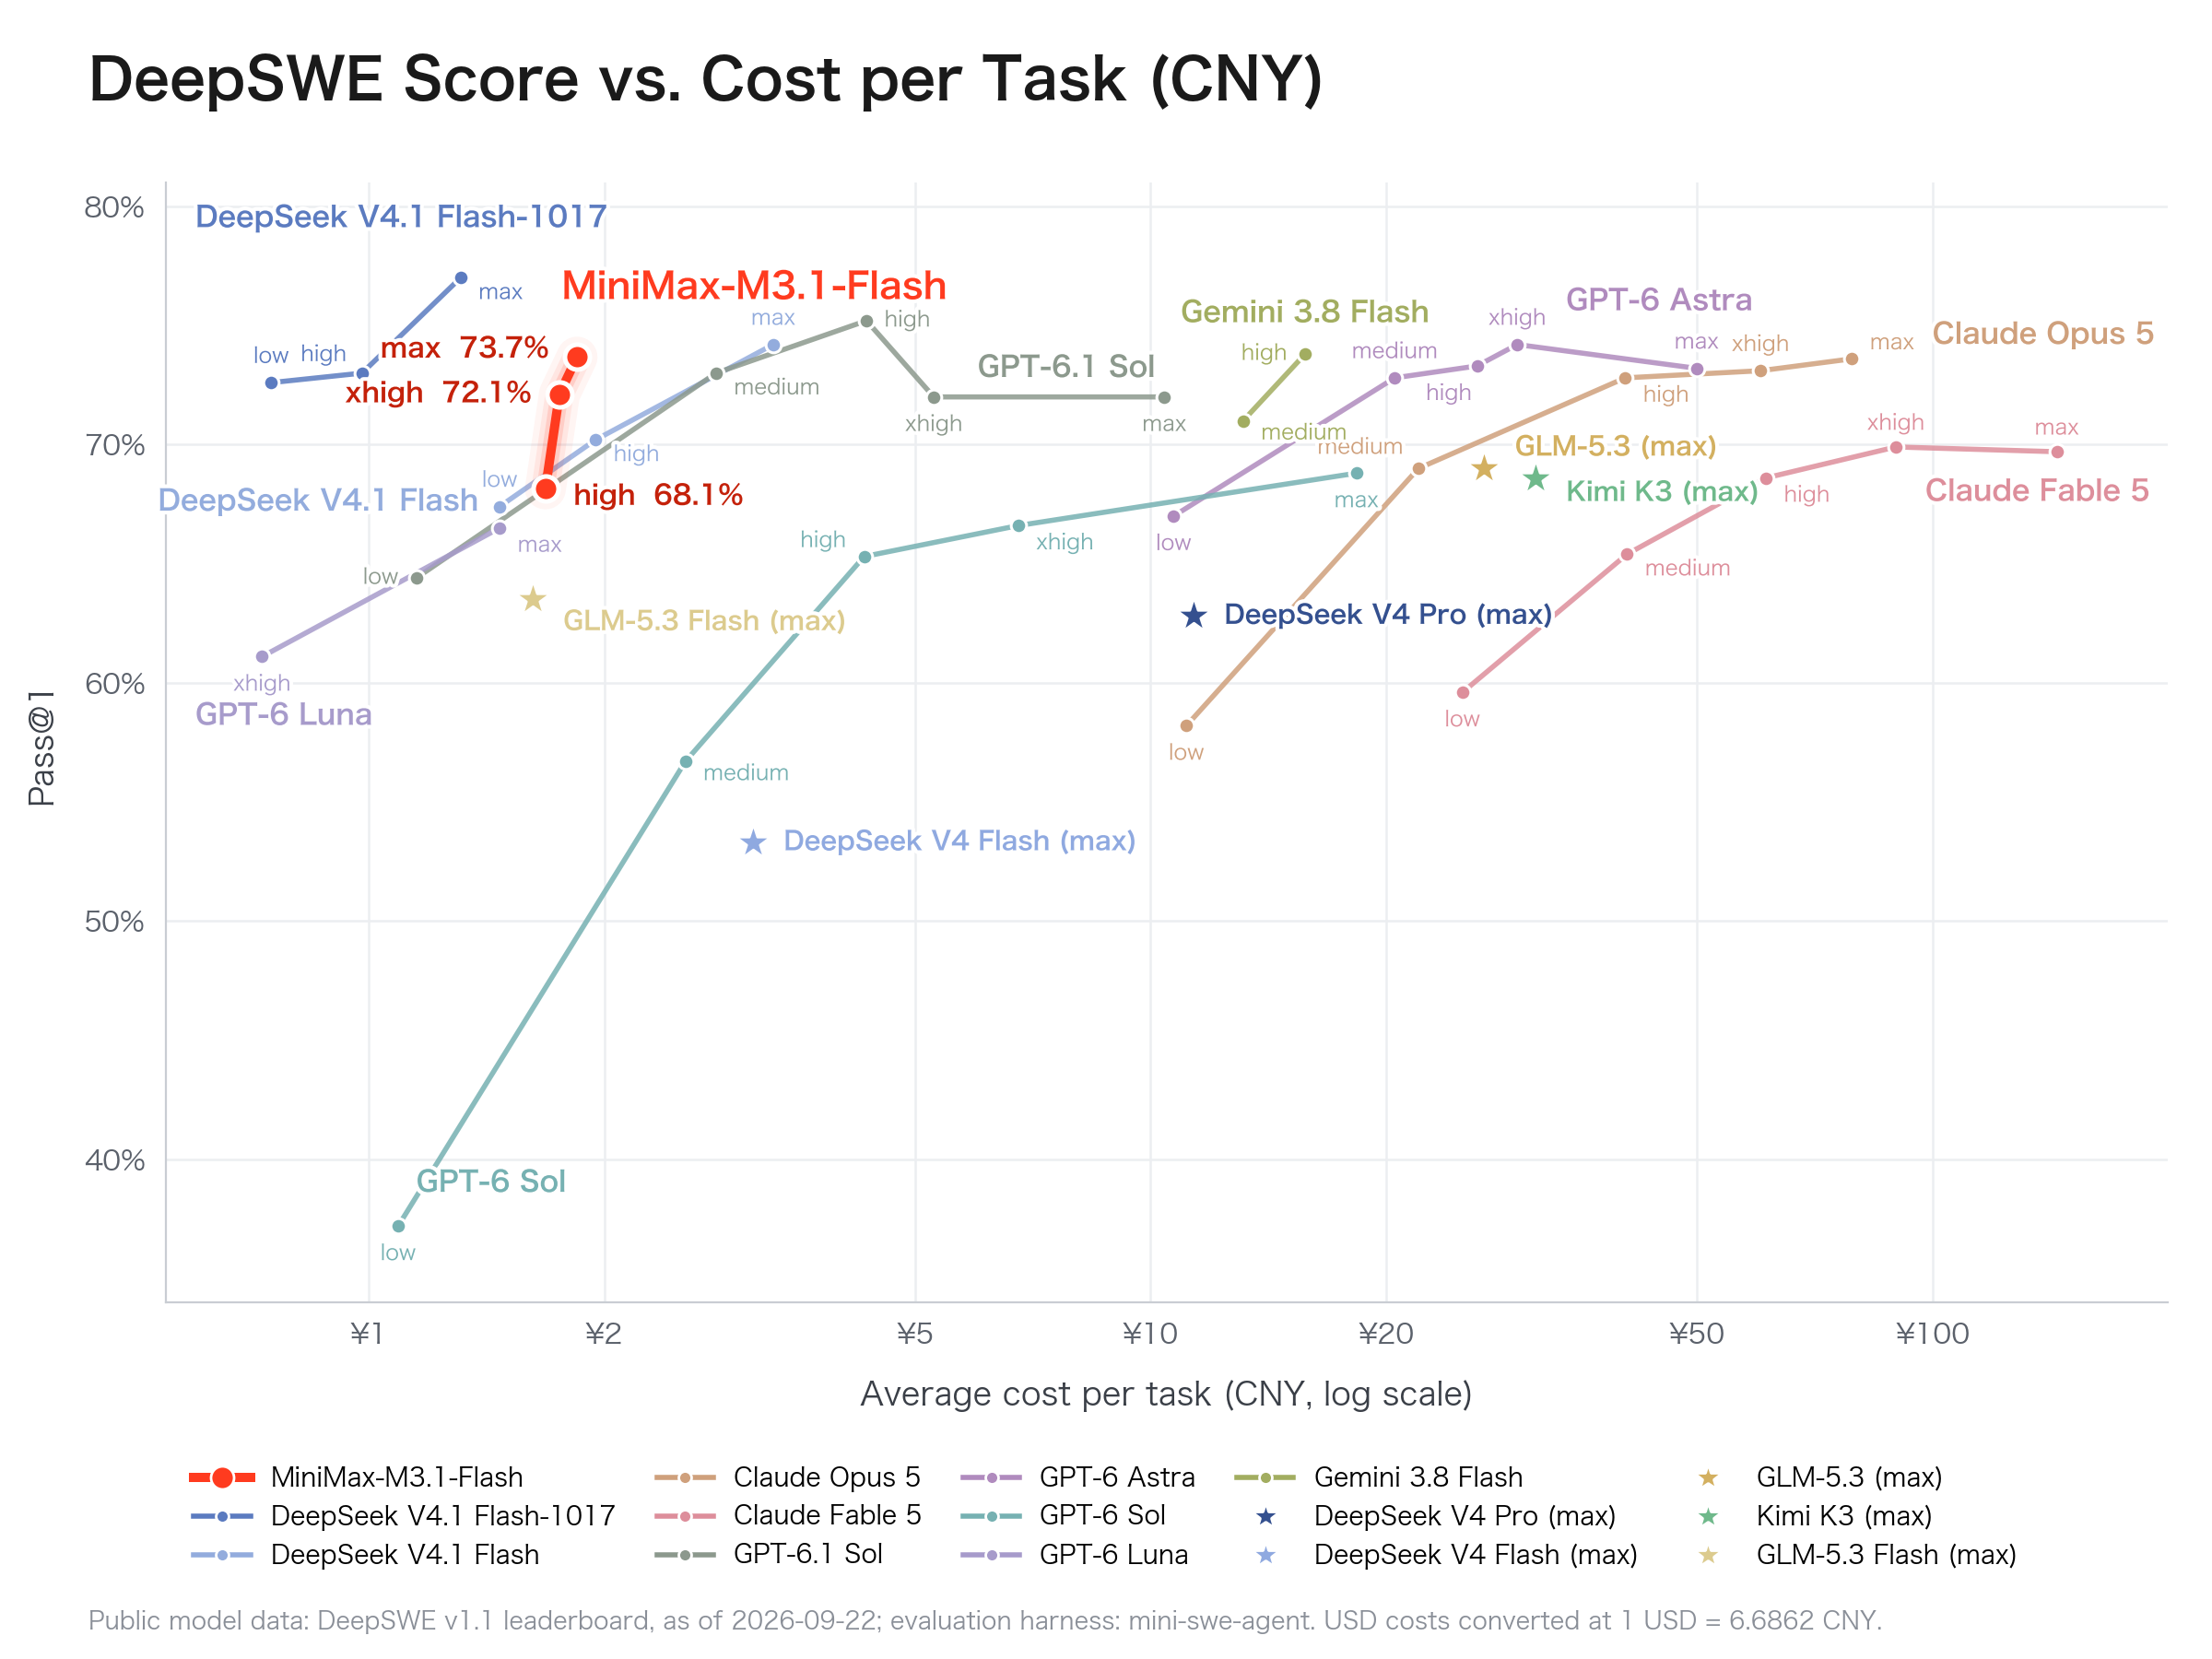
在编程领域,M3.1 Flash与DeepSeek V4.1 Flash-1017各有侧重。 在DeepSWE v1.1测试上,DeepSeek V4.1 Flash-1017得分为77.0分,排名第一。M3.1 Flash取得73.7分,距离Opus 5仅差0.3分。
在代码修复测试SWE Refore Bench中,M3.1 Flash拿到23.0分,直接是DeepSeek成绩的两倍以上。
在专业与安全领域,M3.1 Flash也稳居第一梯队。 在金融工具调用的BankerToolBench中,它以76.2分与Opus 5并列第一;网络安全CyberGym测试中,其以82.2分与GLM-5.3同处第一梯队;无工具学术推理测试HLE w/o tools中,M3.1 Flash取得43.4分,略高于DeepSeek V4.1 Flash-1017。
从榜单可以看出,M3.1 Flash绝不是一个“偏科”的模型,它在Agent和自动化上的成绩,甚至已经超越了行业旗舰大模型。
完整榜单如下:
二、发布相隔48小时,DeepSeek和MiniMax打出“双强”格局
DeepSeek V4.1 Flash-1017与M3.1 Flash,同样定位Flash,在两天内接连发布,且基准测试成绩如此接近,让人自然而然地看到了一个全新的格局:双强并立。
DeepSeek V4.1 Flash采用稀疏MoE架构,总参数量552B,但推理时输入仅激活8B 参数、输出激活16B。它在性能与速度上都超过了上一代Pro版本,但定价压得很低。这款模型的发布,直接让开发者们看到了Flash模型的“旗舰能力”。
顺着DeepSeek撕开的口子,M3.1 Flash往前更近了一步。
在M3.1 Flash还处于匿名期时,上线短短几天内,它便在OpenCode的调用量榜单稳居第二,在OpenRouter上一度排名第一。
有网友用Claude Opus 5、GPT-6 Sol和Gemini 3.8 Flash与Space Bunny进行比较,用最高思考级别构建火箭发射场景。该网友称Space Bunny仅花了三分钟,最终呈现的效果能和Opus 5相比,速度也很快。
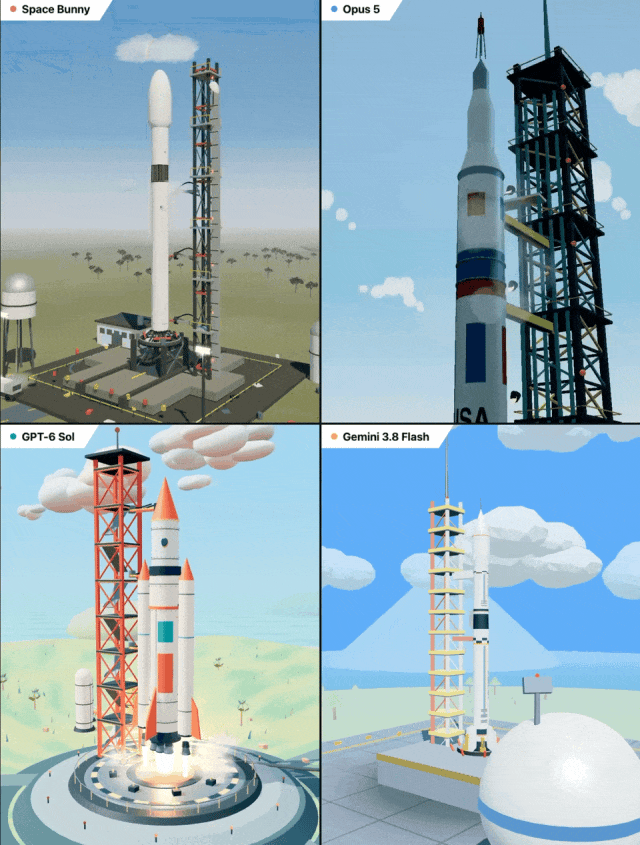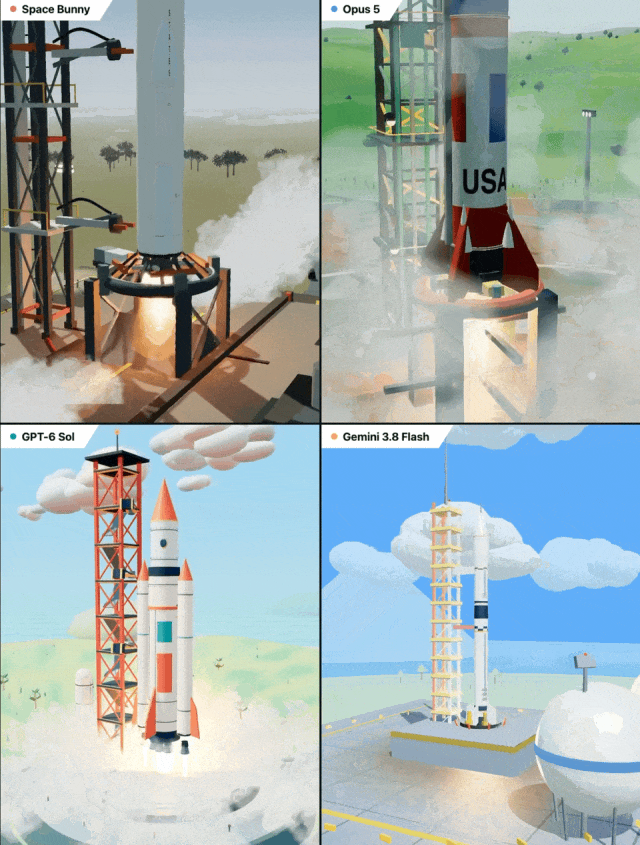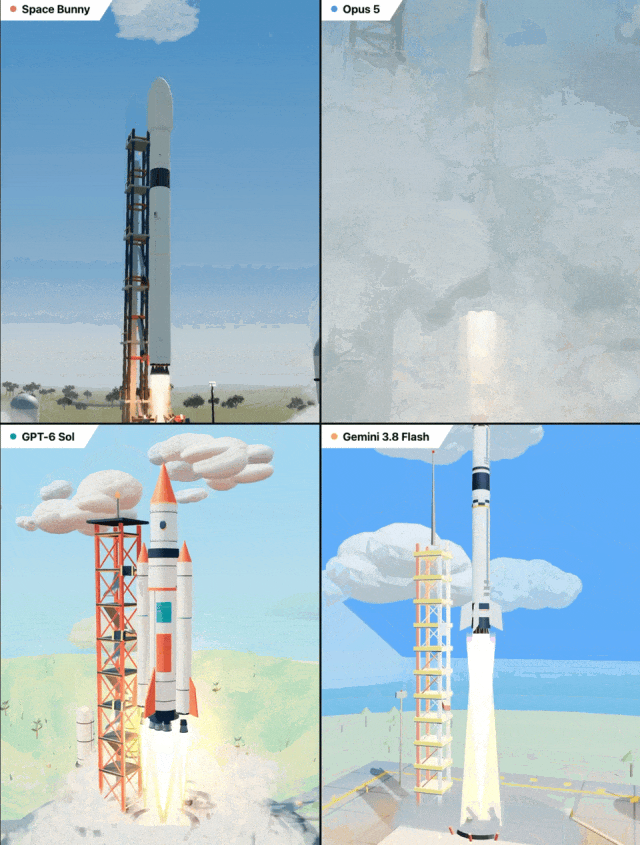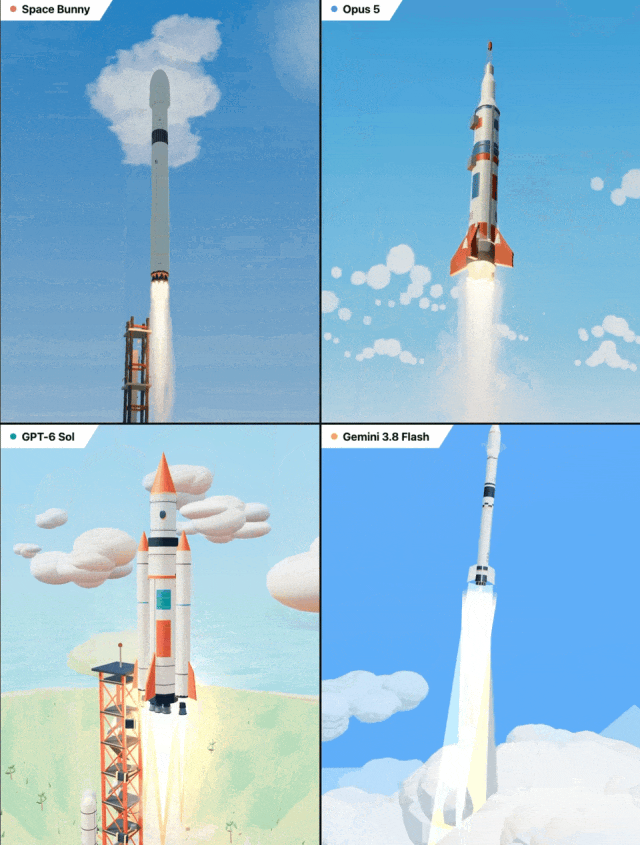
智东西也第一时间进行了实测,认为该模型效果直逼GPT-6 Astra(神秘模型“太空兔”火了,效果直逼GPT-6 Astra,10万人围观)
Space Bunny匿名期间让开发者惊艳的响应速度在正式版中也得到完整保留。据MiniMax团队透露,他们进一步优化了M3.1 Flash的推理效率,使用了更激进的稀疏注意力架构,日常使用场景下的输出速度可达200+TPS (Tokens per Second),中位数(P50)稳定达到170+TPS。
定价上,M3.1 Flash的输入输出价格约为DeepSeek V4.1 Flash-1017高峰期价格的一半,与空闲时期价格持平。
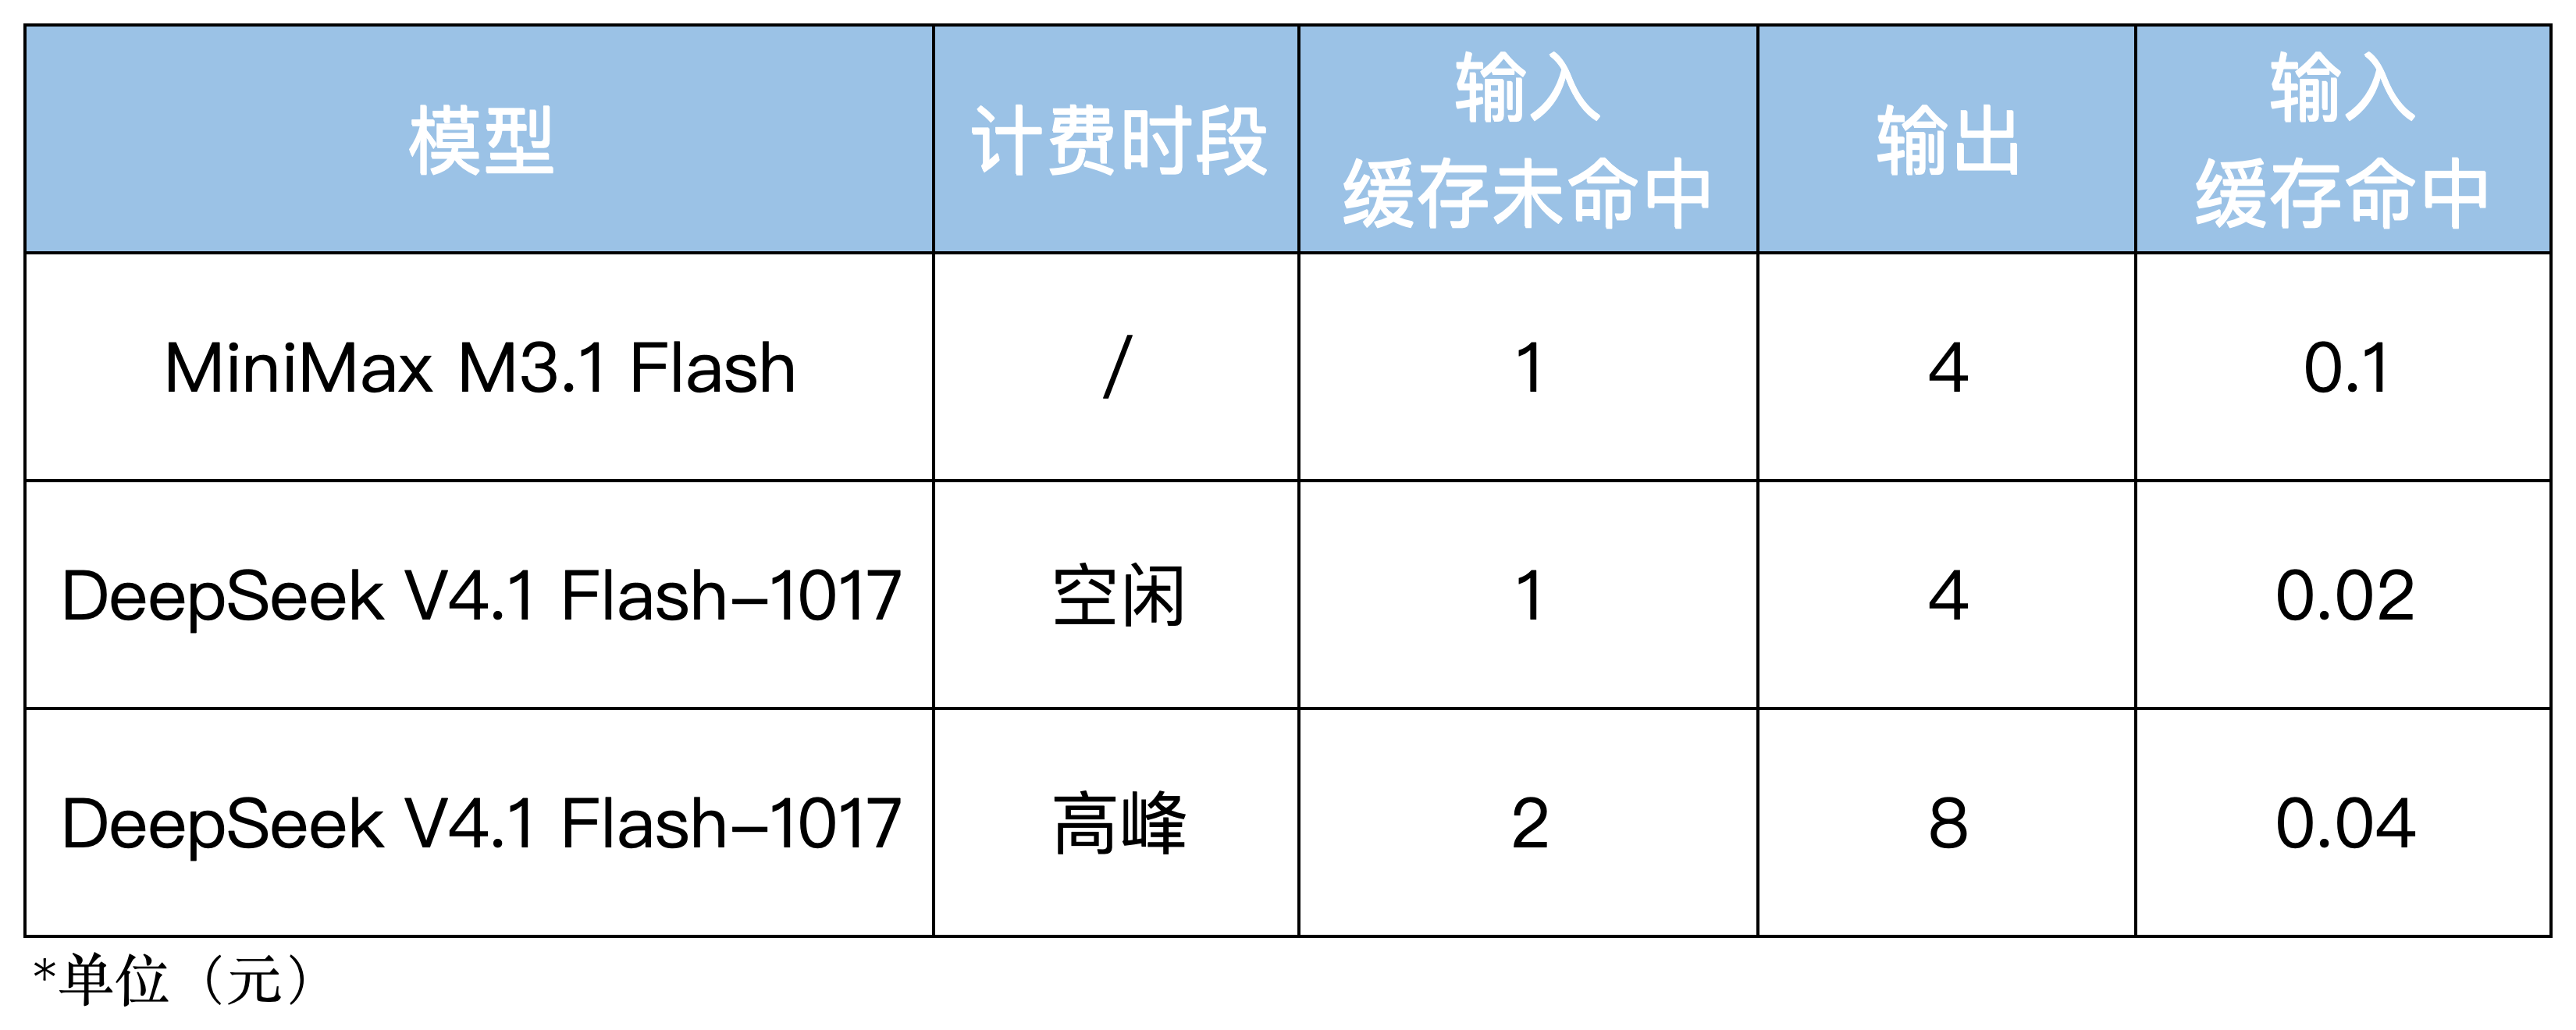
▲M3.1 Flash与DeepSeek V4.1 Flash-1017价格对比(智东西制表)
可以说,这两个模型就像开发者工具箱里两套各有侧重的工具,开发者能根据任务需求灵活调度。
例如,需要代码生成效率和缓存成本控制时,开发者们可以选择DeepSeek V4.1 Flash-1017;面对长程Agent任务、跨应用自动化或多模态驱动的开发流程时,M3.1 Flash则可以作为第一选项。
此前外界对MiniMax的印象,或许多集中在多模态领域。但无论是Space Bunny匿名期间的调用量霸榜,还是M3.1 Flash正式发布的基准测试成绩单,都证明了MiniMax在Agent与自动化方向的竞争力,也让用户对其后续Pro模型的发布充满期待。
结语:Flash模型上桌,不再是“平替”
DeepSeek和MiniMax的两款Flash模型接替上场,让业内看到了Flash模型的实力。
Flash模型正在撕掉 “预算不足才退而求其次” 的旧标签。从基准测试结果来看,它已能在部分核心指标上,跻身旗舰模型的同台对比序列,同时保留自身在推理速度与成本上的固有优势。
从性价比上看,Flash模型或许最接近真实使用场景的模型类型,国产模型首次形成DeepSeek和MiniMax“双强并立”的竞争格局。
对开发者和企业来说,模型工具箱中,自此新增了一个可以按需调度的优质选择。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”