从算力到知力!华瑞指数云亮相2026人工智能产业大会“智能原生”论坛
10月14日至16日,2026人工智能产业大会(AIIC2026)在山东济南黄河国际会展中心举行。大会由中国信息通信研究院联合山东省工业和信息化厅、济南市人民政府共同主办,以"加快推进人工智能赋能新型工业化"为主题。
10月14日上午,由中国信通院依托人工智能产业发展联盟(AIIA)智能原生工作组举办的"智能原生"论坛如期举行。华瑞指数云(ExponTech)联合创始人兼CTO曹羽中受邀出席,发表题为《从算力到知力:智能原生时代的下一个基础设施命题》的主题演讲。他的核心判断是:当模型与算力同时收敛,AI基础设施的核心命题正在从"送算力"转向"养知力"。
模型在趋同、算力在商品化,下一场战争在"上下文"
曹羽中指出,2026年AI行业的底层变量正在同时收敛:旗舰模型的基准分差收窄到几个百分点,Token价格一年跌去一个数量级,算力可按Token计价。当模型与算力都趋同,AI产品靠什么分出高下?他的答案是上下文(Context)。他把接入顶级模型、却没有上下文体系的Agent形容为"每天早晨都会失忆的天才"。上下文也不等于记忆:交互记忆只是最薄的一层,完整的上下文还包括业务知识与业务数据——"只做交互记忆而不打通业务知识,等于守着金矿淘沙。"Agent的天花板不在模型,在Context;谁拥有用户的上下文,谁就拥有一切。
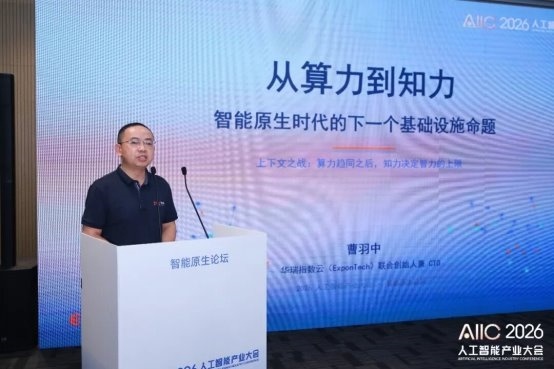
华瑞指数云联合创始人兼CTO 曹羽中
算力之外是"知力":存得下只是字节,调得动才是知识
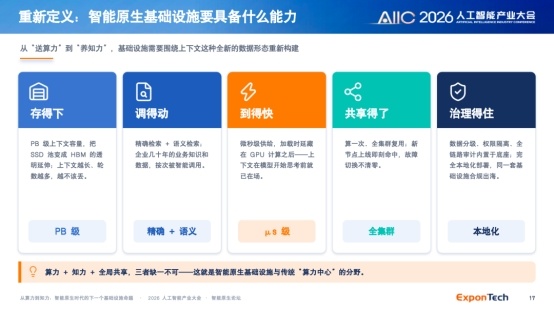
"行业习惯沿着'算力'的对仗把它归入'存力',但'存'字总把人带向容量、硬盘、存储系统,把这件事看小了。"曹羽中由此提出一个更具指向性的词——知力:全部上下文(业务知识、业务数据、交互记忆)的全链路能力,存储、管理、全局共享、精确检索、语义检索,最终汇聚为一次模型交互所需的上下文。存力存得下的只是字节,知力调得动的才是知识。
算力决定AI想得多快,知力决定AI知道多少、想得多对。两者的根本区别在于时间属性——算力算过即忘;知力算一次、全局留存、千路并发共享,越积累越快越便宜。推理算力中75%以上耗在Prefill,其中大量是重复计算;DeepSeek公开实测显示,同等Token工作量下,全局KV缓存与零缓存的成本相差数十倍。"在推理时代,继续单纯堆卡,是在为'遗忘'付费。"由此他给出一个反直觉的建议:企业走向智能化的第一优先级,不是再采购更多GPU——先让算过的不再重算,把业务知识与历史数据变成AI的上下文。
KV Cache撞上"内存墙",行业共识已经形成
上下文从32K迈向128K乃至每会话1M+ tokens,KV Cache不再是性能优化,而是AI的工作记忆,但它撞上了"内存墙":一次300K token会话的KV空间约180GB,远超单卡HBM容量;HBM一满,放不下的KV只能被驱逐,重算代价是O(n²)。某Token工厂的生产实测显示,仅用HBM的8卡GPU节点上,并发从120升到150,首Token时延(TTFT)便从22秒飙升到615秒——不是算力不够,而是记忆放不下。
行业共识已经形成——用SSD池化卸载KV Cache。DeepSeek默认为所有用户开启缓存,命中率99.8%与0之间的真实账单相差约90倍;NVIDIA在2026年1月发布CMX(Context Memory eXtension)架构,以SSD+高速网络构成G3.5共享层。"CMX五层各司其职,但只有G3.5让上下文成为集群的公共资产。"围绕这一判断,华瑞指数云已形成完整的产品拼图:WDS与WFS守住数据底座,WADP让业务知识与业务数据高效供给AI管线,WQS——全球最早的AI原生KV Cache存储,直接为"上下文"而生;四个产品全部构建在全自研分布式引擎WiDE之上。
以存换算:生产现场的"账本"
演讲披露了两组生产环境实测数据。某Token工厂以8卡GPU推理节点搭配3节点WQS存储集群,仅切换KV Cache方案:150并发下TTFT从615秒降至28秒,下降95%;常规并发吞吐翻倍;30轮长上下文输入吞吐提升44倍。"存算协同不是锦上添花,而是大模型高并发、长上下文生产场景下的必经之路。"
在某大型企业,DeepSeek V4 Flash、4台8×H20,WQS与推理引擎同机融合部署,同机A/B对比:不新增一台机器,TTFT从53.1秒降至21.3秒、减少60%,输出吞吐提升3.06倍。数据来自不同口径:实验室极限场景下TTFT加速20倍、吞吐提升22倍;真实业务A/B中吞吐提升4.4—4.7倍。只要KV被反复引用,"读取代替重算"就在放大产出。账本同样清晰:1个WQS节点可支撑3台GPU服务器,即3台GPU+1台WQS ≈ 6台GPU。
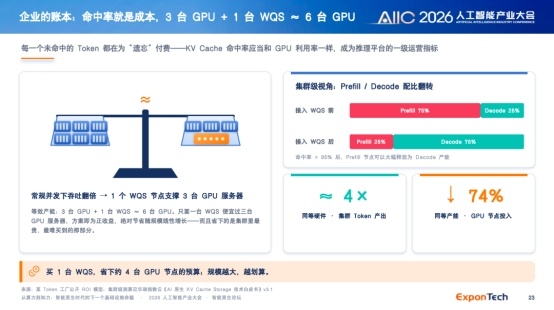
让上下文成为集群的公共资产
当KV Cache从"某张卡的私有状态"变成集群的公共资产,算力调度将不再被缓存位置绑架——请求可以落在任何一张卡上,命中的是同一份全局缓存。曹羽中把它概括为一句话:知力基础设施让"上下文"像电力一样被集群共享,算一次,处处可用。
面向未来三到五年,他判断竞争将转向"谁能更低成本地留存、共享、复用上下文"。为此,华瑞指数云向产业界发出标准共识、评测体系、生态共建三项倡议——推动共享KV池(G3.5)的接口与性能基线、以命中率和单Token成本为核心的公开评测,以及从推理框架、算力调度到芯片网络的端到端协同。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”