17岁Kimi天才少年离职,否认加入Anthropic,被曝手握5份千万offer



「我只是想学习而已,根本不在乎钱的问题。」
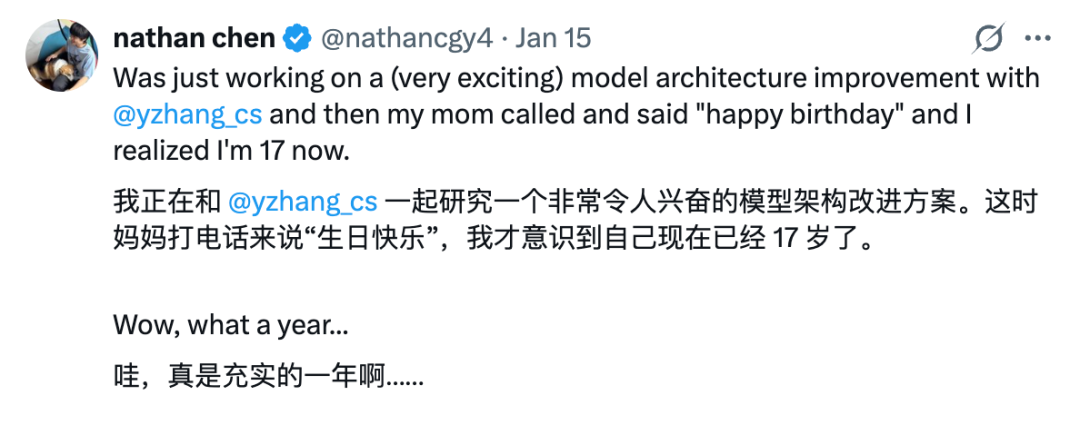
今年 1 月,陈广宇正和同事张宇讨论一项新的模型架构设计,母亲忽然打来电话,祝他生日快乐。他这才想起,自己已经 17 岁了。
两个月后,月之暗面 Kimi 发布了一项重磅技术论文《Attention Residuals》,其中注意力残差的创新得到包括马斯克在内众多硅谷大佬点赞。
陈广宇的名字,就出现在这篇论文共同第一作者的位置,跟他共同署名的,是张宇和苏剑林这样的大神。
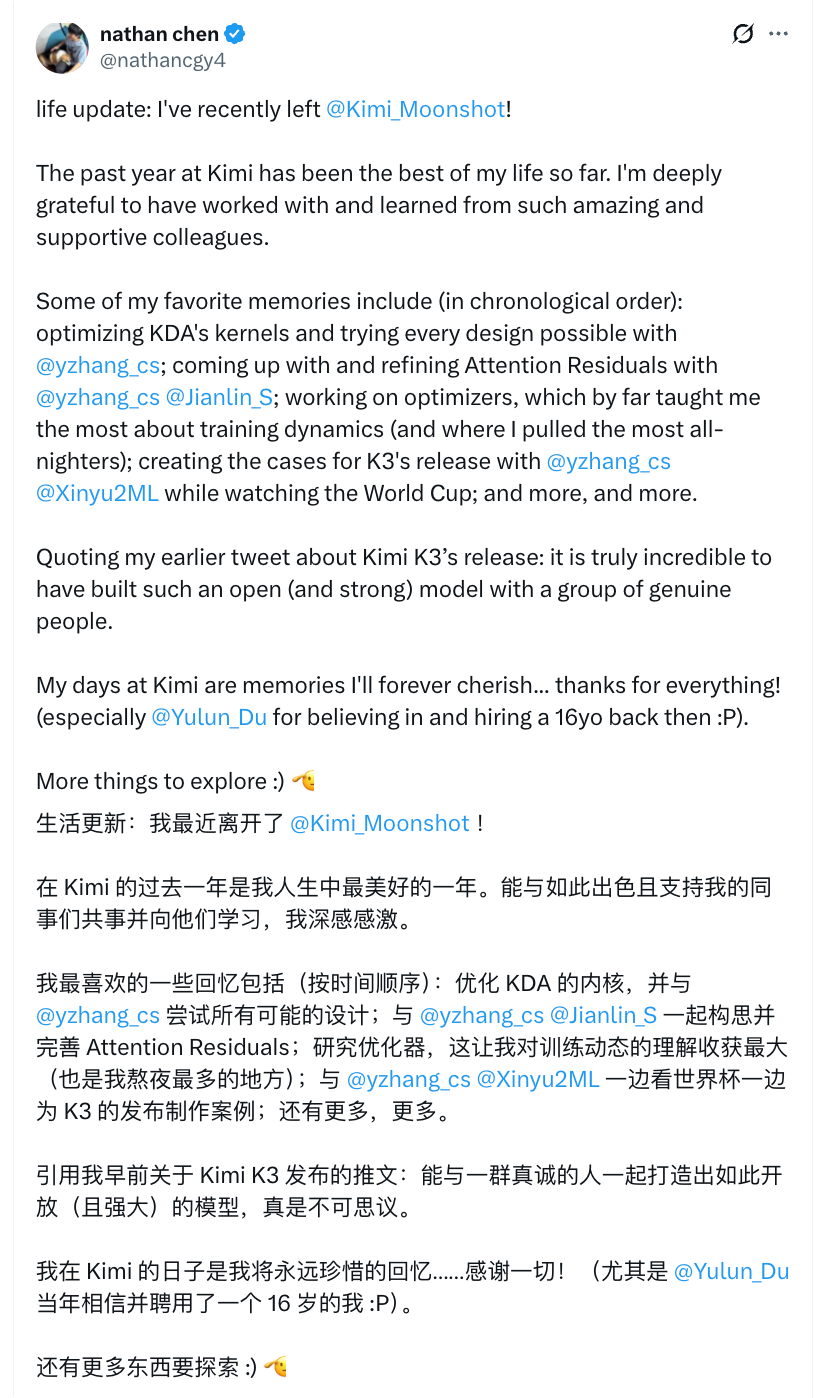
10 月 15 日,陈广宇发推宣布他已经离开了月之暗面 Kimi。他尤其感谢当初愿意聘用一个 16 岁少年的杜雨伦。他说,在 Kimi 的这一年,是自己迄今最美好的一段时光。
陈广宇宣布离开 Kimi 后,很快就被传要加入 Anthropic 。实际上这个消息的来源是 Anthropic 研究员 Sholto Douglas 在评论区和他聊起前往美国的计划,陈广宇回复,自己正要去湾区。
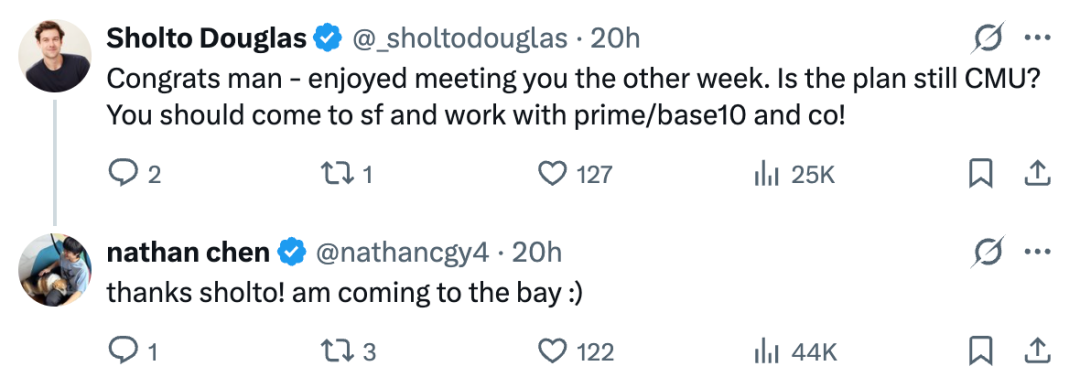
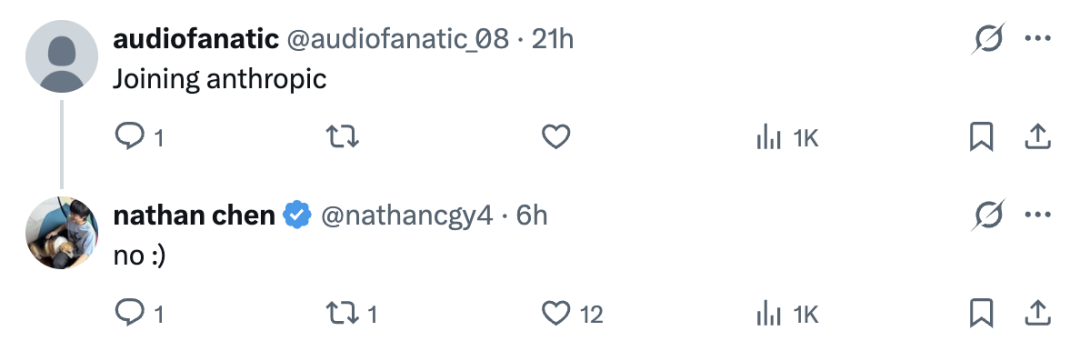
而在刚刚,陈广宇在 X 上否认要加入 Anthropic。但不出意外,他确实也收到了硅谷不少公司抛来的橄榄枝。
一个少年的非标准路径
陈广宇在深圳长大,就读于贝赛思体系学校。和人们熟悉的竞赛少年不同,他没有以奥赛金牌作为进入 AI 行业的敲门砖。他在个人博客里写,2024 年读高一时,自己厌倦了为了大学申请而机械积累经历,决定把时间挪给真正感兴趣的东西。
起初也谈不上方向清晰。他读人工智能安全,读物理和科技人物的故事,还试过记录室友的鼾声与运动、室温和作业量的关系,用刚学的决策树模型寻找规律。为了弄明白更复杂的模型,他曾把论文交给 Gemini,遇到不懂的地方就继续发问,还半开玩笑地称它为自己的导师。
2025 年 2 月,他带着 ThirdArm 机械辅助手的构想参加中学生黑客松,结识了技术圈的前辈。3 月,他开始更系统地研究机器学习。到了 5 月,他写下一篇关于 DeltaNet 的技术博客,把自己的理解公开发到网上。
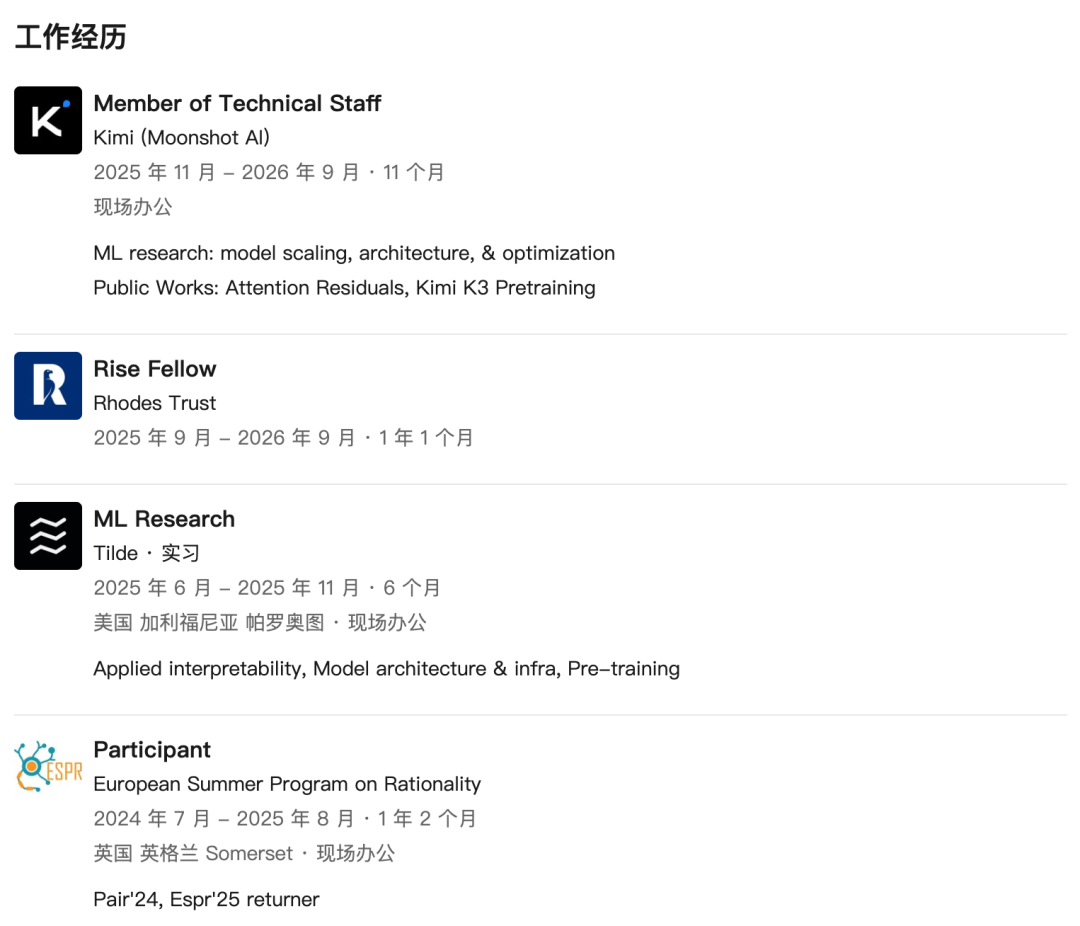
当时他的社交账号只有约 20 个关注者。DeltaNet 研究者杨松琳注意到文章,给出了回复。消息沿着研究者的社交网络传开,又被美国 AI 初创公司 Tilde Research 的负责人看到。对方约他通话,后来向他提供了实习机会。
2025 年 7 月,16 岁的陈广宇独自前往帕洛阿尔托,在 Tilde Research 实习了 7 周。几个月后,他加入 Kimi,开始接触体量更大的模型和真正昂贵的训练实验。
前几天,一位活跃在硅谷 AI 创投圈的风险投资人 Deedy 发推说,自己认识一位年轻人,十七岁的他就收到了旧金山最顶尖的初创公司的五份薪资超 1000 万美元的工作邀请。
根据贴文里的描述,不难看出此人就是陈广宇。
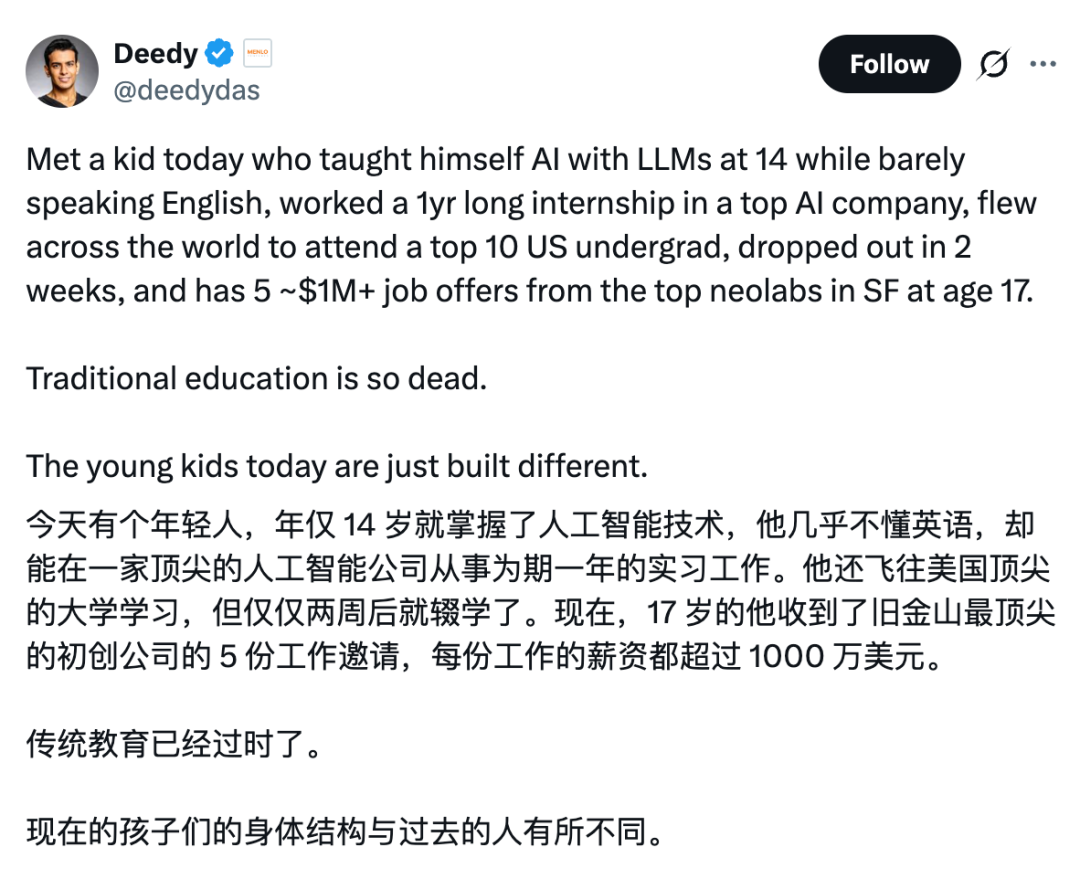
Deedy 说,当问「这位年轻人」为什么不完成大学学业时,他说「旧金山的氛围让我感觉不太对劲。我觉得这里的人都很疯狂,他们想做的事情和我一样。我只是想学习而已,根本不在乎钱的问题。」
让模型重新看看自己走过的路
前文提到,正是三月的那篇论文,让外界把目光投向了这名只有 17 岁的天才少年。
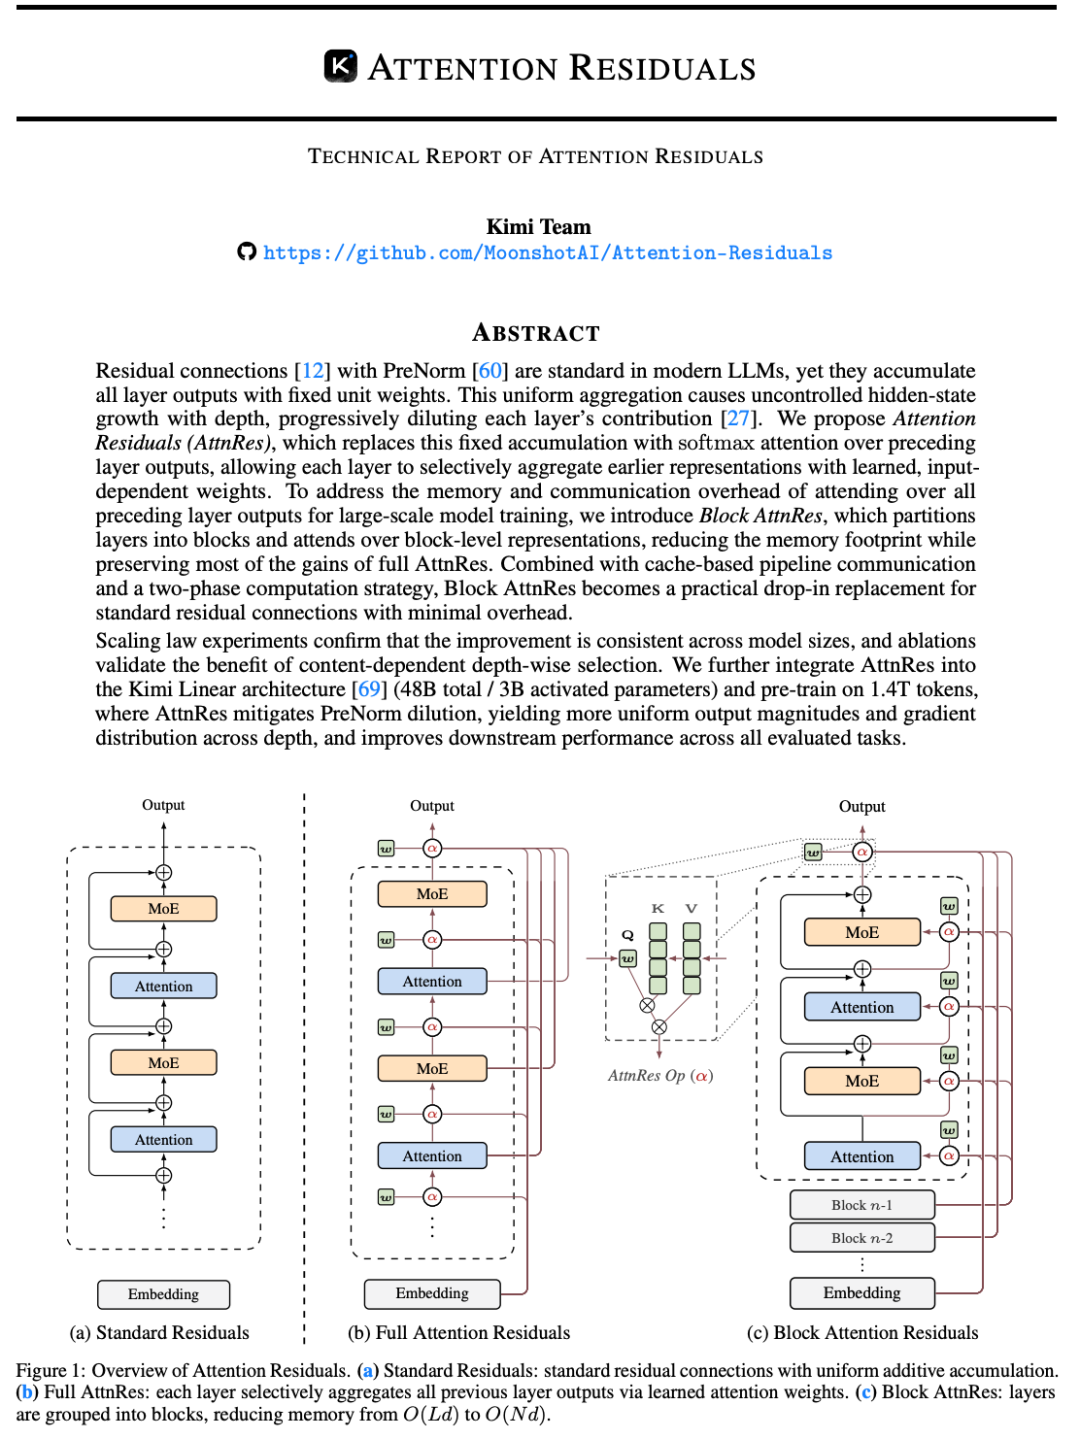
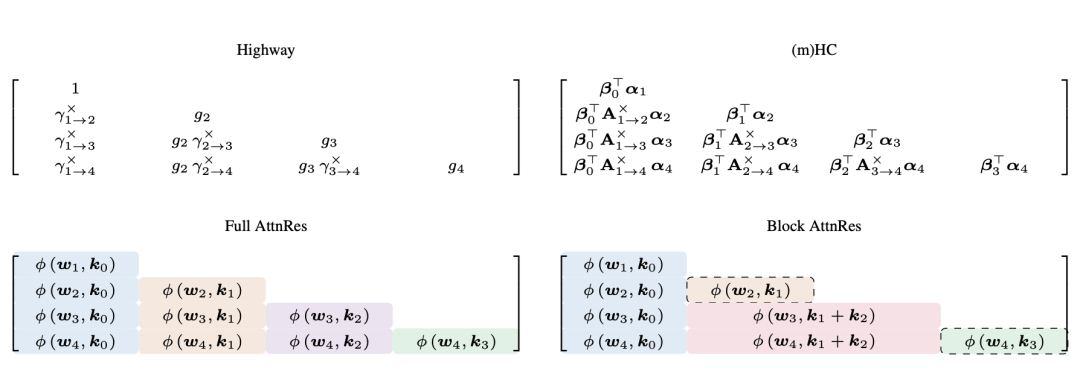
Kimi 注意到这样一个问题:现代模型广泛使用残差连接,让新一层的计算结果与此前的信息相加。不同层的信息混在一起,后续网络难以根据当前任务,有选择地取用早先的表示。
Attention Residuals 提出,让模型沿深度方向分配注意力。处理到某一层时,可以选择性地参考先前不同层的表示,而不必始终采取固定权重的累加。像是读一份不断增补的工作记录,终于可以回头挑出眼下最有用的部分。
不过,想让后面的每一层随时查看前面的所有结果,就要保存更多中间信息,还要在大量 GPU 之间搬运数据。
苏剑林后来在研究回忆中写到,最早的构想和小规模实验由他推动,张宇、陈广宇随后加入,在更大规模模型上继续验证。完整的 Attention Residuals 效果不错,训练开销却一度让方案难以落地。
张宇和陈广宇给出了一个折中的办法:Block AttnRes。把网络划分为若干块,先把块内的信息压缩整理,再让后续层对这些块进行注意力选择。实验发现,分成大约 8 块,就能保留完整版的大部分收益,同时降低显存和通信压力。
团队在总参数 480 亿、激活参数 30 亿的 Kimi Linear 模型上,用 1.4 万亿个 token 进行预训练。采用新结构后,GPQA-Diamond 测试得分从 36.9 提升到 44.4。算力对比上,基线模型需要约 1.25 倍的计算量,才能达到接近的训练损失。
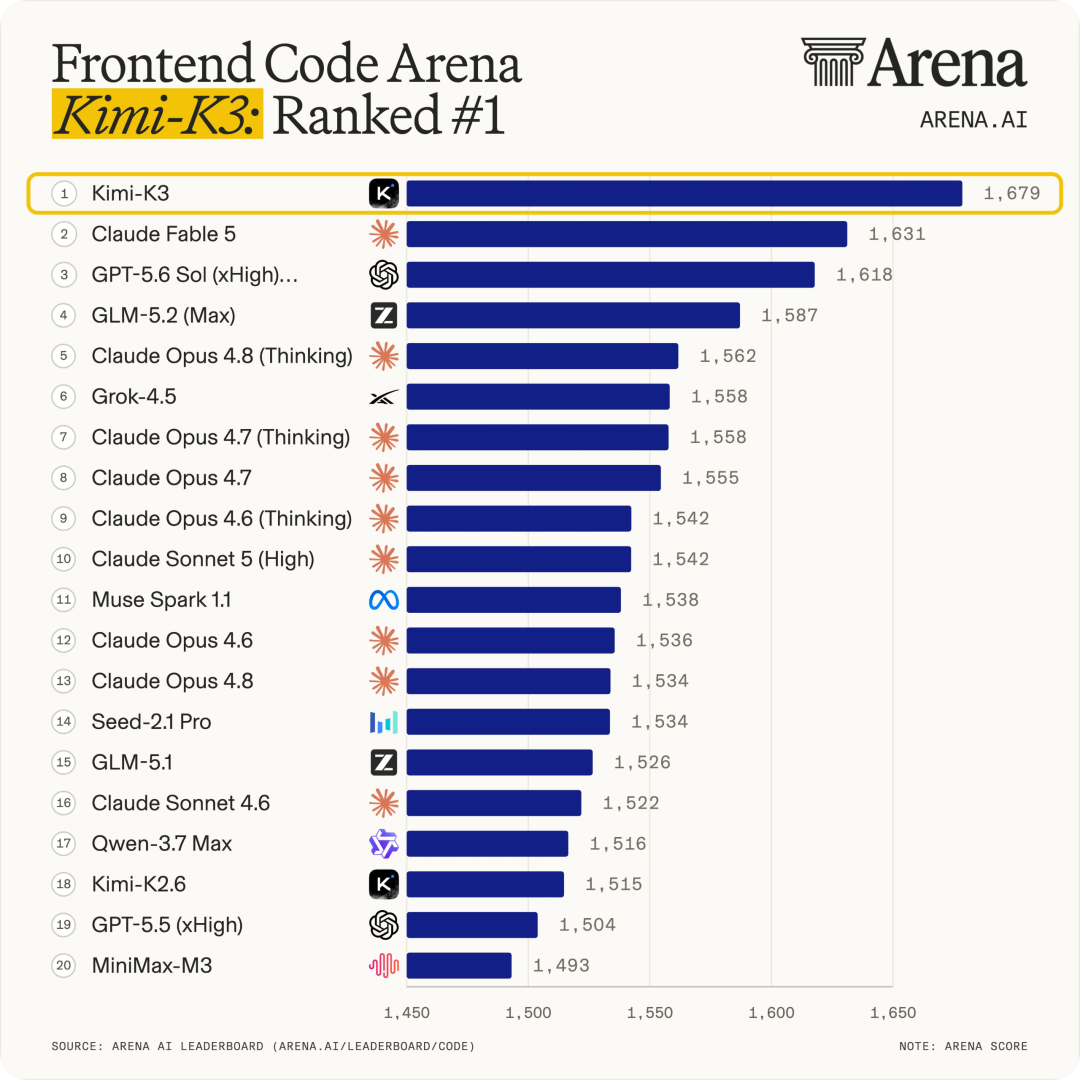
到了 7 月,Kimi K3 发布。模型已经把 Attention Residuals 和 Kimi Delta Attention 用进了核心架构。陈广宇在告别帖中还提到,自己参与优化过 KDA 的 GPU 内核,研究过训练优化器,也和同事一起准备了 K3 发布时的展示案例。
大厂的招聘启事,开始写给更年轻的人
过去几年,科技公司和研究机构开始尝试直接与高中阶段的年轻人合作。
2023 年,腾讯的星火计划邀请国际信息学奥赛选手参加挑战周。许庭强、戚朗瑞进入计算机视觉项目,研究如何判断摄像头前是一只真实的手,还是屏幕、纸张呈现的图像。他们需要试不同办法,比较效果。
据第一财经,今年夏天,在澳门读高一的张兆锋去了腾讯微信团队,参加为期 3 周的教育小程序产品实践。他与同伴做用户访谈、梳理问题、提出改进方案。
高中生坐进大厂会议室,和真正的产品团队一起讨论用户需求,已不再只出现在职业体验日里。
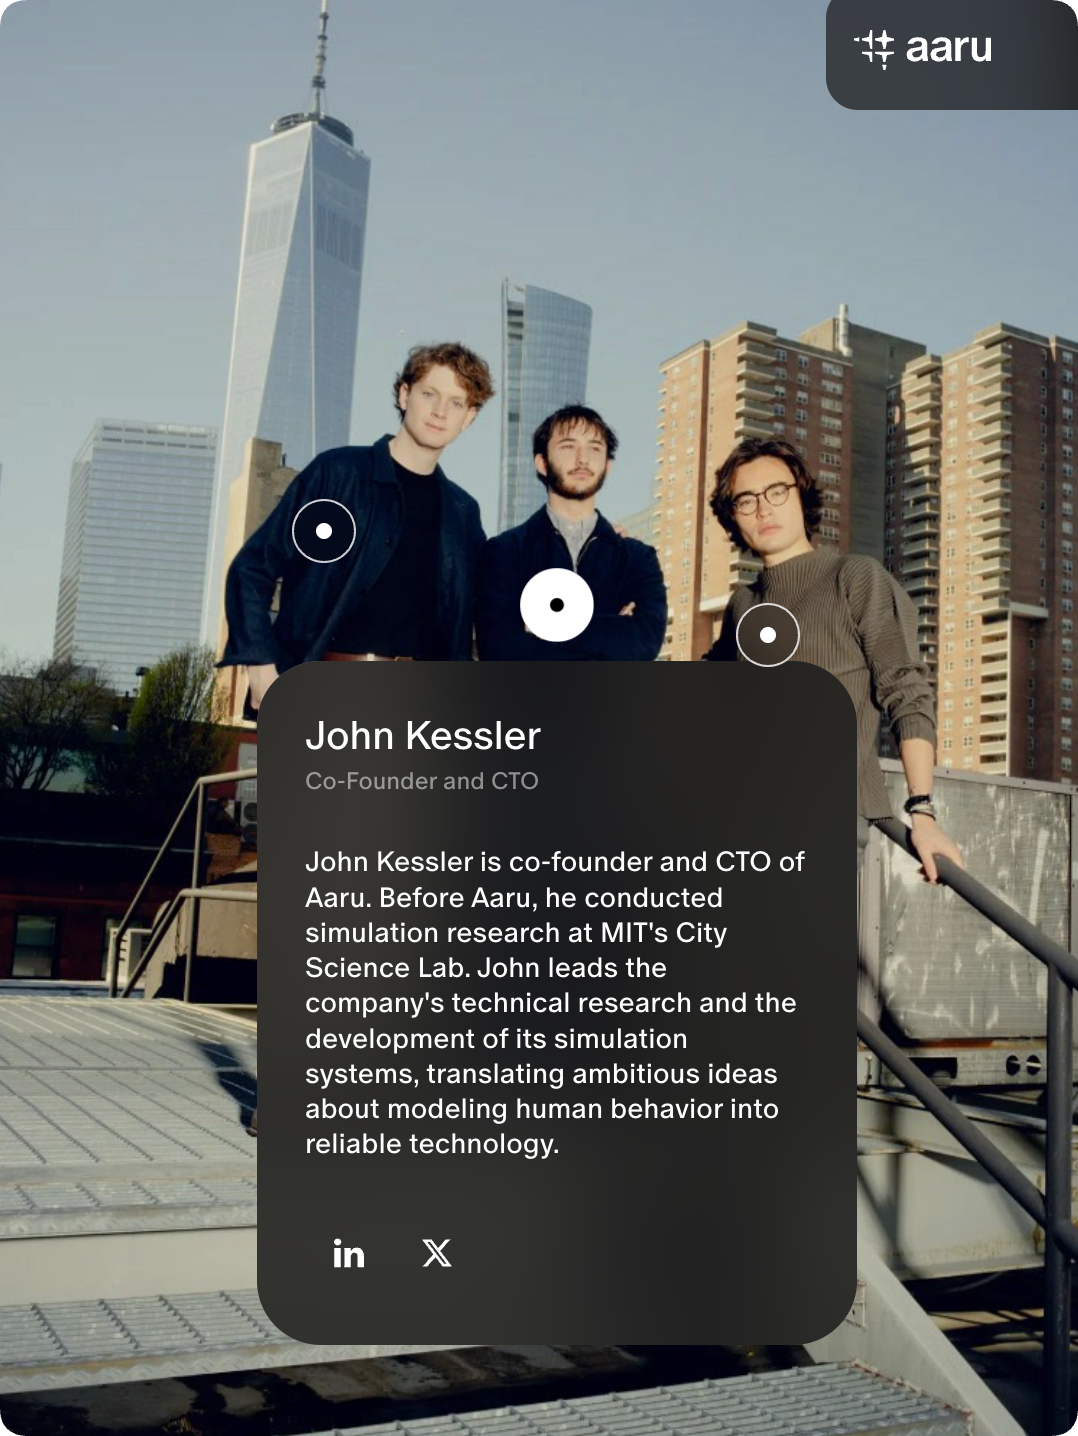
AI 创业公司 Aaru 的技术负责人 John Kessler 在创办公司时只有 15 岁。团队用 AI 模拟消费者的意见和决策,试图把传统市场调研中的一部分工作交给虚拟人群。到 2026 年,这家公司估值达到约 10 亿美元。
17 岁的 Navya Tuteja 开发的 Raaha 帮助神经多样性求职者评估招聘岗位是否合适,上线约两个月便吸引超过 1000 名用户。还有 17 岁的 Pavan Subramani,把生成式扩散模型用于分子运动模拟,在特定测试中让重要构象的采样效率提高 68 倍;同龄的 Praadhyumn Indaana 则用结合物理约束的神经网络,研究核反应堆冷却的安全边界。
Palantir 在 2025 年推出面向高中毕业生的 Meritocracy Fellowship,500 多人申请,22 人入选,直接参与真实技术项目。
DeepSeek 七月广发英雄帖,要「让新人直接承担最核心、最重要的任务」。
Kimi 今年 9 月的新一轮招聘,也写明实习不限年级,并为没有标准岗位标签的人设置了 7 个 Wild Card 名额。
公司寻找人才的动作,开始发生在大学毕业之前,甚至大学入学之前。学历仍然有用,却越来越难成为能力的唯一证明。这给了偏离标准路径的人更多机会。
但谁能获得这样的机会,依然并不平等。英语能力、设备、可支配时间、家庭支持、遇见导师的运气,都会改变起跑的位置。
大模型公司的节奏很快,实验成本很高,许多成年人也承受着持续交付成果的压力。一个十几岁的孩子有能力进入这里,当然值得高兴;如果每个孩子都因此觉得自己必须尽早进大厂、发论文、创业,新的焦虑也会很快出现。
陈广宇离开时,Kimi 的同事杜雨伦说,尽可能去探索、追随新的好奇心,对这个年纪的他也许是更好的选择。
AI 缩短了通往研究前沿的一部分路,17 岁的人已经能参与改变模型架构。一个年轻人最令人羡慕的地方,就是走到这里以后,仍有大把时间决定接下来要去哪里。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”