
智源悟界·PhysisServe:首个兼顾智能与高频吞吐的物理 AI 推理系统
逆矩阵联合智源、北大、vllm发布 PhysisServe,首个兼顾智能与高频吞吐的物理 AI 推理系统。PhysisServe 首次实现让百亿参数量级世界模型以每秒千赫兹的实时输出频率,比已有前沿方案快了一到两个数量级。这表明:只要算力充足,即使物理智能基模扩展到百亿、千亿乃至万亿参数,模型推理仍能以任务所需的频率持续实时输出,参数量与输出频率将可以兼得 。
人工智能的下一站是物理世界。 今天,物理 AI 已经能够在设定好的环境中完成动作,但从相对稳定的实验室走向充满噪声、干扰与持续变化的真实场景,仍有很长的路要走。悟界·physis致力于构建面向真实物理世界的「通用世界基座模型」,探索能够跨场景理解、预测与行动的通用物理智能,赋能具身智能、工业仿真与科学预测等广泛场景。
真实物理世界中的智能,需要理解环境如何变化,预测不同干预会产生什么后果,并将这些能力用于新的条件与任务。
• 在物理仿真中,这意味着预测复杂系统的演化,为设计、验证与决策提供依据;
• 在具身交互中,这意味着根据持续变化的观测调整行动;
• 在工业生产中,这意味着适应材料、设备和工况的变化。
当物理AI去做成千上万种任务时,现实中没法指望每个任务都被训练数据覆盖到。物理 AI 系统要在动态环境和可变身体中持续更新记忆、切换任务、预测环境、适配身体并让模型演化。
因此可归纳为这样的实践问题:
如何构建能够跨场景积累与复用经验的物理智能基座,并且使其以实际任务要求的速度与精度理解、预测和影响真实世界?
未来几个月,智源研究院联合逆矩阵将陆续发布针对这个问题的思考和技术成果,系统呈现我们构建通用物理智能的探索与实践。本文将从基础设施切入,探讨如何让更大规模的模型持续高频输出,并在有限算力下服务更多交互任务。
新一代物理 AI 的基础设施
Action-Conditioned World Model(ACWM) 与 World Action Model(WAM) 均可采用自回归去噪的方式生成。
自回归去噪与大语言模型逐 token 的生成同属自回归,区别在于后一次输出是否必须等待前一次完成。大语言模型每次生成一个 token,后一个 token 必须等前一个 token 经过全部 Transformer block 后才能开始计算,因此各 token 依次生成(图 1 左)。
自回归去噪则以 chunk 为单位生成连续帧:每个 chunk 从纯噪声出发,经过若干去噪步逐步变得清晰。后一个 chunk 不必等待前一个 chunk 完全去噪;前一个 chunk 每完成一个去噪步,后一个 chunk 就可以读取其在该步仍带噪声的 KV cache,并执行自身对应的去噪步骤。相邻 chunk 的去噪因此可以前后错开、相互重叠,使各个 chunk 以较短的间隔连续完成(图 1 右)。
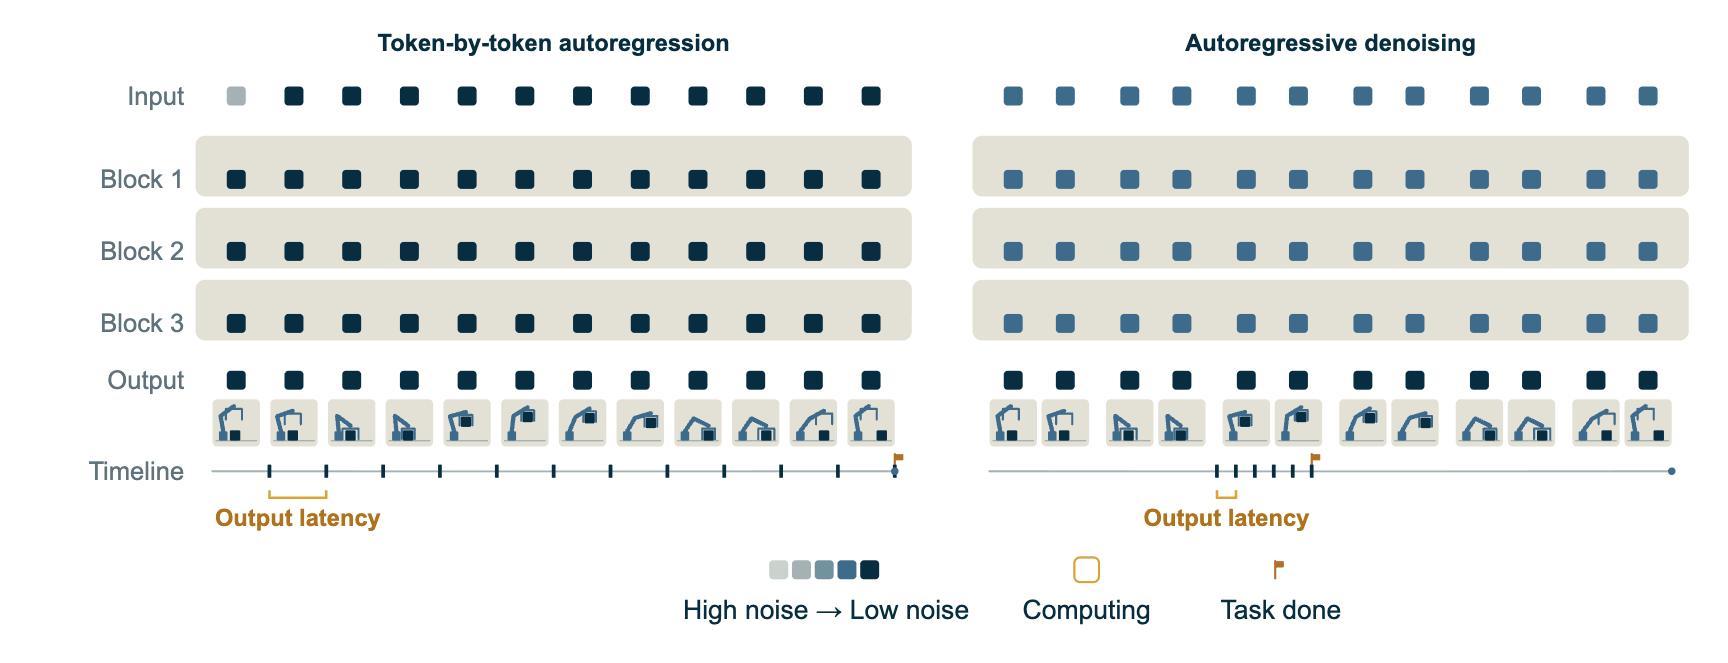
图1 左:逐token自回归;右:自回归去噪。时间轴标出每次输出的时刻:右侧的第一次输出并不更早,但此后的输出延迟短得多,整段更早完成。
生成范式的这一差别,最终落在输出频率上:逐 token 自回归的生成严格串行,每个 token 都必须等待前一个 token 走完所有 Transformer block,输出频率被单个 token 的计算延迟锁死,堆叠再多算力也无法直接加速。
自回归去噪则天然可并行, 同一去噪步内的所有 token 可以同时推进,相邻 chunk 的去噪又前后错开、相互重叠,并行度可以随算力自由扩展,算力越充足,输出频率越高。
而物理世界恰恰以毫秒级的速度持续变化,要求模型以足够高的频率不断刷新对环境与动作的预测;自回归去噪这种可并行、可随算力扩展的生成结构,与高频变化的物理世界高度契合,也为 PhysisServe 的并行设计提供了结构上的出发点。
PhysisServe:让模型规模与输出频率共同扩展
面向物理AI的推理系统 PhysisServe:只要算力充足,即使模型扩展到百亿、千亿乃至万亿参数,系统仍能以任务所需的频率持续输出 —— 参数量与输出频率将可以兼得。PhysisServe 将模型切分为多个 stage,每个 stage 对应某一个去噪步上的某一个 Transformer block,并以 stage 作为算力分配与调度的基本单位。系统设计沿着单路提速、算力共享和多路扩展三个层面展开:
• Stage-wise 流水线。 去噪步与 Transformer block 两个维度同时流水线化,使单路可利用的 GPU 数量扩展为二者数量的乘积。在稳定运行状态下,输出延迟由最慢 stage 的计算时间决定;增加去噪步数或模型深度主要增加流水线深度与所需 GPU 数量,而不再直接降低输出频率。
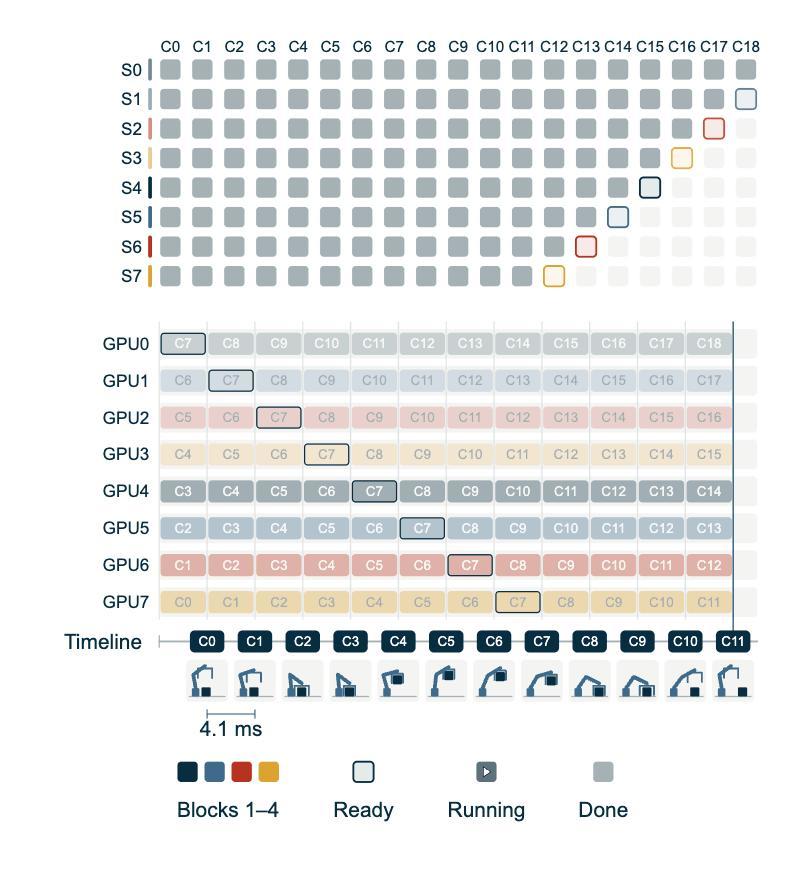
图2 每个stage独占一张卡的Stage-wise流水线(示意2个去噪步、4个block)。上方DAG的每一行对应一个stage、每一列对应一个chunk;下方GPU0–GPU7各执行一个stage,彩色方块表示正在处理的任务。带描边的C7展示单个chunk依次经过8个stage的路径:流水线充满后,最后一级每完成一次计算,时间轴便输出一个新的chunk;时间轴下方示意各chunk对应的动作帧,并标出相邻输出之间的output latency。
• 时分复用。 将 stage 与物理 GPU 解耦,使一张 GPU 能够在不同时间片轮流执行多个 stage 任务。对于同一 block 上来自不同 chunk 的任务,调度器将其合并为 batch 后集中执行,从而复用权重加载和 kernel 调度开销。这样,GPU 的空闲时间可以被其他 chunk 的计算占用,不再要求每个 stage 独占一张卡;在不追求极限输出延迟时,单路请求可以用更少的 GPU 完成,同时满足目标 SLO。
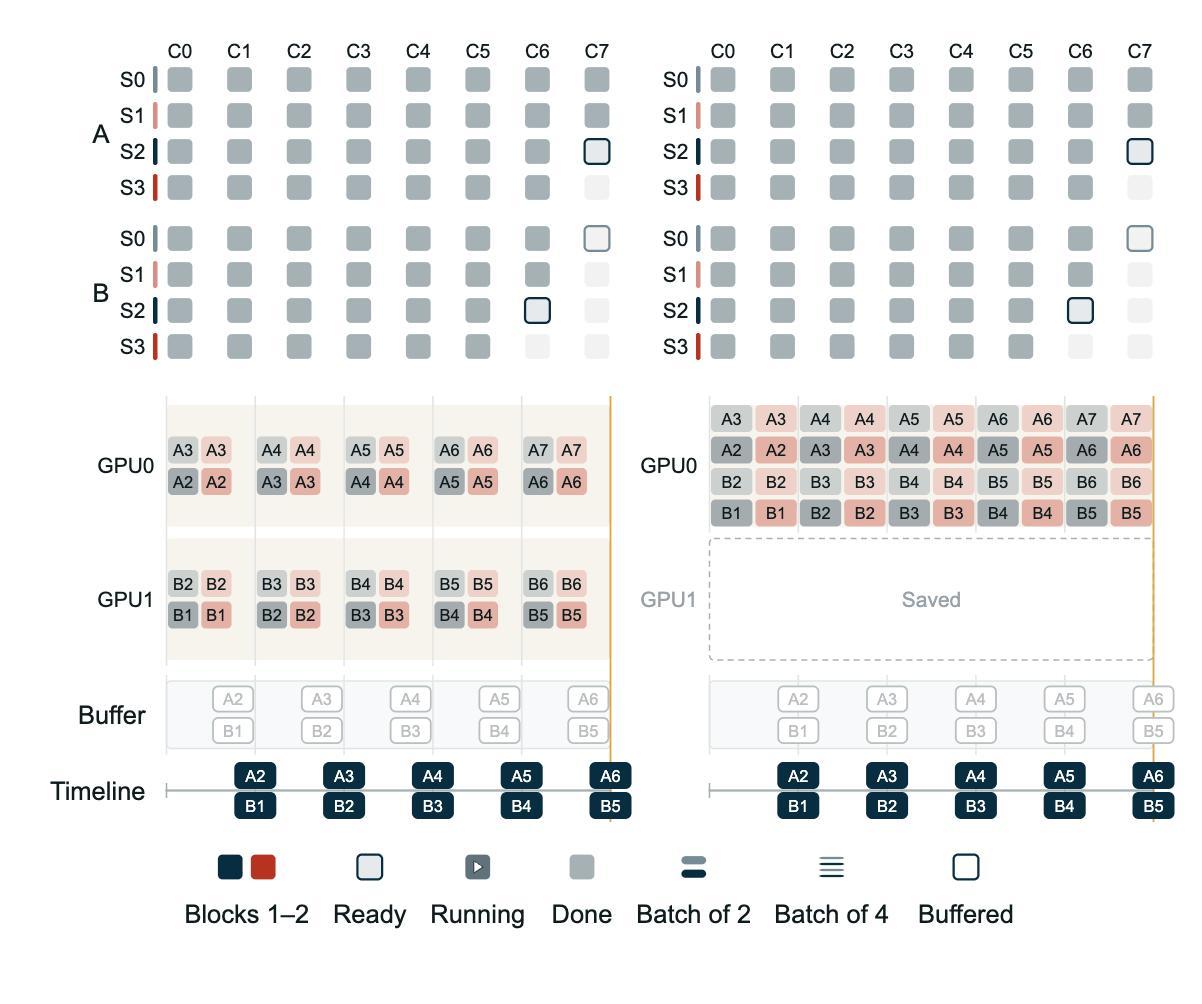
图3 多路之间的时分复用。左边均分卡组,每个batch只含一路的任务;右边两路共享一张卡并跨路合批。Buffer为输出缓存。
• 虚拟 rank 的动态放置。 将每条流在各个 stage 上的计算任务与运行状态封装为虚拟 rank,再将虚拟 rank 映射到物理 GPU。新流到达时,调度器根据各卡的剩余容量为其选择放置位置;只有当整条流的所有 stage 都能被容纳时才接纳,已经运行的流不迁移。这样既能保持已有服务的稳定性,也能均衡卡间负载并利用零散的空闲容量。
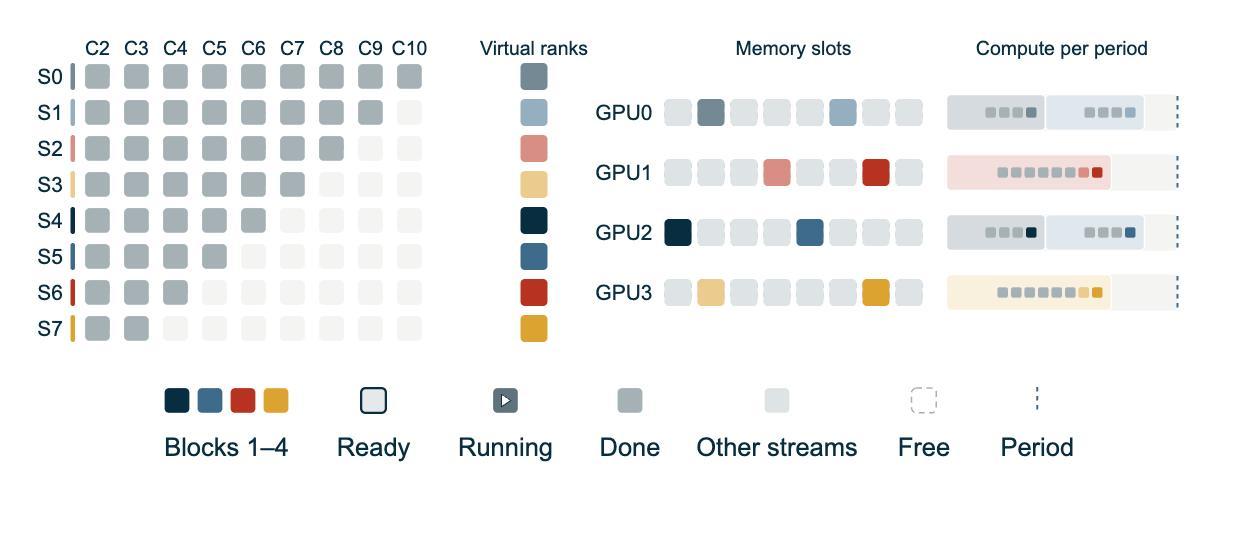
图4 新的一路D的虚拟rank映射到物理rank。每个虚拟rank占一个显存位置,同一block上的任务合批;竖虚线为输出延迟,灰色为正在服务的其他路。
通过在 ACWM 与 WAM 常用的五个 backbone 上评估 PhysisServe:Wan2.1 1.3B、Wan2.2 TI2V 5B、Wan2.1 14B、LTX-2.5 22B 与 MiniMax H3 33B,权重均未经剪枝、压缩或量化。每个 stage 独占一张卡时,33B 的 MiniMax H3 单路极限输出延迟实测为 4.1 毫秒。即每秒输出约 245 个 chunk,用作 ACWM 约合每秒 1000 帧,用作 WAM 最高可达 3900 Hz。
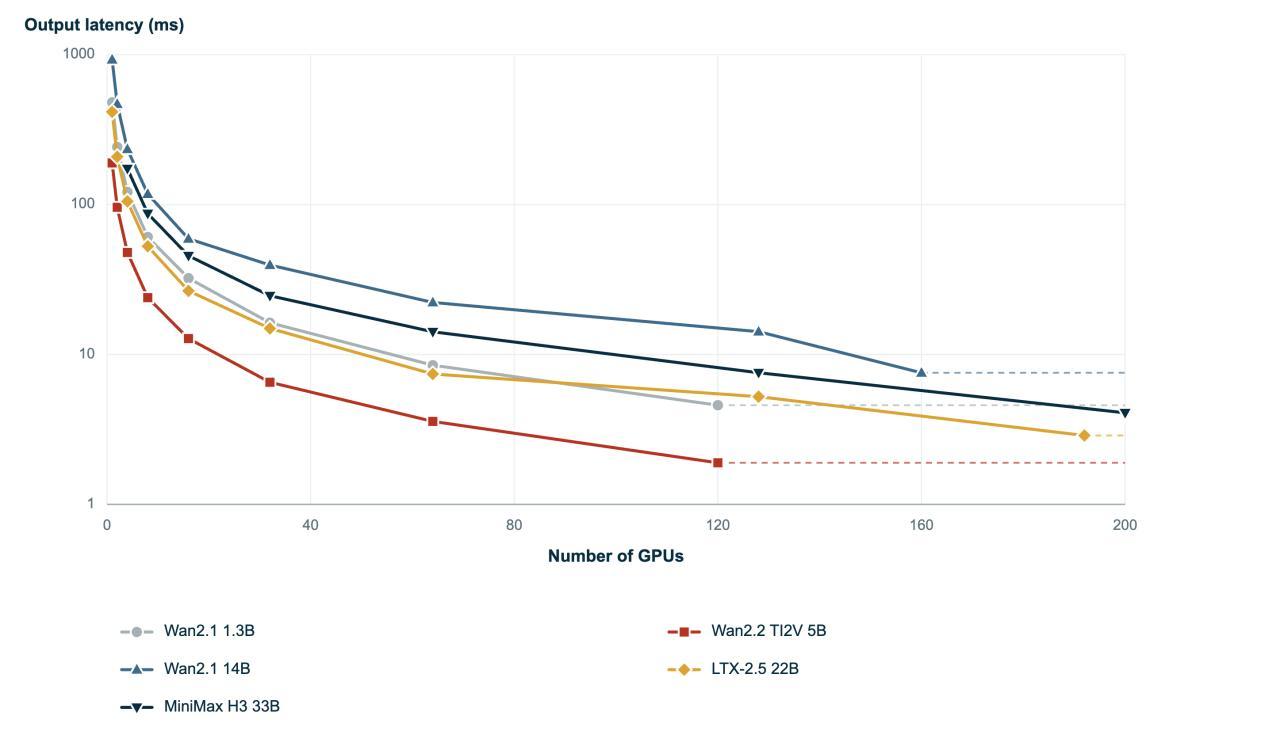
图5 五个模型在不同GPU数量下的单路输出延迟;每个stage独占一张GPU时,延迟收敛到1.9–7.6毫秒。
让智能跟上物理世界的节拍
世界模型越大,对物理世界的理解与预测有望越准确;但物理世界对实时性的要求很高,模型的输出频率一旦跟不上环境变化,再准确的预测也会失去价值。对于基于自回归去噪的世界模型来说,模型规模与输出频率长期难以兼得。这一矛盾的重要原因在于,现有推理方案的流水线切分粒度过粗,限制了其并行度,进而制约了输出频率,使得世界模型的实时性难以随算力增加而持续提升,成为世界模型落地真实场景的主要瓶颈。
PhysisServe 通过 stage-wise 流水线提升单路输出频率,通过时分复用提高单路算力利用率,再以虚拟 rank 和联合调度支撑多路共享,为模型规模与服务能力的共同扩展提供了新的系统路径。
让参数量足够大的模型智能跟上物理世界的节拍,PhysisServe 朝这一目标迈出了探索性的一步。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”