网易智企实测 12 款国产大模型,企业 AI 选型从模型排名走向任务适配
10 月 13 日,网易智企发布「企业 AI 实战评测」系列首期《2026 销售场景 AI 实战评测报告》。作为国内首份聚焦企业真实销售场景、以任务交付为验收标准的大模型深度评测,报告围绕真实销售工作,对 12 款国产大模型展开实测。
本次评测覆盖 DeepSeek、MiniMax、豆包、千问、Kimi、GLM 六个模型厂商,设置线索评估、拜访准备、沟通纪要、商机判断、异议处理、客户跟进、方案与报价 7 项高频销售任务,共形成 420 份实际任务成果。
结果显示,Qwen3.8-Flash 与 DeepSeek-V4.1-Flash 包揽全部 7 项任务第一。其中,Qwen3.8-Flash 在拜访准备、沟通纪要、异议处理、方案与报价 4 项任务中排名第一;DeepSeek-V4.1-Flash 在线索评估、商机评估、客户跟进 3 项任务中领先。
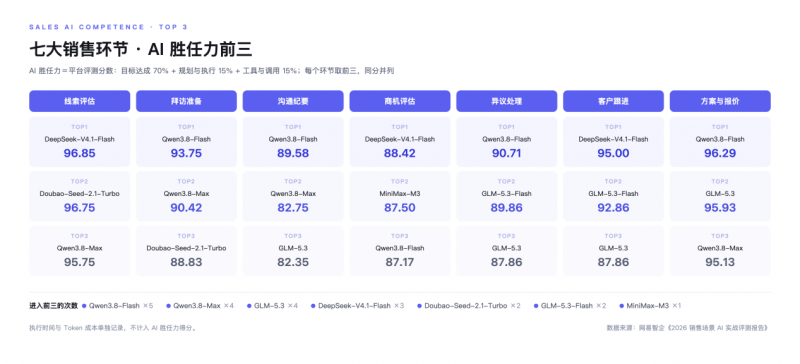
评测围绕 7 项具体任务分别呈现模型表现,并独立记录执行时间与 Token 成本,为企业在不同业务场景下选择和配置模型提供参考。相比寻找一款“整体最强”的模型,报告更关注不同任务分别适合什么模型,以及企业如何在效果、效率和成本之间作出选择。
从通用能力评测走向真实岗位任务
当前大模型评测多集中于知识问答、逻辑推理、数学、代码等通用能力,但企业实际使用模型时,面对的往往不是一道独立的测试题,而是带有业务材料、规则和明确交付要求的具体工作。
以销售为例,一项任务可能同时涉及客户资料、历史沟通、产品信息、价格规则和业务流程。模型不仅需要生成内容,还要识别哪些信息已经确认、哪些仍待核实,并按照既定业务要求形成可以继续使用的工作成果。
基于这一思路,本次评测从真实销售工作中提炼 7 项任务,每项设置 5 个测试样例。12 款模型在同一测试样例下获得相同的业务材料、任务要求、业务规则和交付规范,并统一在网易智企企业级 AI Agent 平台帝王蟹(ClawHive)提供的 Agent 运行环境中完成任务。
最终形成的 420 份成果,包括客户研究报告、拜访作战卡、沟通纪要、商机评估与推进计划、异议应对内容、客户跟进内容以及方案与报价等。
报告将模型在真实销售任务中的表现概括为“销售场景 AI 胜任力”,重点考察任务完成情况、信息准确性、规则遵循和成果可用性,同时独立记录执行时间和 Token 成本。
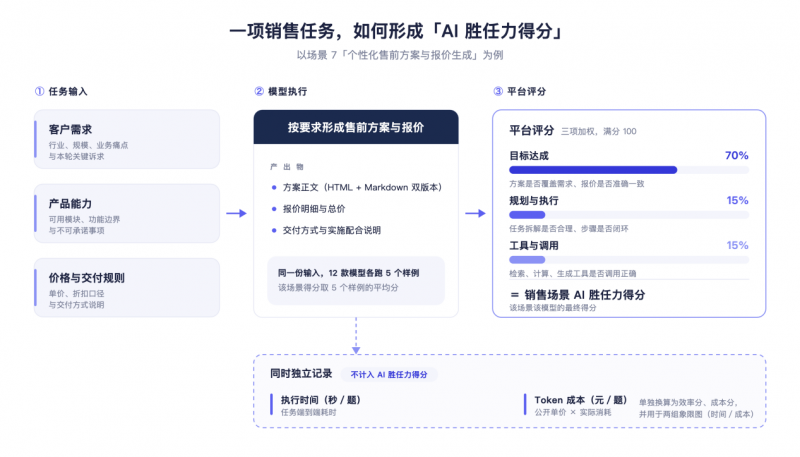
相较于通用能力测试,本次评测更关注模型能否按照企业要求完成一项具体工作。
不同任务各有所长,企业选型需要同时看效果、效率和成本
此次评测中,头部模型呈现出较为清晰的任务分工。
Qwen3.8-Flash 与 DeepSeek-V4.1-Flash 虽然包揽全部 7 项任务第一,但各自领先的任务并不相同。这表明,即使是本轮表现领先的模型,也不存在覆盖全部销售任务的统一优势。企业模型选型需要进一步回到具体任务,而不能只依赖单一综合排名。
同时,评测还发现,任务表现、执行时间和 Token 成本之间并不存在简单对应关系。
以商机评估为例,DeepSeek-V4.1-Flash 的 AI 胜任力得分比 Qwen3.8-Flash 高 1.25 分,但 Qwen3.8-Flash 的平均 Token 成本低约 57.1%。
在异议处理任务中,Qwen3.8-Flash 得分比 DeepSeek-V4.1-Flash 高 5 分,但 DeepSeek-V4.1-Flash 的平均执行时间比前者短约 71.5%。
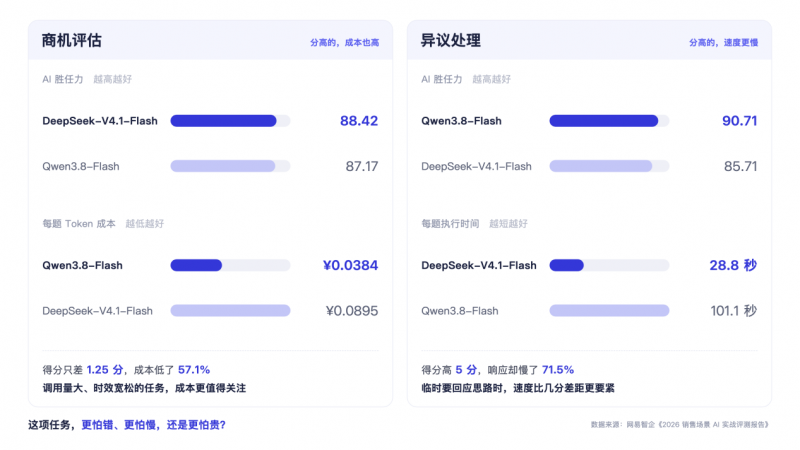
对于企业而言,仅比较任务得分并不足以完成模型选择。准确性要求较高的任务,可能更关注结果质量;需要即时响应的工作,更关注执行速度;在高频、大规模调用场景中,成本又可能成为关键变量。
报告据此提出,企业选模型时,应结合具体任务需求,在准确性、响应速度和使用成本之间找到平衡。
除了不同任务下的表现差异,一些看似基础的销售工作,同样能够明显拉开模型之间的差距。
在沟通纪要任务中,Qwen3.8-Flash 获得 89.58 分,Qwen3.8-Max 获得 82.75 分,两者相差 6.83 分,是 7 项任务中第一、第二名分差最大的场景。
评测显示,差距并不主要来自语言流畅度、结构完整性,而在于模型能否准确识别业务事实边界。例如,“内部已立项”不能直接等同于预算已经审批,“七月底要定下来”也不能自动推断为确定签约时间。
如果类似信息被错误写入 CRM,还可能进一步影响后续商机判断、客户跟进甚至方案报价。
这类差异说明,当大模型真正进入企业岗位后,“写得完整”并不意味着工作已经做对。信息准确、规则遵循以及成果能否继续被后续环节使用,正在成为更重要的评价标准。
从“选模型”走向“跑业务”
评测解决的是不同任务如何选择模型的问题,但模型选型只是企业 AI 落地的一部分。
真实业务通常不是一次独立的模型调用。客户资料会持续更新,产品知识存在版本迭代,报价和交付受到业务规则约束,一次沟通形成的信息还需要继续进入商机判断、客户跟进和方案报价等后续环节。
因此,企业不仅需要判断“什么任务适合什么模型”,还需要解决模型如何理解并持续使用企业知识、业务规则、历史信息和流程上下文的问题。
基于长期企业服务实践,网易智企提出:“AI 懂业务,才算真落地。”
在这一思路下,模型本身并不是企业 AI 的全部。AI 还需要理解业务上下文,调用企业自己的知识和规则,知道当前任务需要完成什么,并形成可以被下一业务环节继续使用的工作成果。
与此同时,不同任务对效果、响应速度和成本的要求并不相同,企业也需要根据具体任务选择和配置更合适的模型能力。
这一任务级选型思路,也已经体现在网易智企企业级 AI Agent 平台帝王蟹(ClawHive)的产品能力中。帝王蟹支持不同模型的接入与管理,并将企业知识、业务工具和工作流程组织进 Agent 运行环境,为不同任务选择和配置模型能力提供基础。
销售宝则是基于帝王蟹构建的销售 AI 员工,覆盖线索评估、拜访准备、沟通纪要、商机判断、异议处理、客户跟进、方案与报价等具体销售工作。本次评测中的 7 项任务,正是参考这些典型销售工作进行提炼,并统一在帝王蟹提供的 Agent 运行环境中完成。
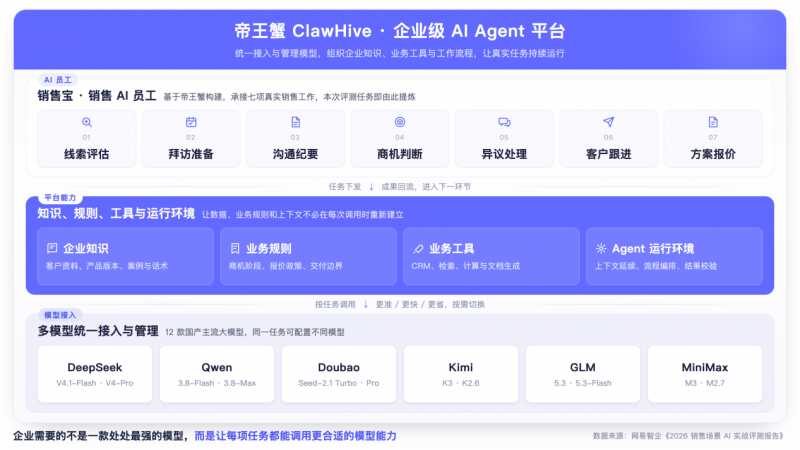
从这一角度看,企业 AI 面临的问题也在从“选择一款什么模型”,进一步转向“如何让不同模型能力在合适的任务中发挥作用,并持续进入真实业务”。
网易智企表示,「企业 AI 实战评测」希望提供的不只是一份模型排名,而是一套更贴近企业实际决策的观察方式:从具体工作出发,判断不同模型适合什么任务,再进一步观察这些模型能力如何进入企业业务。
销售只是第一站。后续,「企业 AI 实战评测」还将继续进入客服、运营等更多企业岗位,以及金融、制造等行业场景,持续检验 AI 在真实业务中的表现,为企业 AI 选型、能力配置和实际落地提供更具体的参考。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”