让手机成为超级智能,千亿参数塞进手机?高通CEO放出2028豪言
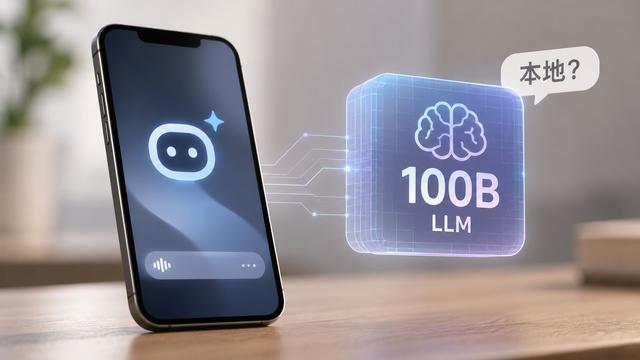
把一个千亿参数的大语言模型装进口袋,随时随地离线运行,这听起来像是科技爱好者的终极梦想。高通首席执行官克里斯蒂亚诺·阿蒙说,这个梦想可能在2028年成真。
在接受Fireside Alpha采访时,阿蒙透露,一些处于AI前沿的公司正在打造能持续运行1000亿参数大模型的智能手机,这类设备可能在2028年问世。
这段采访片段于10月10日在社交平台X上发布,迅速引发科技圈热议。
不过,他以“不便透露名字”为由,没有点明是哪些公司。他还表示,尽管内存供应紧张、价格高企,手机厂商仍会为设备配备大容量内存。
然而,在一片美好愿景背后,两头“房间里的大象”被巧妙地绕了过去:内存从哪里来,又要花多少钱?
千亿参数到底有多“重”
要理解这个目标有多难,得先算一笔内存账。
大模型的参数需要存放在内存中才能运行。如果把一个1000亿参数的模型压缩到每个参数4比特,仅模型本身就需要至少约50GB内存。
为什么参数越多越吃内存?简单来说,每一个参数都是一个需要随时调用的数字,参数越多,需要同时摊开在“桌面”上的数字就越多。
所谓量化,就是用更少的比特来表示每个参数,相当于把高清照片压缩成更小的文件,体积变小了,细节也会有所损失。
这还没算上操作系统、各类应用和上下文缓存所占的空间。而如今主流旗舰手机的内存,大多在12GB到16GB之间。
即便采用更激进的2比特量化,模型本身仍需约25GB内存,在手机上依然难以实现。
更不巧的是,全球正经历一场内存短缺。一年前,部分安卓手机还配备了24GB的LPDDR5X内存,如今受内存危机影响,许多厂商已停止提供大内存版本。
在这种形势下,手机内存短期内很难突破16GB的门槛,离50GB更是相去甚远。
除了内存,发热也是个大问题。持续运行稠密大模型会产生大量热量,引发降频,让手机变成“暖手宝”的同时也拖慢运行速度。
此外,持续高负荷运行大模型,对电池续航也是严峻考验。
工程师手里的几张牌
当然,业界并非束手无策,至少有几条可能的技术路径。
第一条是改进芯片封装。苹果的A20 Pro和高通的骁龙8至尊版第六代芯片,都在一定程度上缓解了这一问题,但内存瓶颈依然存在。
第二条是更激进的量化,甚至压缩到每个参数1比特。但一旦压缩到4比特以下,模型质量就会明显下降,在推理任务上尤为突出。
第三条是采用混合专家架构。
这类模型每处理一个词,只需调用少数几个“专家”模块。活跃的专家留在内存中,其余则存放在闪存里,按需调取。
这就像一个大型图书馆,只把最常用的书放在手边,其余的放在仓库里。
问题在于,手机的存储芯片读写速度远慢于内存,运行速度可能因此大打折扣。苹果此前就曾研究过从闪存运行大模型的方法。
第四条,也是被认为最现实的路线,是模型蒸馏。通过让小模型向大模型“学习”,打造一个200亿到300亿参数、性能接近千亿级水平的精简模型。
这样的模型既能塞进手机,又能提供相当不错的体验,在市场上也更容易推广。
豪言背后的冷思考
阿蒙的表态,折射出整个行业对端侧AI的热切期待。
在手机上本地运行大模型,意味着更快的响应速度、更好的隐私保护,以及不依赖网络的随时可用。对手机厂商而言,这也是刺激换机需求的新卖点。
对高通这样的芯片巨头来说,端侧AI更是兵家必争之地。谁能率先让大模型在手机上流畅运行,谁就可能在下一轮智能手机竞争中占据先机。
但批评者指出,阿蒙的说法缺少清晰的技术路线图,并没有真正推动解决在手机上运行更大模型的现实难题。
内存的物理限制、供应链的紧张局面、散热和功耗的约束,这些都不是一句愿景就能化解的。
过去几年,手机上运行的端侧模型大多在几十亿参数量级。从几十亿跨越到千亿,中间隔着一道巨大的鸿沟。
内存价格上涨还意味着成本压力。即便技术上可行,一部配备超大内存的手机,价格也可能让大多数消费者望而却步。
或许,2028年真正出现在我们手中的,不会是一部硬塞进千亿参数模型的手机,而是一部靠更聪明的算法和架构,用小模型实现大智慧的手机。
无论如何,口袋里的AI革命已经开始。它最终以什么样的面貌到来,取决于工程师们能否在内存、算力和功耗之间,找到那个精妙的平衡点。