Liquid AI开源d1系列决策模型:单次判断仅8毫秒,支持图像输入



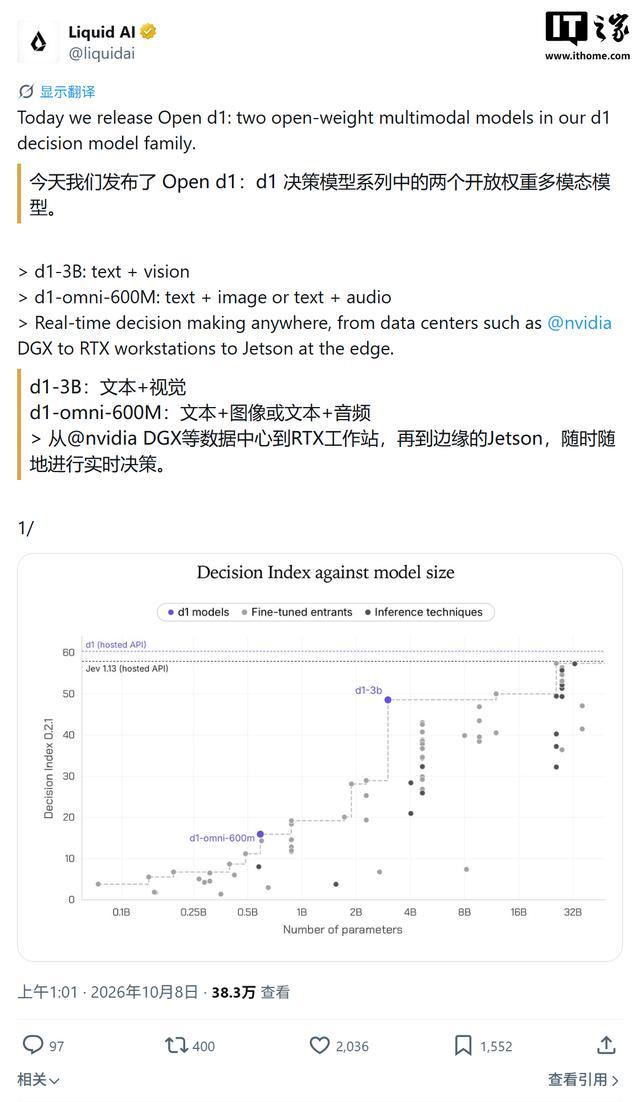
IT之家 10 月 9 日消息,Liquid AI 于 10 月 7 日发布博文,宣布推出 d1 系列两款开放权重决策模型:d1-3B 支持 31.2 亿参数的文本与图像判断,d1-omni-600M 以 5.87 亿参数支持文本、图像及语音输入。
IT之家援引博文介绍,在 Jev 模型 9 月推出爆火后,OpenAI 等公司也相继推出类似的决策模型,而 Liquid AI 是加入该战局的新成员,本次推出的 d1-3B 与 d1-omni-600M 已在 Hugging Face 公开,用户可下载、微调并部署。
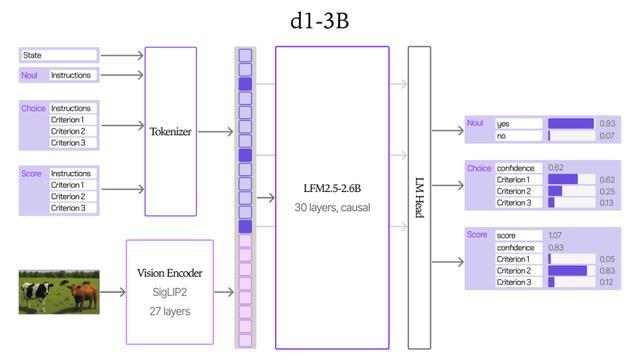
d1-3B 拥有 31.2 亿参数,基于视觉语言模型 LFM2.5-VL-3B 训练,支持文本与图像输入。该模型在 Decision Index v0.2.1 公开测试集获得 48.57 分,Liquid AI 称其领先所有 10B 以下模型。
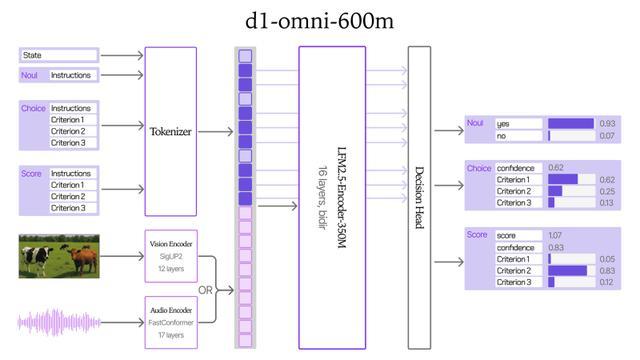
d1-omni-600M 拥有 5.87 亿参数,基于双向编码器 LFM2.5-Encoder-350M 训练。该模型支持文本与图像,或文本与语音的组合输入,属于 Liquid AI 首个实验性多模态决策模型检查点。
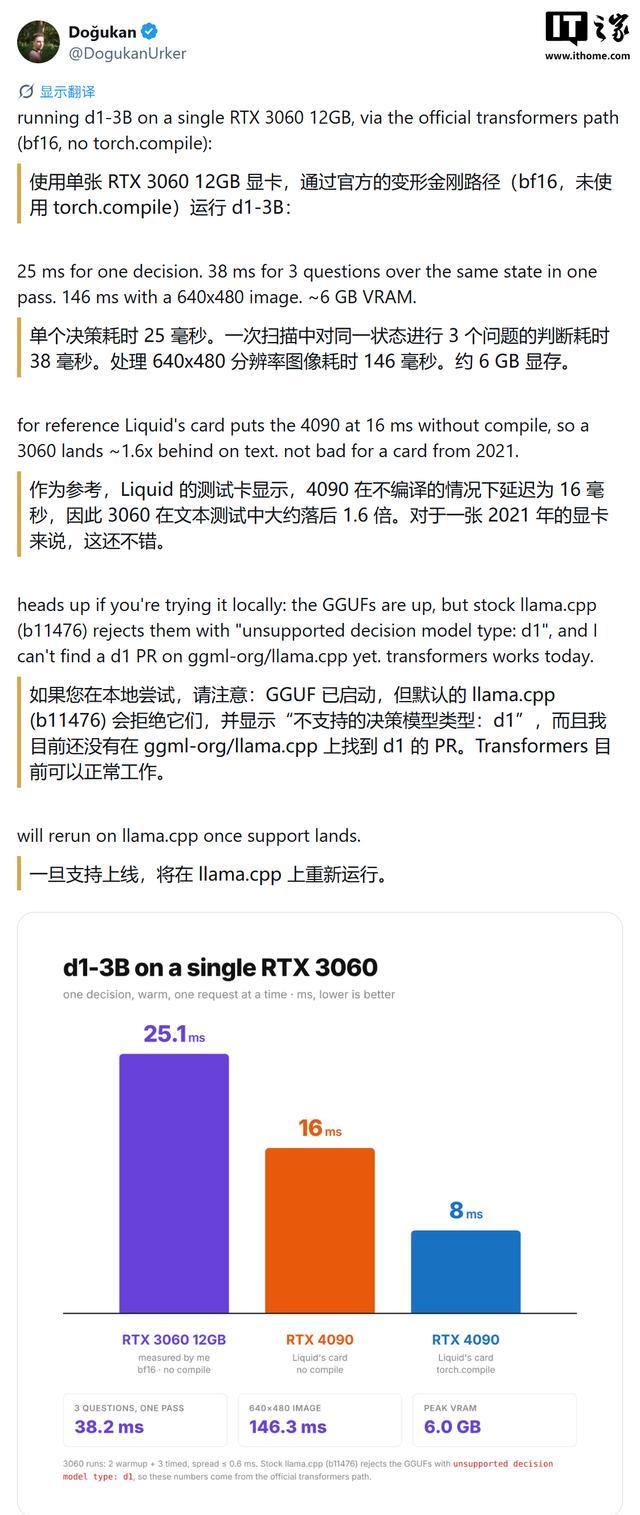
在推理速度方面,d1-3B 在 NVIDIA RTX 4090 上回答单个问题耗时 8 毫秒,处理 384 像素图像耗时 102 毫秒。在 Jetson AGX Thor 上,单问耗时 16 毫秒;在 Jetson Orin Nano 上为 50 毫秒。
用户测试显示,d1-3B 在 12GB 显存的 GeForce RTX 3060 上,单次判断耗时 25 毫秒,处理 640×480 像素图像耗时 146 毫秒,峰值显存占用约 6GB。另有用户报告,该模型在 RTX 3090 上单次判断耗时 8 毫秒。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”