火箭回收的“命门”,被国产算力拿下了



火箭回收,难在何处?
一个常被忽视的答案是:尾焰。
可重复使用火箭普遍采用多发动机并联方案。起飞和回收反推时,数十台发动机喷出的超声速高温尾焰在箭尾相互干涉,形成复杂激波与湍流,剧烈的压力脉动威胁着箭体与发动机的结构安全,尾焰交汇区的高温则考验着箭底防热设计的极限。
业内专家一句话点破要害:不厘清这套干扰机理,火箭回收安全和发动机复用可靠性就无从保障。
但问题是,这套机理极难看清。真实试验成本高昂、测点有限,多喷流之间、喷流与来流和箭体之间的相互作用,需要在极大空间范围内追踪激波、剪切层和回流的演化。放眼全球,这都是AI4S方向上一块公认的“硬骨头”。
近日,这块硬骨头被啃下了。
西安交通大学AI4S科研团队依托曙光8000异构计算平台,完成了33喷口火箭发动机阵列超声速尾焰的超大规模高保真数值模拟,计算规模高达6.774万亿网格单元,成为已知规模最大的超声速时空耦合高精度模拟算例。这相当于为火箭发动机集群的尾焰,拍摄了一套超高分辨率的CT影像,科研人员第一次可以如此直观地看清尾焰干扰的全貌。
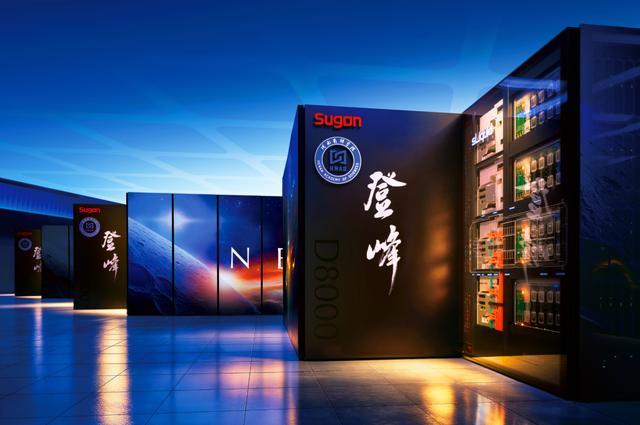
数字背后,还有一个更值得玩味的事实:支撑这次攻关的,是数万张国产GPU协同工作的国产算力底座。
国产算力的“极限压力测试”
十万卡级的大规模计算,业内有一个共识:核心瓶颈从来不是硬件峰值算力。
显存带宽的约束、跨节点通信的开销、数值算法架构与硬件之间的适配矛盾,每一项都足以让一堆昂贵的加速卡变成“高性能的摆设”。卡数翻四倍之后,每张卡是否还在干有效计算?这是比跑分残酷得多的考题。
曙光8000交出的答卷,可以说相当硬气:
弱扩展效率99.01%,并行规模扩大四倍、总网格量同步增加四倍时,平均单步耗时仅增加约1%。换句话说,增加的算力几乎没有被浪费。
强扩展效率73%——总网格量不变、四倍资源投入时,仍获得了约2.92倍加速。要知道,在通信密集型的CFD计算中,这是相当亮眼的成绩。
网格更新吞吐率34.029 TCUPS,按主计算路径折算,应用浮点性能约0.249 EFLOPS。
这组数字的分量在于:它不是实验室里的理想化测试,而是在真实科研任务上,数万张国产GPU长时间稳定协同输出的结果。分区是否均衡、通信是否可控、流程是否可靠——任何一个环节掉队,整体性能都会崩塌。而曙光8000的大规模平台与运行环境,把这一切稳稳托住了。
深度适配彰显真功夫
高端科学仿真,从来不是算力硬件的简单堆砌。
举一个典型例子:传统CFD计算多采用多阶段龙格库塔算法,每一步都要反复读写全场数据、交换边界信息。放在数万卡规模下,这种反复的数据搬运就是“效率杀手”。
西安交大团队针对曙光8000国产加速卡的硬件特征,做了一次漂亮的“算法原生化”改造,利用WENO-GKS方法的时空耦合特性,采用单步时间推进,把多阶段反复读写转化为界面局部计算,大幅削减显存读写频次和跨节点通信量。再配合SoA数据布局、算子融合、计算与通信重叠等手段,让每一次数据读入都“物尽其用”。
这套协同创新的落地,离不开曙光8000提供的完整软件栈:从DTK开发环境、编译工具链到MPI通信库、作业调度体系,形成了一片让自研算法生根发芽的土壤。调试数万卡规模的作业时,设备映射、绑核策略、进程拓扑的每一个细节,都有平台能力的坚实支撑。
这次协同攻关证明:软硬件深度适配、原生协同创新,才是突破性能瓶颈的关键。这也正是曙光8000区别于“单纯堆卡”方案的核心竞争力。
算力为基,应用为翼
从气象预报、黄河水沙模拟、数字孪生脑,到此次助力商业航天领域,曙光8000正在驱动国产算力进入重大科研工程的核心研制环节。
过去,国产高性能计算更多聚焦硬件指标的突破;而这一次,算力硬件、自研算法与工程仿真场景实现了深度耦合,验证了国产全栈技术链条服务高端装备研制的可行性。研究团队完全自主搭建的高精度求解体系,填补了国产高性能计算平台上多喷口超声速射流超大规模高精度模拟的空白。
落到具体的工程价值上,这套自主的仿真体系能做的事还有很多。
在结构载荷方面,它可以提取结构表面压力及其时间历程,分析局部峰值与载荷分布,辅助确定试验测点;在防热设计方面,它为壁面热流、温度分布和受热持续时间的精准掌握提供依据,这是传统试验测点之间无法覆盖的盲区。
试验与计算之间,正在形成一条连续反馈的闭环,让昂贵的试验资源聚焦到关键工况上。
而这次成果的辐射效应,远不止于航天。
研究团队已经给出了清晰的路线图:近期围绕多发动机尾焰干扰,结合工程需求引入实际几何与发动机工作状态,积累经过验证的流场数据;中期依托这些数据开展智能建模,研究设计参数与流动响应之间的关系,为反复进行的方案筛选提供高效工具;应用对象上,从重型、超重型运载火箭的多发动机尾焰干扰,逐步拓展到着陆器喷流干扰、高速飞行器外流与喷流相互作用等复杂可压缩流动问题。
而对曙光8000来说,这次合作沉淀下来的经验,同样会反哺平台本身。科研应用中积累的计算、通信和存储需求,将直接用于下一代平台的配置与优化,这正是一条“应用需求牵引平台迭代、平台能力反哺应用深化”的良性循环。
随着AI4S前沿应用持续落地,国产算力的评价标尺,已经从单纯峰值算力的比拼,转向面向重大工程的高精度仿真、软硬件协同适配与大规模并行稳定输出的综合能力。而这,恰恰是曙光8000最擅长的事。
火箭尾焰的“CT影像”已经拍下,国产算力的“成色”已经验证。可以预见,曙光8000将成为越来越多重大科研任务的算力标配——算力为基,应用为翼,一个强大而健全的国产算力生态,正在加速成形。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”