老黄最担心的事还是发生了?DeepSeek开始帮华为拆CUDA的墙
这几天除了Personal Agent(个人智能体)之外,AI圈还有条新闻受到关注:DeepSeek下场帮华为开放芯片算子的新闻。
9月30日,DeepSeek宣布与华为合作,围绕昇腾AI芯片开源一系列编程基础设施,包括计算库、通信库,并推进一套基于128颗昇腾950的Supernode(超节点)方案。
这其中最值得注意的是TileLang,一种试图让AI芯片编程变得更简单的高层编程语言。
不少媒体都在说:“老黄最担心的事还是发生了,华为即将攻破CUDA生态。”
事实真的如此吗?
前哨会员对此应该不会太陌生。王煜全早在2023年就和大家讨论过:英伟达真正的壁垒早已经不只是CUDA。
今年的AI产业追踪里,我们又反复提醒大家,CUDA这道曾经最难复制的软件壁垒,也正在被AI一点点拆解。
DeepSeek和华为这次合作,更像AI时代产业范式加速变化的一个缩影:AI一边降低旧壁垒的追赶成本,一边又把竞争推向超节点、AI工厂和更完整的产业生态。
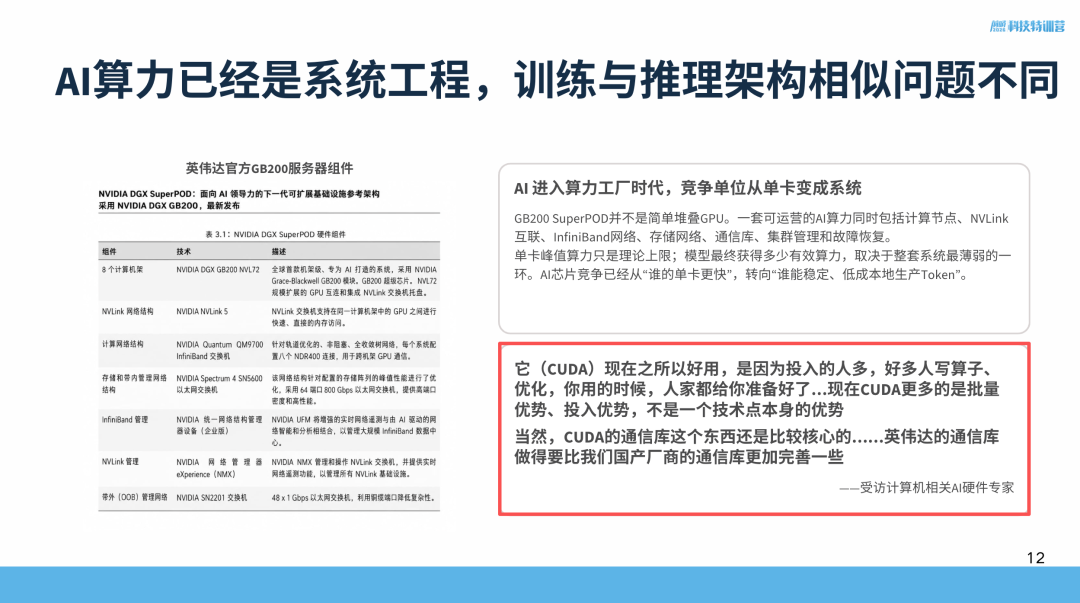
7月前哨专题《国产AI芯片产业链扫描》PPT
DeepSeek为什么要亲自下场帮华为写软件?
先看这次DeepSeek到底在做什么。
一颗AI芯片真正跑起来,中间其实隔着好几层。
最底下当然是昇腾950这样的硬件,但有芯片不等于模型就能高效运行。
你还需要大量针对硬件优化过的Kernel(计算内核),去完成矩阵乘法、Attention(注意力计算)、量化、MoE(混合专家模型)路由这些最基础的操作。
这就是DeepSeek这次开放计算库的意义。
同样一个计算任务,普通代码可能只能发挥一半芯片性能,一个高度优化的Kernel却可能把硬件性能吃到八九成以上。
所以很多时候,我们看到的“芯片性能差距”,里面其实混着巨大的软件差距。
第二层是通信。
现在的大模型早就不是一张卡独立完成计算。几十张、几百张甚至几万张芯片必须一起工作,尤其是DeepSeek这样的MoE模型,不同专家可能分散在不同芯片上,每一次训练和推理都需要大量数据来回交换。
如果通信库做不好,128颗芯片并不会自动变成一台强大的机器,只会变成128座互相堵车的小岛。
所以DeepSeek这次开放通信库,和华为推进128颗昇腾950组成的Supernode(超节点),其实是一体两面,解决“一群芯片怎么一起算”。**
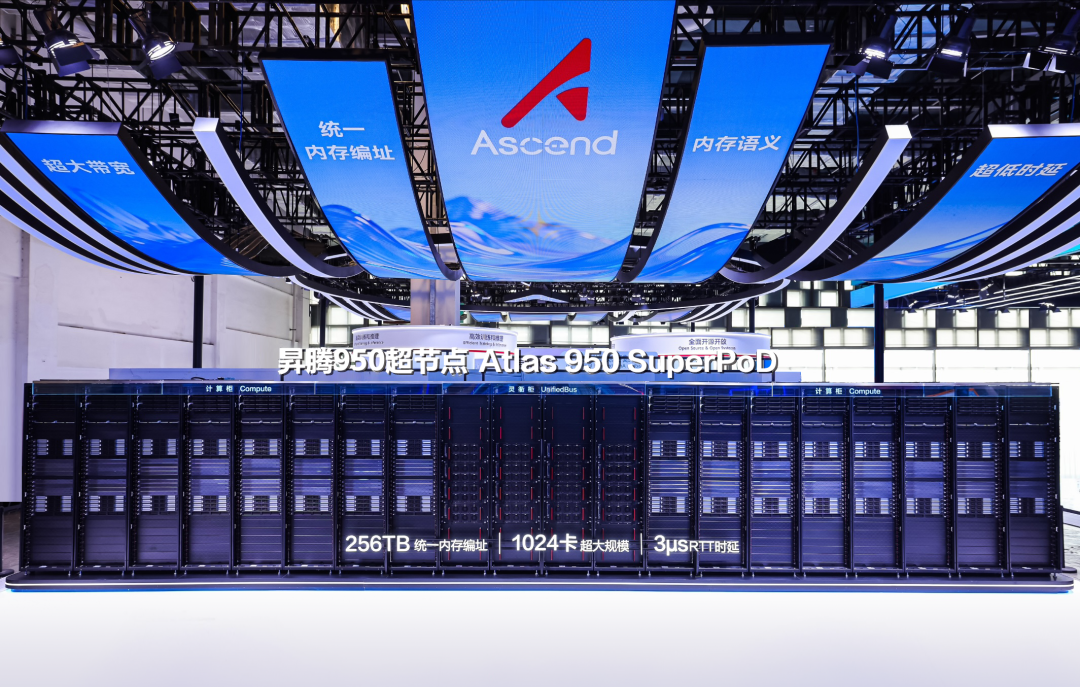
华为昇腾950超节点
然后才轮到TileLang。
过去想把GPU(图形处理器)性能压榨到极致,工程师往往要非常理解底层硬件:数据怎么分块、内存怎么搬、线程怎么排、哪些数据放进高速缓存。
CUDA厉害的地方,就是英伟达用了近二十年,把这套复杂工作逐渐包装成成熟的软件栈和开发体系。
TileLang则试图再往上一层。开发者不必从头告诉芯片“每个线程具体怎么干”,描述“我要完成什么计算、数据如何分块、数据之间是什么关系”,再让编译器把它翻译成适合不同硬件的底层实现。
TileLang已经开始支持CUDA、ROCm(AMD开放计算软件栈)、Metal(苹果图形与计算接口)等不同后端,面向华为昇腾也出现了TileLang-Ascend(TileLang昇腾适配)。
DeepSeek还基于TileLang开源了TileKernels(高性能计算内核库),把MoE路由、量化等真实大模型里的高性能算子放进去。
所以DeepSeek亲自来做这件事一点也不奇怪。
芯片公司知道硬件怎么设计,模型公司却最清楚真实的大模型到底怎么“折磨”硬件:哪个算子最耗时间、MoE的数据怎么流动、通信堵在哪里、哪些环节最值得优化。
过去是华为造芯片,模型公司来适配;现在开始变成模型公司反过来参与定义,下一代芯片到底应该怎么被使用。
这才是这次合作真正重要的地方。
AI正在成为攻克CUDA的一件新武器
如果只看DeepSeek,很容易误以为这是中国特有的国产替代故事。
实际上,今年整个AI芯片行业都在发生同一件事:大家开始用AI写“运行AI的软件”。
AMD就是最典型的例子。
过去开发者把CUDA项目迁到AMD的ROCm,虽然已经有HIPIFY(CUDA代码迁移工具)这样的自动翻译工具,但仍然麻烦,要改算子、调内存、适配不同GPU架构,再不断修Bug(程序缺陷)。
现在AMD正在把Agent(智能体)直接引进这个流程。
它的MOAT(多智能体迁移工具)可以让Claude Code(Claude代码智能体)或者Codex(代码智能体)自动阅读一个CUDA项目:一个Agent分析代码,一个负责迁移,一个审查修改,另一个直接在AMD GPU上测试,失败后再返回继续调整。
今年推出的ROCm.AI(AI原生ROCm开发环境)又往前走了一步。
Claude、Codex、Cursor(AI编程工具)、Gemini(谷歌AI模型)都可以直接调用AMD提供的Skills(技能),帮助开发者安装环境、部署模型、寻找问题;Hyperloom(自动性能优化工具)甚至会自己寻找推理瓶颈、修改Kernel,再验证性能有没有提高。
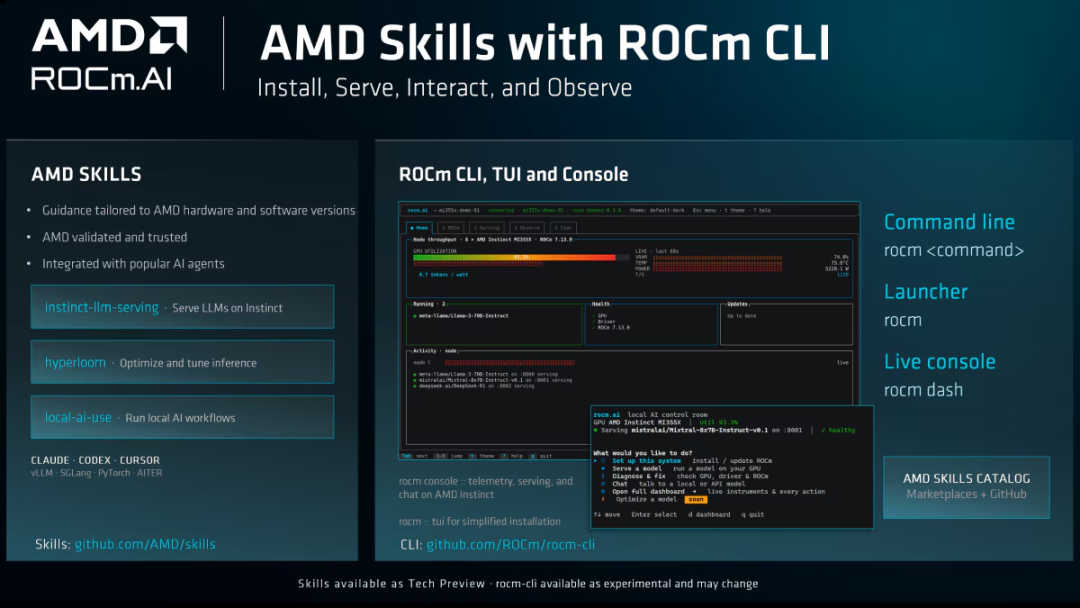
AMD ROCm.AI智能体开发工作流
今年7月,Anthropic和AMD签署大规模合作时,双方还明确写进协议:Claude会帮助AMD优化GPU工作负载,加速ROCm开发。
这已经非常接近“AI自己帮助竞争芯片补软件生态”。
另一边,我们介绍过的Modular也一直在做类似的事情。
它用Mojo(编程语言)和MAX(AI推理平台),希望开发者写一次程序,底层系统尽可能替他处理不同芯片之间的差异。
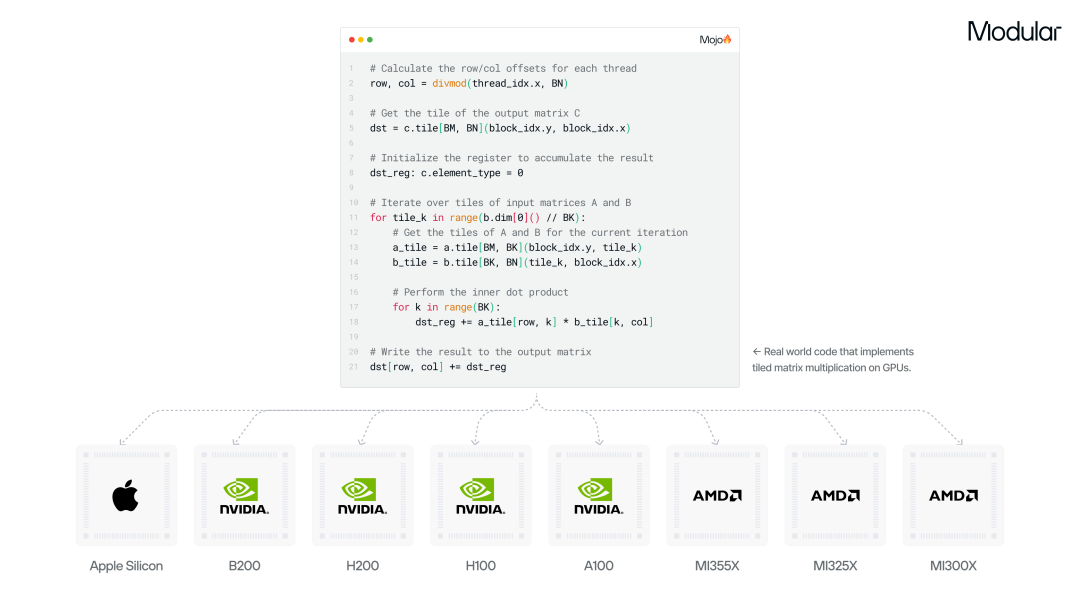
Mojo跨不同GPU硬件运行示意
OpenAI的Triton(高层GPU编程框架)走的也是这个方向。有意思的是,英伟达自己今年也开始给Triton提供CUDA Tile IR(CUDA分块中间表示)后端,让开发者继续使用更高层的编程方式,再由底层系统映射到英伟达硬件。
Google甚至发布了JAXBench(TPU内核优化基准),专门测试AI Agent能不能自主优化TPU(张量处理器)的底层Kernel。
这些看起来分散的动作,其实都在指向同一个变化:CUDA锁住开发者的软件壁垒,正在被AI快速攻破。
AI竞争的单位,已经从公司变成生态
这才是DeepSeek和华为这次合作更值得关注的地方。
如果只是比较一颗芯片快多少、一个编程工具好不好用,很容易低估今天AI产业的复杂程度。
英伟达这些年真正做的,就是不断把竞争单位往上推:从GPU到CUDA,再从CUDA走向NVLink(高速芯片互连)、NVSwitch(高速交换芯片)、网络、机架、超节点和AI Factory(AI工厂)。
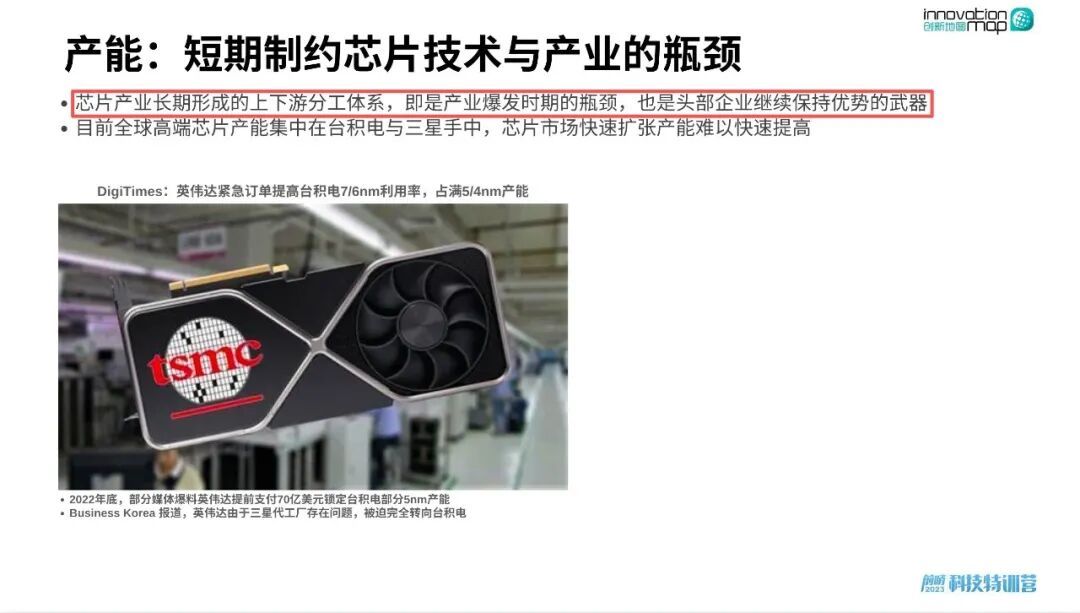
2023年6月《英伟达&AI芯片企业分析》专题PPT
所以前哨早在2023年就提醒大家,英伟达真正的生态壁垒已经不只是CUDA。
今年我们继续追踪AI如何反过来降低CUDA这样的旧软件壁垒,看到AI的竞争早已不是DeepSeek对英伟达、华为对英伟达这种简单的“一家公司打另一家公司”。
它越来越像一组生态和另一组生态之间的竞争,而且竞争与合作会同时存在。
大家会争标准、争入口、争利润,也会在不同层级上彼此合作。
这才是这件事真正反映出的趋势:AI正在加速技术迭代,也在加速产业重新组合。
未来决定胜负的,是谁能把模型、芯片、软件、开发者和应用组成一个迭代速度更快、成本更低、协同效率更高的生态。
这也是王煜全和大家持续追踪科技产业的价值所在:不只看今天谁发布了什么,更要看技术变化之后,新的产业壁垒又在哪里形成。
十一期间购买或续费前哨科技特训营会员,还可获赠蓝区“几岁”健康手环1个,并享AI王煜全5倍Token(令牌)使用量(每人每月提问上限300次,已享每月300次额度的会员不再额外增加)。
如果你也想持续跟踪这些真正改变产业格局的信号,欢迎趁十一活动加入前哨科技特训营。