
DeepSeek为什么要16000张卡?



2026年5月的一场业绩说明会上,中芯国际联席CEO赵海军讲了一句话:
人工智能在海外的「虹吸效应」,让消费和IoT客户跑到内地来找产能。订单在往回流。
他还说了一句更要紧的:客户因为担忧供应不足,在提前备货。这话翻成大白话就是,现在买卡的人最怕的,是以后买不到。
那为什么买不到?得从产能说起。
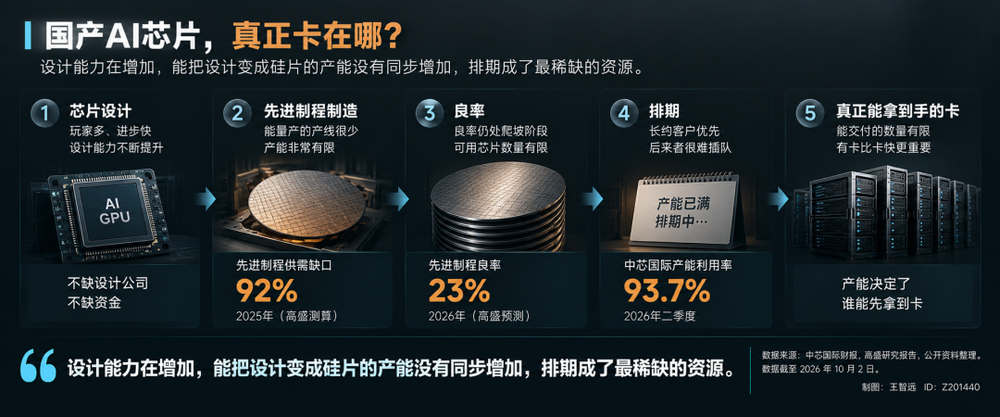
中芯国际最近一个季度的产能利用率是93.7%,这是它自己财报里写的数。
更实在的一条在2月,赵海军说,去年公司新增了大概5万片12英寸产能;今年年底比去年年底,月产能还要再增4万片。
一年多扩产,折成12英寸晶圆4万片。对一家公司不算少,对一个行业是杯水车薪。中芯自己讲得清楚,我们不做GPU等AI主芯片。
它做电源管理、数据传输这类配套芯片,这些也供不应求。赵海军的原话是「公司受限于自身产能,正在积极调配资源优先支持」。
真正造AI芯片的那条线,全国能规模量产的,就一条。它一年能出多少东西?
高盛8月24日发了份报告,算先进制程晶圆的供需缺口。2025年这个数是92%。什么概念,一百片的需求,国内只能供上八片,剩下九十二片得看别人的脸色。
这份报告的话说到2035年。那一年缺口收窄到34%,中国先进制程月产能41万片,国内需求61.9万片。
十年时间,缺口从92%降到34%。压缺口靠供给端,每年46%的复合增速,需求端只有17%。
头几年得先把良率这道坎补上。高盛假设中芯的先进制程良率,从2026年的23%往上爬,2030年到50%,2035年到75%。
对照台积电,2018年量产7纳米起,良率现在已超过90%。23%是什么意思?同样一百片晶圆,能凑合用的只有二十来片,剩下七十多片全是白扔的。
到2026年,五家已上市的国产AI芯片公司,按券商引用的市场一致预期,收入同比要增长120%,加起来盘子257亿。钱在往这个方向涌。
而去年,国产AI加速卡出货165万张,全市场400万张,国产占了四成。
这个四成算全部AI加速卡,各种制程一锅端。前面那个23%算7纳米以下的先进制程,两笔账不在一个池子。
份额听着不低,可这里有个错位。国内做AI芯片的,设计这一侧从来不缺人,也不缺钱,设计能力在往上走,制造能力卡在那儿。真正稀缺的是把图纸变成硅片的地方。
中芯国际今天最抢手的产能,握在签了长约的人手里。
赵海军在业绩会上讲过,产能分给谁的先后次序,第一原则是过去跟客户之间的相互承诺。「并不是一个后来者突然出现,给了更高的价钱,我们就去做。」
活儿是中芯先挑的。可对排在后面的人呢?
去年出货165万张里,有一部分设计能力不差,就是排期靠后;有人的流片从一季度推到二季度,再推到等通知,投资人问量产时间,他答不上来,答案不在他手上。
所以,卡住国产AI芯片的是排期表。
产能不够,那就买不到;买不到,就只能用国产的。可用国产的这件事,比买不到更难对付。
一个写了五六年CUDA的工程师,换到另一套芯片上,攒下的调优经验全要重来,查资料的路径、手里的工具链也一样。
芯片跑得快不快,早就不是卡点了。性能上来了,用的人上不来。卡点在人,在会不会用,这道坎比造芯片还难。
......
9月30日,DeepSeek开源了六个组件,它要解的就是这后半截。芯片能不能跑,DeepSeek三年前就交过卷了,现在轮到人。
那六个组件,编译器、计算库、通信库都有,公告末尾有一句关键的话,所有组件与此前面向英伟达平台的开源组件一一对应。
评论区当天挺热闹。这句话的分量,得自己去仓库里数。我去数了三件事。第一件,六个组件里四个早就有了。
DeepGEMM-Ascend是矩阵乘法的库,建在9月29日晚上;DeepEP-Ascend是通信库,建在30日凌晨。这两个确实是新的。
剩下四个。跑向量计算的TileKernels是今年4月,做注意力算子的FlashMLA去年2月;做数据筛选的DeepSelect是9月9日,TileLang更早,2024年10月。
六个仓的建仓时间都在GitHub上摆着。官方说的「开源」,是这六个东西当天对齐到昇腾,不等于当天从零写了六套。
第二件,TileLang到底是谁写的?
一直有人说这是DeepSeek自研。去年9月它开源V3.2算子时就有这说法。
梁文锋在投资者交流会上也讲过,训练V3时已几乎不依赖英伟达的软件生态,全部基于自研的TileLang完成。
可论文的署名摆在那儿。核心作者十一个人,北大六个,帝国理工一个,微软亚洲研究院四个,里头没有一个DeepSeek的人。
所以严格说,这门语言不是它写的。「自研」这个说法,多半是把「深度参与」讲成了「自研」。
论文发在2025年4月,项目当年1月开源,比这次公告早一年半。
DeepSeek在里头另做了两件事。
先用TileLang写了自家模型训练里的大部分算子,拿产品给这门新语言做压力测试。
「算子」就是模型里一个个具体的计算动作。然后它把训练里用到的每个算子在昇腾上重做一遍。官方的原话是,训练中用到的每一个TileLang算子,在昇腾上都有对应的高性能实现。
先有模型,后有算子清单,再让芯片照着清单去适配。DeepSeek出题,芯片动手。
华为那边出的力也不少。超节点组网是两边一起定义的,128卡做到3.2Tbps单层交换,成果还在华为自己的CANN社区同步开源。
第三件,性能数字的实测口径。
官方的说法是,跨卡发送的带宽做到每秒375 GB,把结果聚回来的每秒347 GB,接近硬件上限。数字没错。
卡和卡之间要交换一大堆数字。跨卡发送,等于一屋子人互相递东西,人手一份;聚合,等于各人手里的东西收回到一个人手上。人多了必慢,官方报的那个上限,是8卡规模下的成绩。
375是8卡规模下的最好成绩,卡数往上翻,32卡落到335,128卡掉到313;聚合那头更明显,347一路降到272。
卡数翻了十六倍,单卡分到的带宽掉了不到两成,这个成绩不算难看。
再往后还有个时间差。这组数字出自给DeepSeek的测试版硬件,加手工配置。要让满带宽跑起来,得等配套的那版商用固件。
按DeepSeek自己开源仓库的说明,那版固件计划10月中旬公开,大概15日,并注明这是厂商计划,以华为发布为准。硬件已经在卖了,缺的是让它跑满的那一版。
口径差这么一点,决定这套东西眼下解决了什么。适配一个昇腾算子,过去按周按月算;现在写在TileLang里,后端换个编译器。省下的是时间。
有人会问,中立层这活儿不是早有人干吗?
FlagOS 2.0今年3月发布,二十三家公司一起做,覆盖十八家厂商三十二款芯片,统一表示层第一批适配名单里就有昇腾。
不过它管系统软件栈那一层,统一表示、算子库、框架插件、跨芯片发布都在它那儿,TileLang管的是语言这一层。
北大在两边的名单里都有,上游下游,谁也替不了谁。这两层合起来要解决的就是这后半截。人会不会用,得有人把路先摊平。
......
7月流出来的那份交流记录,有句话最怪。
梁文锋谈起华为超节点和英伟达的价格差,说了一句,贵百分之一百无所谓,贵百分之两百都无所谓。买家的本分是砍价。他这话等于把价签当场撕了。
正常情况,嫌贵可以不买。他嫌贵,还准备买,那两倍溢价在他眼里换的就是别的。
一个准备下单十六万颗芯片的人,把价格放这个位置,不是姿态。他那本账里,芯片的价钱已排不到前头。
那他买的到底是什么?同一场交流,他还说过一句,唯一的瓶颈是产能。
华为要四张卡才顶英伟达一张,迭代节奏还落后大概两年,这些他都认,摆完还说贵两倍无所谓。
账要这么算才通。他要的是能确定拿到手的卡,价格往后放。
他说,华为给DeepSeek的产能大概一万六千张卡。同一场里他还提了一句,互联网大厂拿十几万张。
一万六千张是什么量级?按他自己的算法,相当于四千张英伟达的卡,做不了下一代模型。
他还留了后半句,但足够帮华为把生态跑通。先认不够用,再说够干什么,这顺序有讲究。
订单那头还有个数:
彭博社9月的报道说,DeepSeek计划部署至少十六万颗昇腾950DT,用在内蒙乌兰察布在建的1GW数据中心。报道里提到,华为这颗芯片年产能约几十万颗,这一笔得慢慢交,可能拖上一年。
一头下了一年的单,一头一年只出得来几十万颗。谁手上有卡,谁就是稀缺的那一方。
他多付一倍两倍的钱,换先把卡拿到手。
一个做模型的人最怕的,是手里这些卡不够支撑下一代模型,那下一代就得等。等多久,谁也说不准,决定权不在他手上。
钱是肯定要花的,花多少也大致有数。往后拖多久,没数。所以两本账放一起,他的算法很简单,多掏钱,换时间。
还有一句更硬的话在后面。
他说,如果是在一个正常的商业环境里面,我能买到英伟达的卡,那么国产替代是比较难的;但是在英伟达的卡买不到的情况下,所有人都迫不得已,都要去做国产芯片。
这话把因果说反了吗,没有。他把国产替代的动力,从「国产更好」挪到了「买不到别的」。
这个前提是很脆的,哪天英伟达的卡重新买得到,用国产的理由就少了一大半。
开源这件事放在这个前提下,就说得通了。
它让多几家芯片公司能把卡做出来,也让用卡的人敢下手,DeepSeek手上就多几张牌。
别人多一条路,它自己多一个能拿到货的地方。做慈善和留后手,在这儿是同一件事。
9月30日那天,市场没给这套组件定价;沪指涨了0.31%,科创综指跌1.81%,半导体板块集中调整,寒武纪跌了2.97%。
一条消息能不能变成钱,得看它离订单有多远。这套组件还隔着好几层。
过去国产芯片要证明自己能用,得先说服客户;现在多了一个正在用的人,而且这个人是当下最有资格挑刺的那个。
它一边买着华为的卡,一边把工具链开源给所有芯片厂。买和送,是一套动作。
这动作看着往外给,为的还是往里拿。多几家厂能出卡,它就不必只盯一家;三年前它解的是「芯片能不能跑」,现在解的是「能不能排上」。题换了,人也是。
......
写到这儿,估计有人会想,这事在二级市场怎么落?先看中芯国际:
二季度产能利用率93.7%,资本开支18.36亿美元,毛利率25.3%;三季度公司预期回到95%上下,订单已收到年尾。
为什么是中芯?能规模量产先进制程AI芯片的产线,国内就它一条,签长约的也是它。谁签了多少、排到哪儿,都在它账上。
它半年报里有个10.29%,是应收账款余额最大客户的比重,前五大加起来42.43%。欠款口径跟收入不一回事,但下游的钱往头部走,这儿看得见。
再往上游看,扩产得先买设备。
伯恩斯坦八月把中国晶圆厂设备市场的盘子,调到2027年730亿美元、2028年1010亿美元,还说设备股今年涨了60%到110%。涨的是预期,接下来看交付。
旁边的配套也顺手看一眼,中芯二季度把产能往AI计算、HBM和高毛利存储上挪,标准逻辑、联网芯片、利基存储的供给就紧了。谁在涨价、谁的单排到明年,看这儿。
这三条线要是看反了,各有各的记号。
良率明显偏离高盛那个23%,先进制程这笔账得重算;10月中旬那版固件实测低于现在这组数据,性能口径得收回;长约客户在应收款里占比掉下来,排队那套说法得改口。
所以,DeepSeek开源这套底层框架,给自己多开几条队;有得选,是最贵的一样东西,也是唯一花钱买不到的。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”