中国移动全栈国芯国模国云算力中心落地北京
近日,中国移动北京公司(北京移动)联合中国移动云公司宣布华为昇腾950DT千卡超节点正式落地昌平区信息港数据中心移动云北京节点。
北京作为国家首都和全国科技创新中心,聚集了诸多头部AI企业、顶尖高校和科研院所,人工智能产学研生态完备。中国移动以首都为支点,依托信息港移动云超级节点打造全栈国产化算力生态,助力北京构筑全球人工智能创新策源地和产业发展高地,服务京津冀全国一体化算力网络枢纽建设,为全国国产智算发展树立可复制、可推广的样板。此次千卡超节点落地并非普通资源上线,而是全国示范布局,标志着移动云的全栈国产化战略又前进一步。
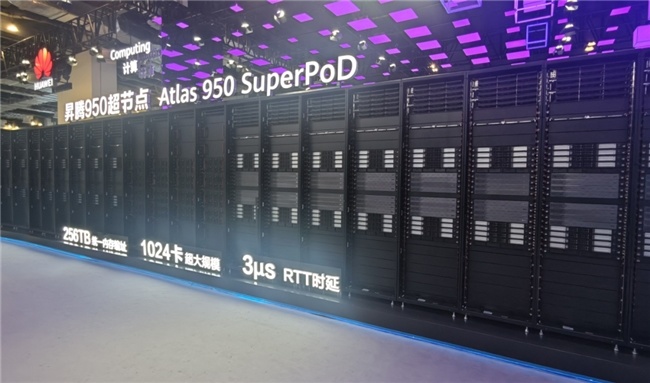
昇腾950DT芯片与移动云在多个层面高度适配:芯片配备高带宽内存,内存带宽达4TB/s,单卡互联带宽达2TB/s,支持多种低精度计算。落地北京节点的千卡超节点基于华为超节点架构,单节点1024卡算力达1EFLOPS(FP8),支持256TB统一内存和微秒级时延,能够高效支撑大模型训推、智能体开发等高阶需求。依托北京密集的科研和产业资源,千卡级算力可近距离服务本地创新主体,加速国产芯片与前沿AI应用的协同验证。
凝聚“国芯”力量,移动云已完成昇腾、平头哥、昆仑芯、摩尔线程、燧原、壁仞、海光、沐曦和天数智芯等国产主流AI芯片兼容,并通过自研智算管控平台,实现多元算力统一接入和管理。平台可对算力、网络、存储等数百项指标进行实时监控和主动检查,保障训推任务稳定运行。昇腾950DT落地北京后,这套国产化管控体系可在首都丰富的产学研场景中持续打磨迭代,形成成熟经验并向全国算力节点推广。
构筑“国模”生态,中国移动一站式大模型服务平台MoMA已汇聚超300款主流模型。随着千卡超节点上线,MoMA将推动主流模型完成基于昇腾950DT的深度适配和调优,打通“模型汇聚-国产算力部署-性能优化”的业务闭环。此前,MoMA依托国产算力和自研推理引擎,已实现单位使用成本下降约30%、资源占用率降低50%以上。新算力落地后,北京节点将支撑更高阶的大模型训推与智能体开发,为区域提供“从芯片到模型”的全链路国产化服务。
从芯片到集群、从平台到应用,作为网信领域的“国家队”,中国移动正在构建完整的国产化技术链路,打造“国芯+国模+国云”闭环。以北京千卡超节点为里程碑,中国移动将持续扩大国产算力部署,深化芯片和模型生态合作,将北京核心节点打造为示范窗口,将成熟经验向全国复制推广,同时不断拓展面向公众市场的AI算力服务覆盖规模,降低AI使用门槛,带动国产算力技术、方案和生态辐射全国,服务国家人工智能发展大局。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”