



【千问发布 Qwen-Audio 3.1,新增音频创作与场景理解模型】 #千问发布QwenAudio3点1#
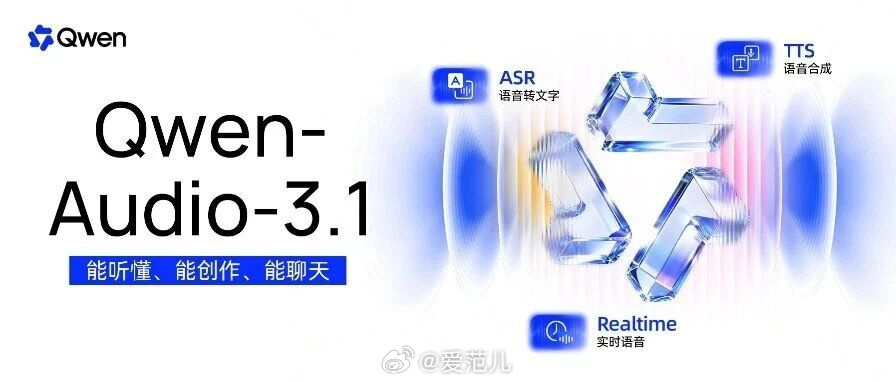
千问这次把语音模型拆成了五条能力线:转写、语音合成、实时对话,以及两款新模型负责声音场景理解和完整音频创作。Qwen-Audio 3.1 系列已发布,相关 API 陆续上架千问 AI 平台。
识别模型 ASR 支持 30 种语言和 16 种中文方言,能给多人谈话标出说话人、时间戳,并润色转写中的口头重复。新的 ASR-Next 不只处理话语,还能描述情绪、环境声和机械声;它的 API 目前尚待上线。
另一款新模型 TTS-Next 能按脚本把对白、音效、环境声一起生成,支持多角色音色和时间戳控制。Realtime 则支持在模型说话时插话、修改要求,还能调用工具完成查询。
千问称,实时语音能力正接入 Qoder、千问办公和 AI 眼镜等产品,同时下调系列模型价格。发布稿中的方言识别等效果来自千问自测。
#语音大模型# #音频创作#
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”