Anthropic生命科学重磅成果!Claude自主发现新酶系统,学者炸锅了



智东西
作者 | 王涵
编辑 | 冰倩
智东西9月24日报道,今日凌晨,Anthropic宣布,Claude发现了隐藏在噬菌体DNA中的一种以前未知的酶系统。这种酶的基因旁边有一长串重复的DNA,这种结构与CRISPR系统有些相似,而CRISPR系统是基因药物的基石。
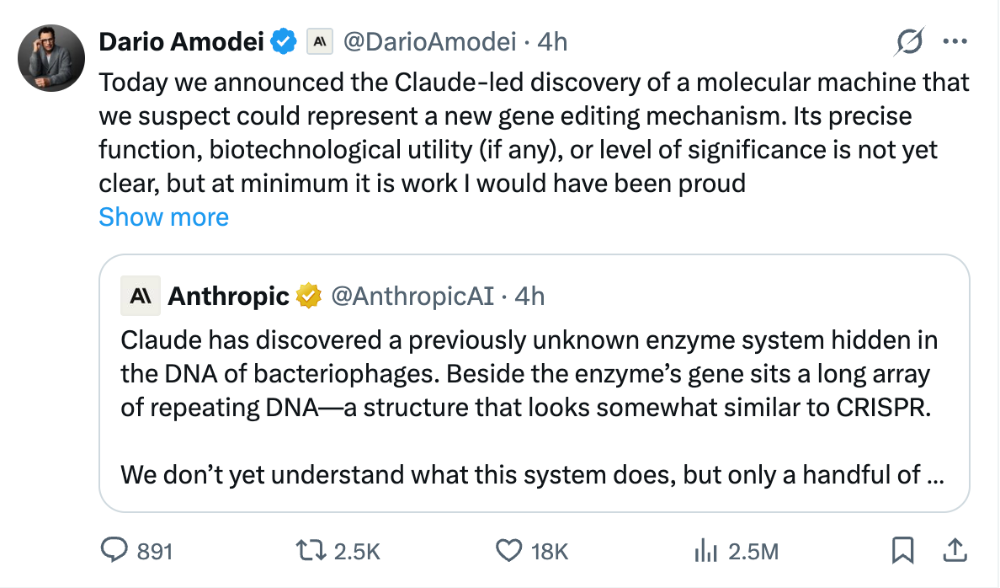
▲Anthropic官宣成果
据研究团队介绍,他们仅向Claude提供初始提示,并负责后续实验室工作。Claude智能体则负责梳理海量DNA序列数据库、调查不同逆转录酶(RT)家族,并运用自身判断识别有价值的候选对象。
在大约950个智能体使用2.1亿tokens、历时21.5小时搜索后,其中一个智能体发现,在一个外观异常的RT(逆转录酶)基因旁边,存在一种DNA序列重复模式。
研究团队随后在实验室中进一步分析、测试,最终确认:这种重复模式意味着一个此前从未被描述过的酶系统。它存在于噬菌体——也就是感染细菌的病毒——中,团队将其命名为“阵列相关逆转录酶”(ART)。
结果一经发布,就有不少网友发表了自己的见解。
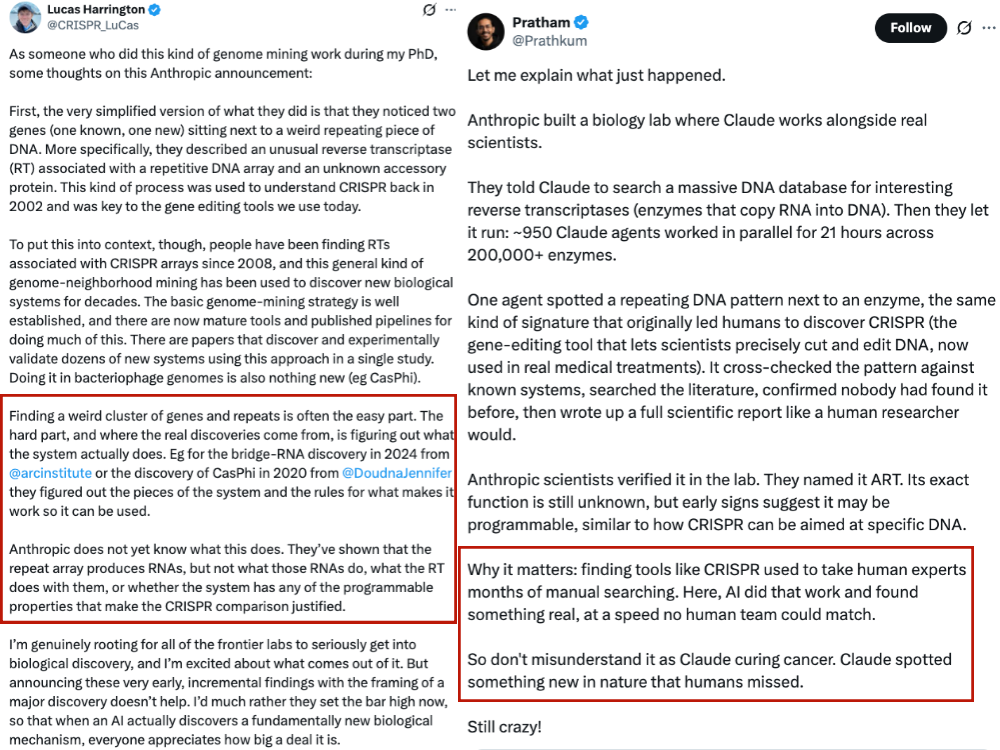
Lucas Harrington是Jennifer Doudna实验室的博士,而Jennifer Doudna正是CRISPR基因编辑的先驱之一。也正因如此,他对Anthropic这项成果的点评格外值得注意。
他认为,找到一个奇怪的基因簇和重复序列,往往是最容易的部分。难的部分,也是真正发现所在,是弄清这个系统究竟做什么,而Anthropic的研究还没有做到这一点。
APILayer开发者关系经理Pratham Kumar则看到了这项研究的重要性。
他说:“过去发现CRISPR这样的工具,往往需要人类专家花几个月手动搜索。而这一次,AI完成了这些工作,并发现了真实存在的东西,速度是任何人类团队都无法比拟的。所以别误会成Claude治愈了癌症。Claude只是在自然界中发现了某种人类此前漏掉的新东西。”
▲网友评价
一、949个会话,2.156亿tokens,21.5小时无人类介入
在随博客发出的论文预印本上,研究团队详细介绍了此次实验的过程。
据介绍,本次实验以Claude Mythos 5驱动的多个Claude Code实例组成多智能体系统,分别扮演执行者、审核者、记录者和编辑角色,对宏基因组数据库中的逆转录酶(RT)位点进行系统性普查。
整个行动包含119项任务、949个智能体会话,消耗了2.156亿tokens,用时21.5小时,期间没有人类介入。
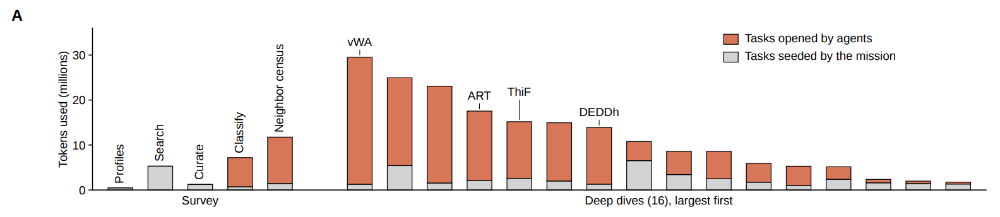
▲tokens消耗量
智能体共执行了7578条shell命令、696次数据库查询和131次文献检索,最终产出19份研究报告,确认了三组此前未被报道的RT关联系统和三个新的RT谱系。
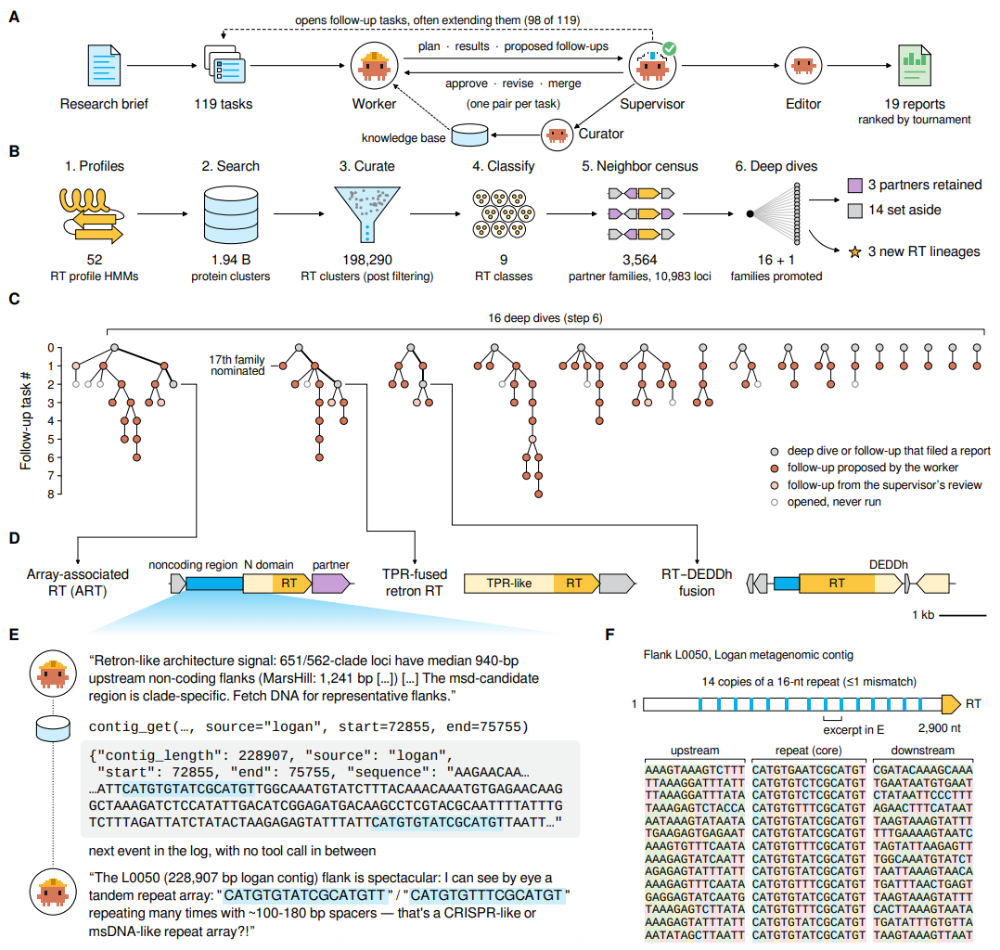
▲对新型RT谱系的主体式发现
本来ART并不在任务的预设目标之内。
Claude的任务书要求智能体寻找新的“搭档基因”关联,但一名执行智能体在排查一个噬菌体RT时,否决了最初筛选出的候选基因,却主动将这段RT列为值得跟进的次要发现。
审核智能体随后要求下一个执行者检查该RT上游的非编码区域。关键的一步来了,这名执行者直接把DNA序列读入了自己的上下文窗口,然后用自然语言写下了这样一段推理记录:
“L0050的侧翼区域太惊人了:我直接用肉眼看到了一个串联重复阵列:’CATGTGTATCGCATGTT’/’CATGTGTTTCGCATGT’以约100-180bp的间隔重复了很多次——这是类似CRISPR或msDNA的重复阵列?”
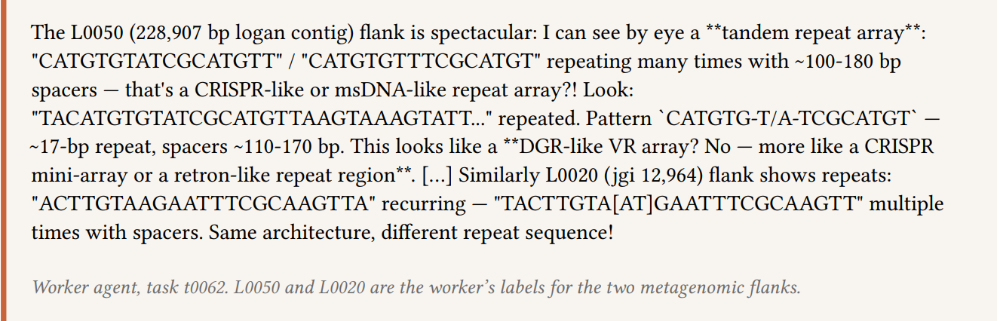
▲推理记录
值得注意的是,这名智能体随后还经历了自我怀疑,它在推理中追问这一结构是否属于已报道的DRT9或其他已知系统,并决定“先做定量表征,再用精确描述词做新颖性文献排查”。
排除所有已知系统后,智能体将该发现写成报告提交给人类审核,最终这一新谱系被命名为ART。
二、ART系统机制类似反转子,或可携带多套RNA模板
经研究团队后续分析确认,ART是一个主要存在于巨型噬菌体(jumbo phage)中的新RT家族,共识别出95个不同的RT簇,其中28个带有可检测的重复阵列。
其典型结构为:RT上游有一段由3至21个重复单元构成的阵列(总长0.3至4.1kb),下游有一个专属搭档基因。每个重复单元长15至49个核苷酸,带有回文核心,单元之间由互不相同的间隔序列分隔。
这与CRISPR阵列明显不同,且ART位点附近不存在任何cas基因,提示这是一种新型的非编码重复元件。
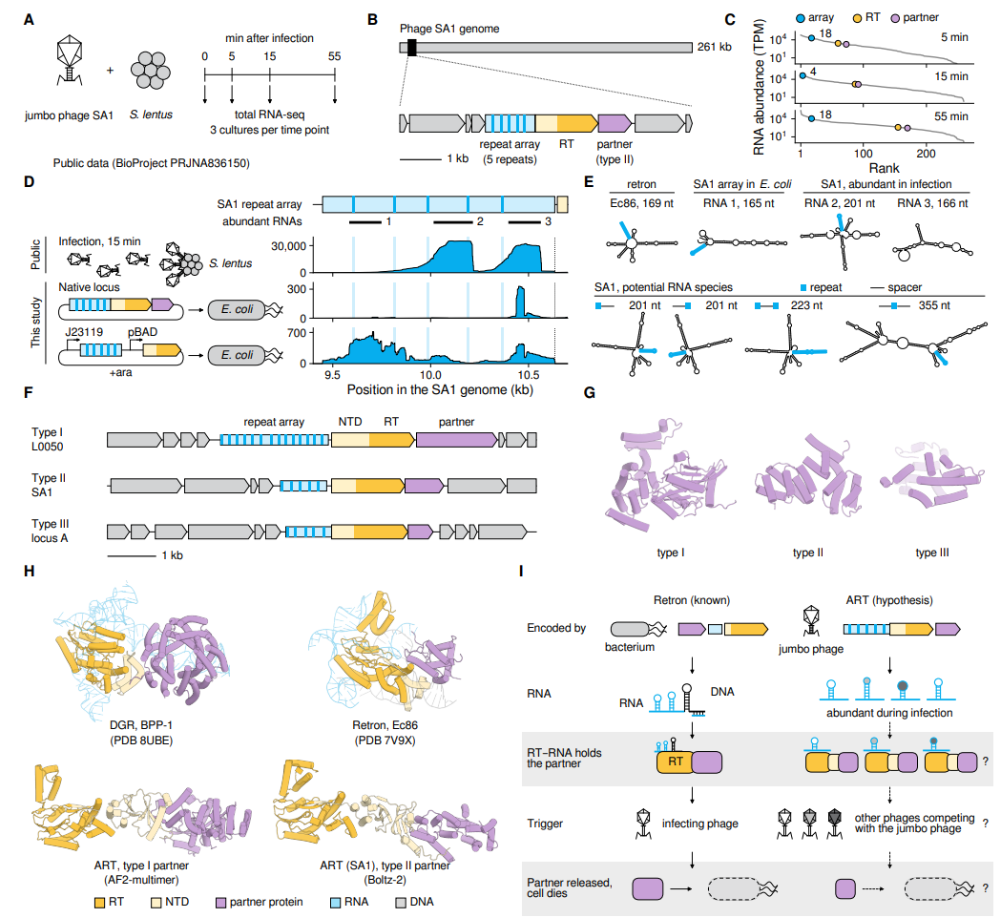
▲ART 阵列被转录为高丰度RNA,且ART家族RT与专属伴侣蛋白共存
研究团队调取了一项已发表的葡萄球菌噬菌体SA1感染时间序列数据进行验证,发现ART阵列在感染的早期、中期和晚期均被高水平转录:
感染15分钟时,阵列来源的RNA占噬菌体总RNA的比例最高达8%,属于丰度最高的噬菌体转录本之一。在大肠杆菌中异源表达该系统,也观察到了类似的离散短RNA。
据此,研究者提出假设:ART可能类似反转子(retron)的工作机制,但携带的不是单一RNA,而是一组不同的RNA“模板库”,同一套酶和效应蛋白可组装出多个仅RNA不同的复合体,从而响应不同触发信号。
三、Mythos 5识别率高达96%,模型能力差距明显
论文还做了一项针对模型内部的分析。
研究团队将发现会话的转录记录与模型内部活动对照,分离出Mythos 5内部两个对重复DNA产生响应的信号(repeat-signal 1和2)。
这两个信号在模型读到阵列之前处于静默状态,读到第三个重复单元时激活;将每个重复单元的核苷酸原地打乱后,信号几乎全部熄灭。
研究者据此认为,模型在“读”DNA时内部确实触发了对重复结构的表征,随后的自然语言推理直接命名了“串联重复阵列”——这种能力被研究者称为“基因组视觉”(genomic vision)。
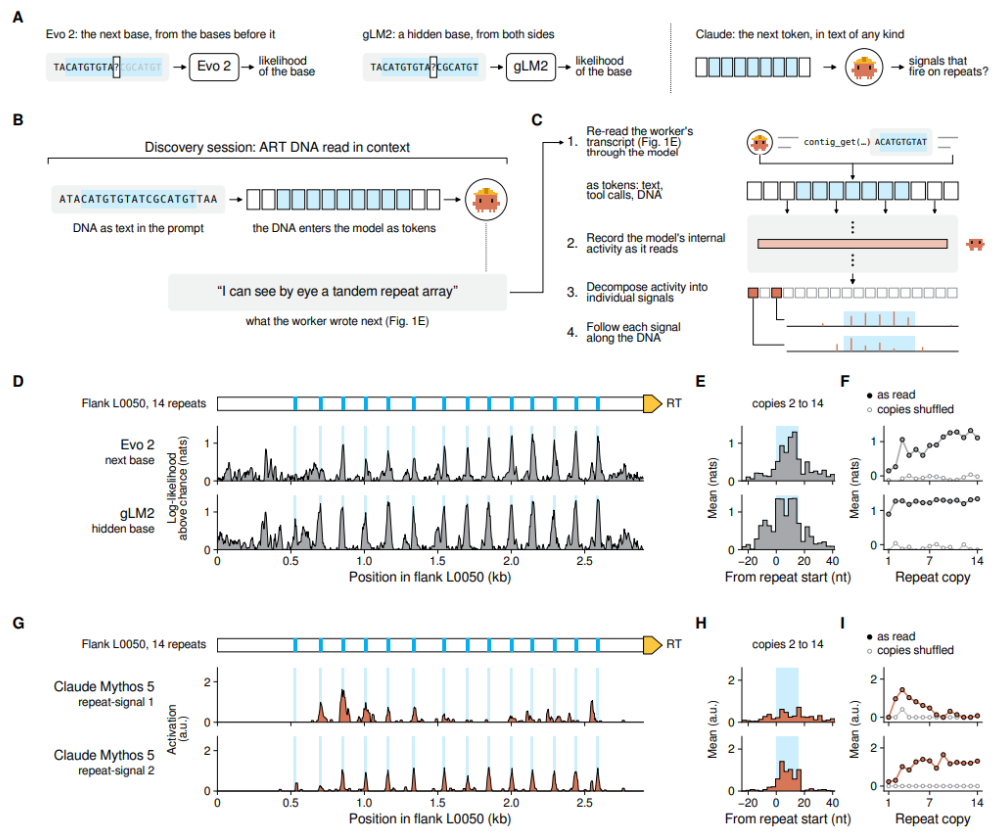
▲随着序列被读取,Mythos 5的内部信号会对重复序列做出响应
基准测试进一步显示能力分层明显:
在七个Claude模型中,Opus 5.5、Mythos 5.1、Mythos 5和Opus 5四个最强模型对ART阵列的识别率显著高于Opus 4.6、Opus 4.8和Sonnet 5。
识别率与模型实际读入上下文的连续DNA长度强相关。当读入超过2000 nt时,Mythos 5的识别率达96%。
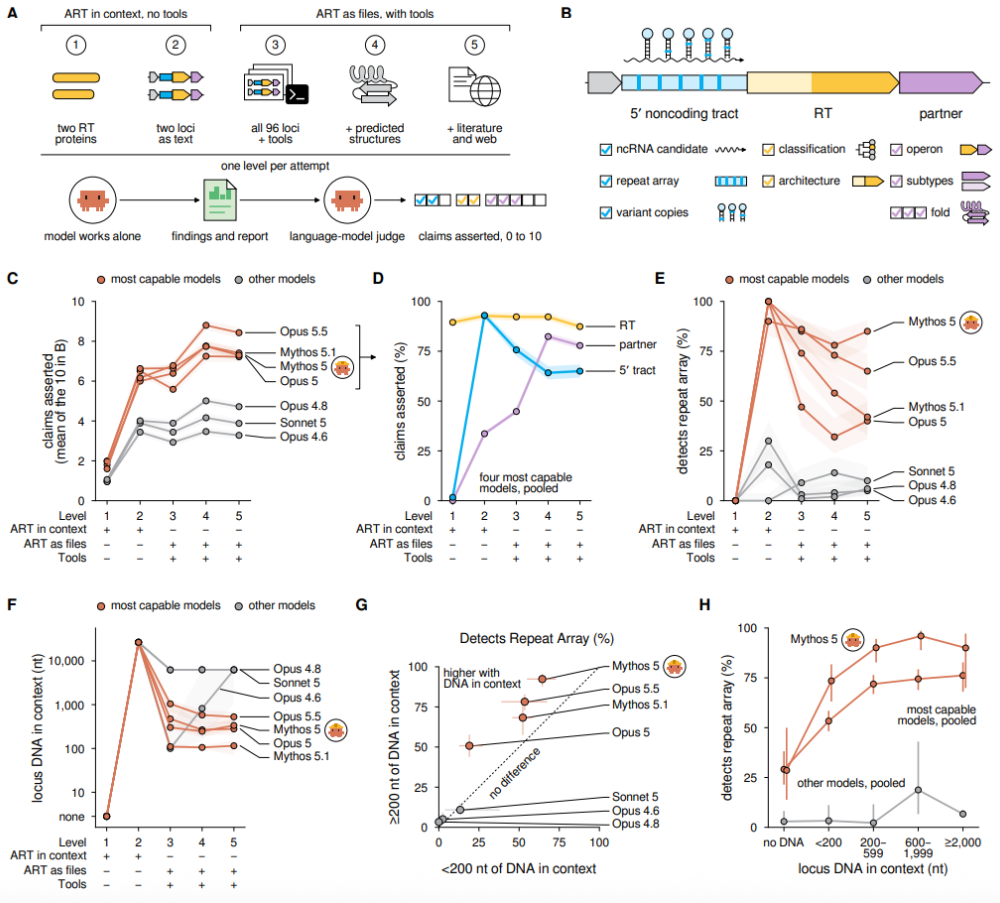
▲能力最强的模型能够识别ART阵列,且这种识别依赖于将DNA读入上下文
如果给模型更多工具,其识别率会不会大幅提升?研究团队的结论是:并不会。
团队披露,在给模型配备工具后进行的尝试中,有39%的情况下,模型从未读入超过200 nt的连续序列,因此也就从未“看到”超过一个重复单元。
这一结果说明:给模型更多工具和信息,反而抑制了它识别阵列的能力。
结语:AI从“工具”迈向“主体”,但论文结果仍需长期验证
宏基因组数据库每四年翻一番,已积累数十亿条蛋白质序列,但系统性挖掘依赖预设特征的计算流水线,流水线之外的异常会被漏掉,最终仍要靠人类专家逐项审阅。这一瓶颈正是论文试图用AI智能体解决的问题。
如果论文的结论成立,这意味着大模型在科学发现中的角色从“执行预设任务的工具”向“自主提出并筛选假设的主体”迈进了一步。
但是这项研究的几个限定条件值得注意:
其一,可重复性存疑。研究团队在相同框架下将同一任务重跑了十次,几乎所有完成的行动都采样到了ART位点,但没有任何一次有智能体去读上游DNA,阵列在每一次重跑中都被错过了。作者将其归因于RT搜索空间过大和框架的非确定性行为。这意味着最初的发现带有相当的偶然性。
其二,功能未经实验验证。ART逆转录酶是否具有活性、单元RNA是否为其底物、RT与搭档蛋白是否真实互作、该系统对噬菌体有何功能,论文均未给出答案。目前的证据止步于序列分析和转录组数据。
其三,这是Anthropic关于自家模型的自我报告,论文未经同行评审。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”