科大讯飞发布最新语音识别大模型Spark-ASR-2.0,复杂声学场景表现突出
9月23日,科大讯飞正式发布最新一代语音识别大模型Spark-ASR-2.0。该模型通过非自回归与LLM增强自回归协同、中英文混合文本与声学联合增强、动态上下文注入等关键技术,实现了整体语音识别效果的大幅提升,尤其在通用识别(中英文混合、方言、专业术语)、复杂声学场景识别(高噪、小音量、快语速、儿童)、上下文识别和文本流畅规范性等方面改善明显。在效果提升的同时,Spark-ASR-2.0的推理成本相对Spark-ASR-1.0仅增加了10%。
Spark-ASR-2.0使语音识别从以前追求的一字不差还原所说内容,到现在让识别结果直接“流畅成文”,在提升识别准确率的同时,结合上下文逻辑与语境理解,精简冗余表达、精修各类细节,让文字更连贯、语义更清晰。
据了解,Spark-ASR-2.0将从9月24日开始逐步上线讯飞输入法,并且通过讯飞开放平台提供API服务,同时还开放了体验入口。
核心识别场景效果提升,复杂声学场景等表现突出
相较于Spark-ASR-1.0,Spark-ASR-2.0在语音识别各核心场景上的效果有明显进步,尤其在中英文混合、方言、高噪声、文本流畅规范性等维度上的效果实现了大幅提升,WER(词错误率)明显降低。
Spark-ASR-2.0与当前业界最好水平相比,在方言、高噪和小音量上拥有显著优势,也再次证明了在复杂声学场景上语音识别的强大实力;且主要任务效果均好于业界最优水平。
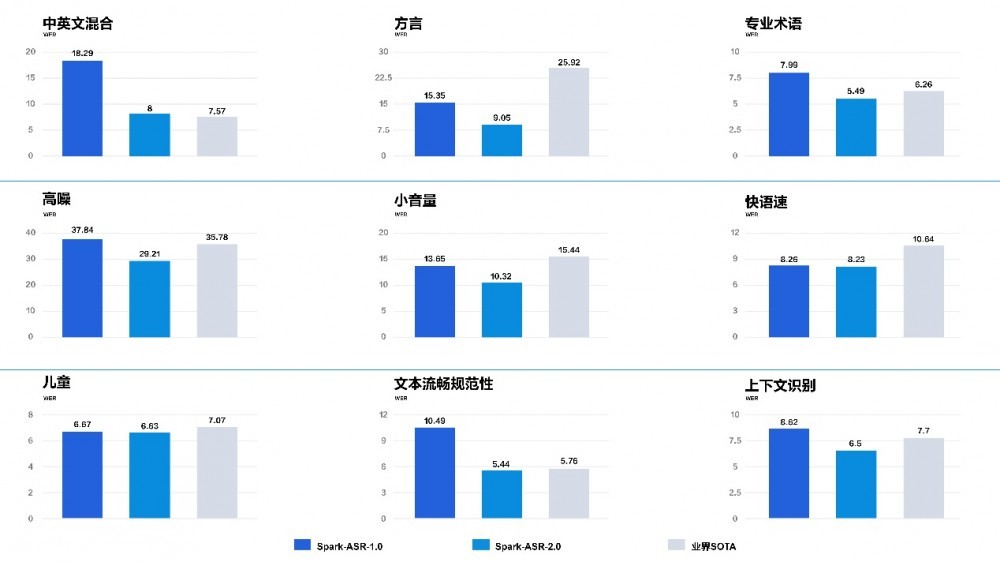
*测试集中ASR任务使用WER/CER作为评价指标,数值越低表示效果越好
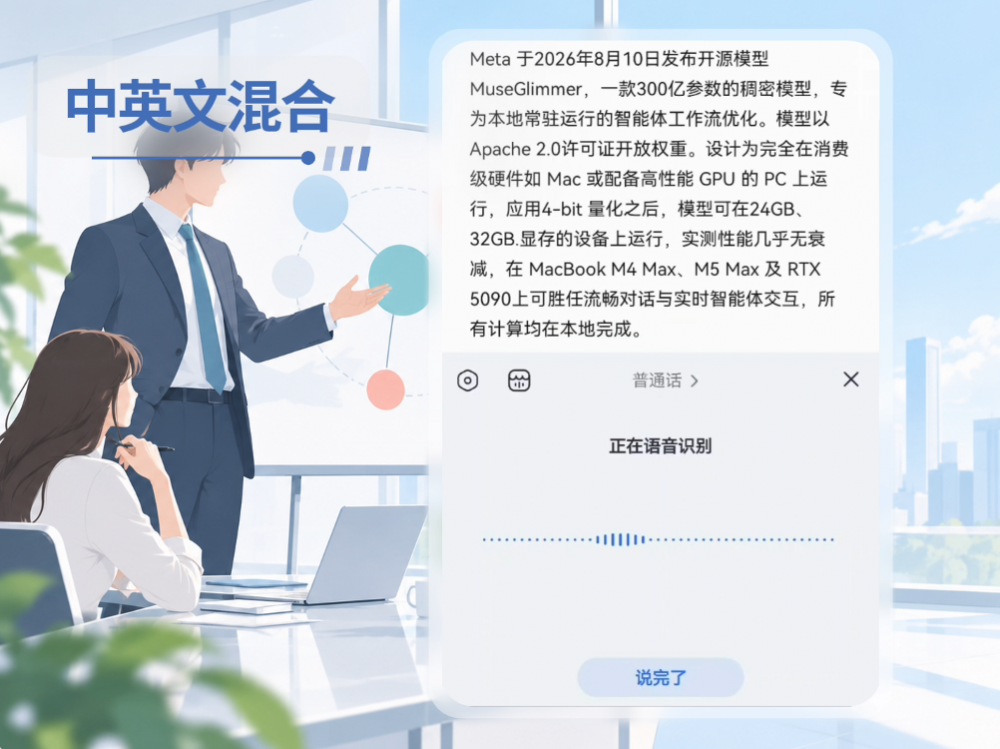
在通用识别能力上,Spark-ASR-2.0 全面提升了中英文混合、方言、专业术语识别等维度的能力。面对较为复杂的中英文混合情况,Spark-ASR-2.0表现游刃有余;还支持全国 202个城市的方言免切换识别,各种方言随心说,都能精准识别;面对医学、化学、科技等领域中复杂拗口的专业术语,Spark-ASR-2.0的识别能力也显著提升,通过语音识别记录专业领域的相关讨论不在话下。
基于语音基座大模型Spark-Audio-1.0-Preview在复杂声学场景识别下高噪、小音量识别上的优势,Spark-ASR-2.0在这些场景下的表现也十分出色。
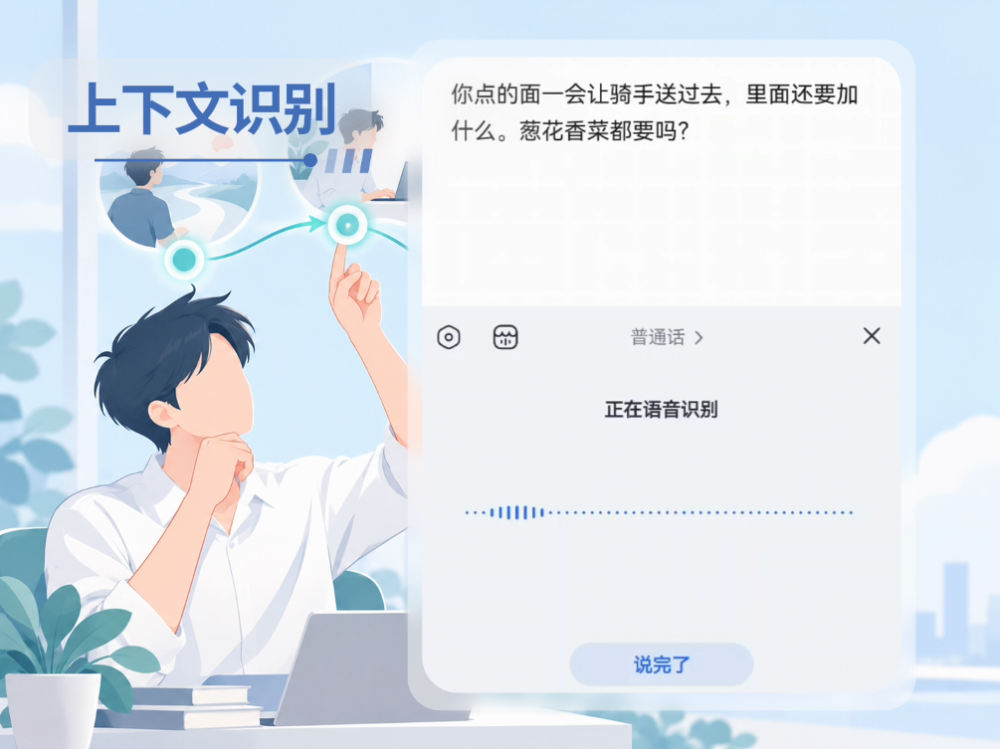
Spark-ASR-2.0 也重点升级了上下文识别能力,融合用户识别历史、修改记录及个性化热词等信息,对说话时的语境精准把握,能够有效消解语义歧义、易混淆发音、相似名词带来的识别偏差。
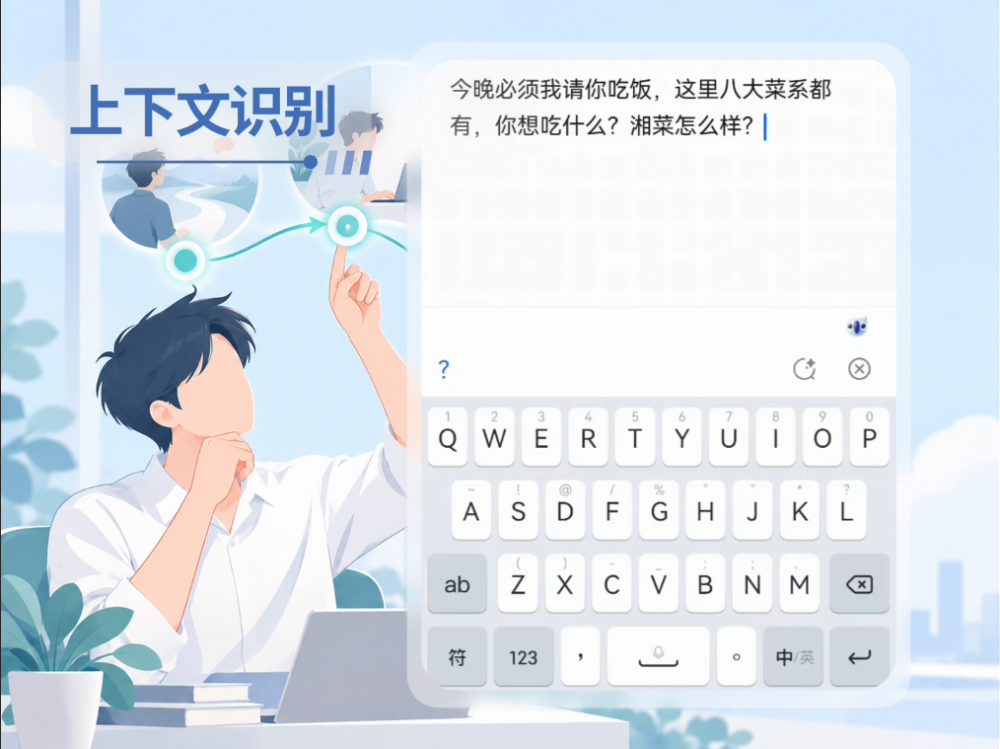
使用语音输入时,我们的语气词、犹豫时重复的词语、口头禅都会被忠实记录,直接发送很容易被人看出是语音识别转写而成,内容显得有些潦草。Spark-ASR-2.0 做到了“听懂”你的关键意思,直接输出符合你原意但更加流畅的内容,不再需要你手动修改润色。
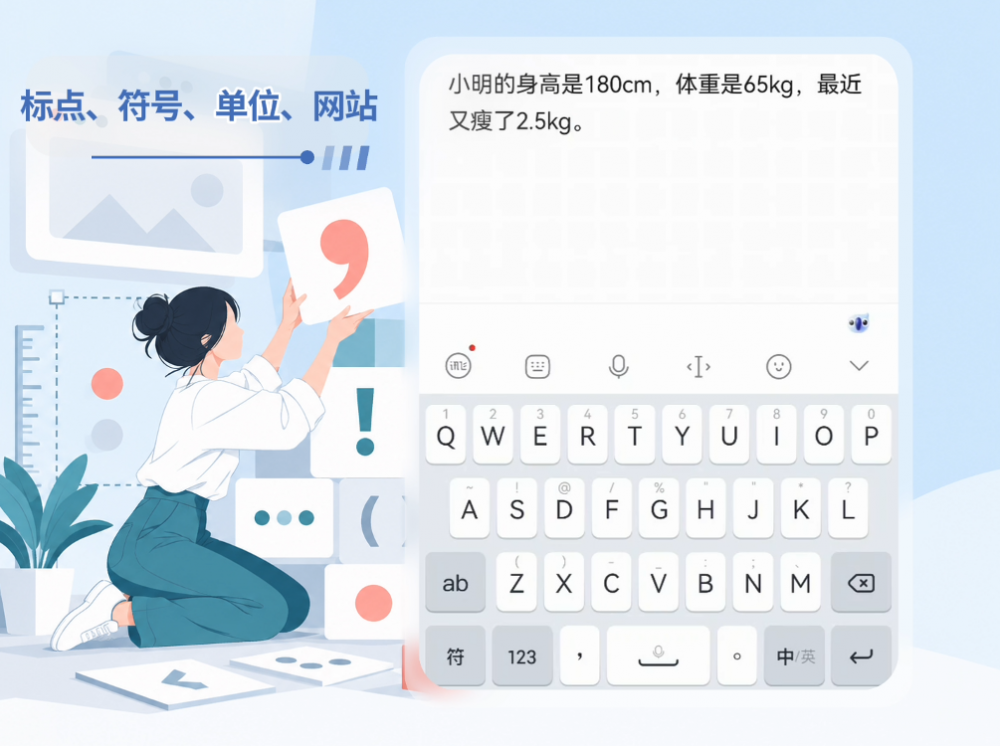
同时,一句或者一段话最终完整的识别呈现,除了文字元素之外,标点、数字、符号和单位等细节的规范表达同样不可或缺。
Spark-ASR-2.0 针对这些细微、却影响文本完整性与可读性的部分进行了专项优化。结合表达规范的前提下,为识别内容合理补全标点,准确呈现数字,给出标准的转换符号与单位,让“粗犷”的识别转写结果变身为工整、连贯、正式的文本,带来全新的语音输入体验。
三大技术创新全方位提升语音识别效果
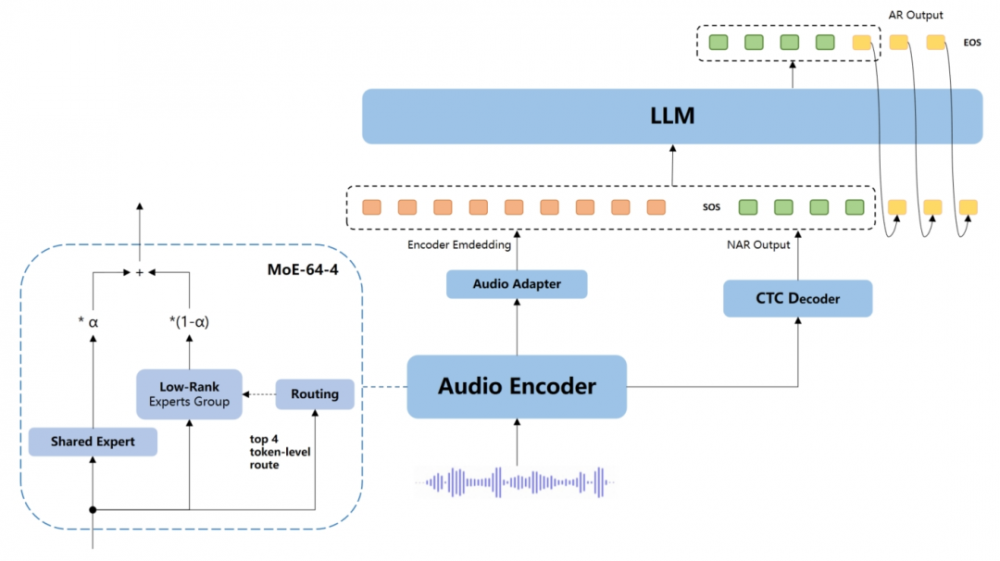
Spark-ASR-2.0延续并深化了Spark-Audio-1.0-Preview语音基座大模型的技术能力,进一步聚焦语音识别的准确性、实时性、语言理解和文本规范,形成了“非自回归识别 + LLM增强自回归识别”的专用语音识别架构。
非自回归与LLM增强自回归协同:非自回归识别模块继承了Spark-Audio-1.0-Preview的音频表征和复杂声学场景建模能力,并通过MoE扩展、增量持续训练,提升大规模真实复杂场景下的识别鲁棒性。LLM增强自回归识别模块则进一步发挥大语言模型的语言覆盖、上下文理解和推理能力,通过投机解码判断是否需要介入、以及从何处开始自回归修正。该机制在降低平均推理时延和计算成本的同时,增强了复杂语境、长尾表达和口语化内容下的识别能力。
中英文混合文本与声学联合增强:针对中英文混合场景下数据匮乏的问题,Spark-ASR-2.0在文本端通过挖掘英文专有词与热词,构建大规模中英文混合文本数据,提升了大模型在中英文复杂场景下的泛化性;声学编码端通过联合文本辅助与相似音素泛化来拟合不规范发音,最终在中英文混合场景中取得了高鲁棒性效果。
动态上下文注入:Spark-ASR-2.0以动态上下文注入为核心,将多源语境编码为结构化表征并与声学信息深度融合。综合即时修正、多轮对话记忆和当前文本内容,提升人名、术语及表达风格的识别一致性;从万级热词库中快速筛选高置信度候选,在提升热词命中率的同时基本不增加时延;基于历史交互提取用户的口语特征、关联实体、修改习惯和话题偏好,并通过相关性筛选、自适应压缩与遗忘机制保持上下文精炼有效。由此,Spark-ASR-2.0实现对用户偏好、表达习惯与业务语境的联合建模,让用户用得越多、语音识别能力越好。
除了API开放以及在讯飞输入法上更新之外,Spark-ASR-2.0还将陆续在讯飞AI眼镜、讯飞智能办公本、讯飞听见等更多产品业务上落地应用。科大讯飞表示,未来还将重点关注语音识别三个方向的体验提升:一是无关说话人拒识,能在多人交谈和复杂噪声中精准锁定目标用户;二是语音内容编辑,基于对语音语义的理解,可通过语音指令对识别内容进行灵活修改;三是情感化结果呈现,结合情感表征和用户的情感表达,在标点、措辞、语气和格式等方面输出更贴合用户当前态度的识别结果。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”