亮源新创发布全身智能基础模型Light-O1:让机器人从人类视频中学会全身动作



凤凰网科技讯 9月21日,亮源新创今日发布全身智能基础模型Light-O1。该模型通过学习互联网视频中的人类动作,并结合语言和视觉信息,将人类动作知识迁移到机器人,以提升机器人全身协调与任务执行能力。官方称,该模型首次揭示了人类全身动作预训练的跨本体迁移扩展规律:用于预训练的人类动作数据越多,模型在适配不同机器人本体和视角后,动作预测越准确。
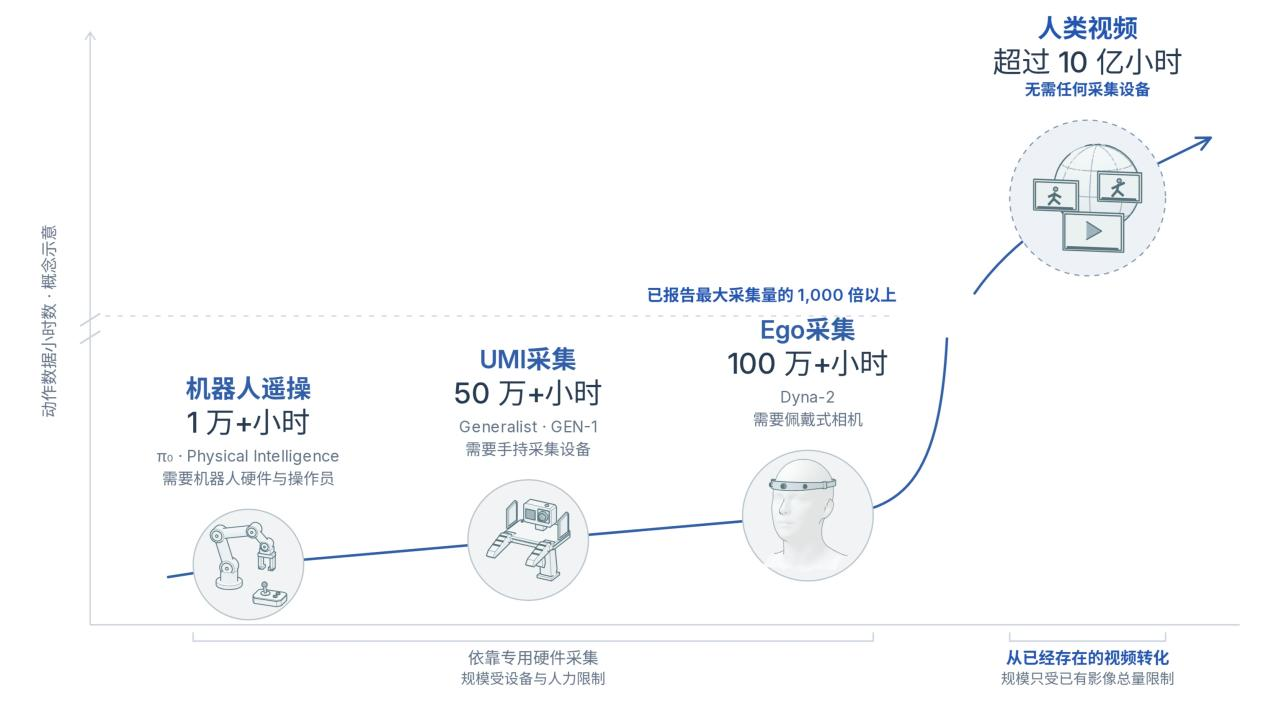
当前,机器人动作模型主要依赖遥操作、UMI等方式专门采集数据,成本高、周期长,覆盖不同任务还需定制采集流程。亮源新创Light-O1尝试利用互联网视频中已有的人类行为数据拓展预训练来源。其技术路径包括:将视频中的人类行为整理为统一的多模态动作数据,通过大规模预训练形成“在什么情境下、如何行动”的动作先验,再利用目标机器人数据完成适配。
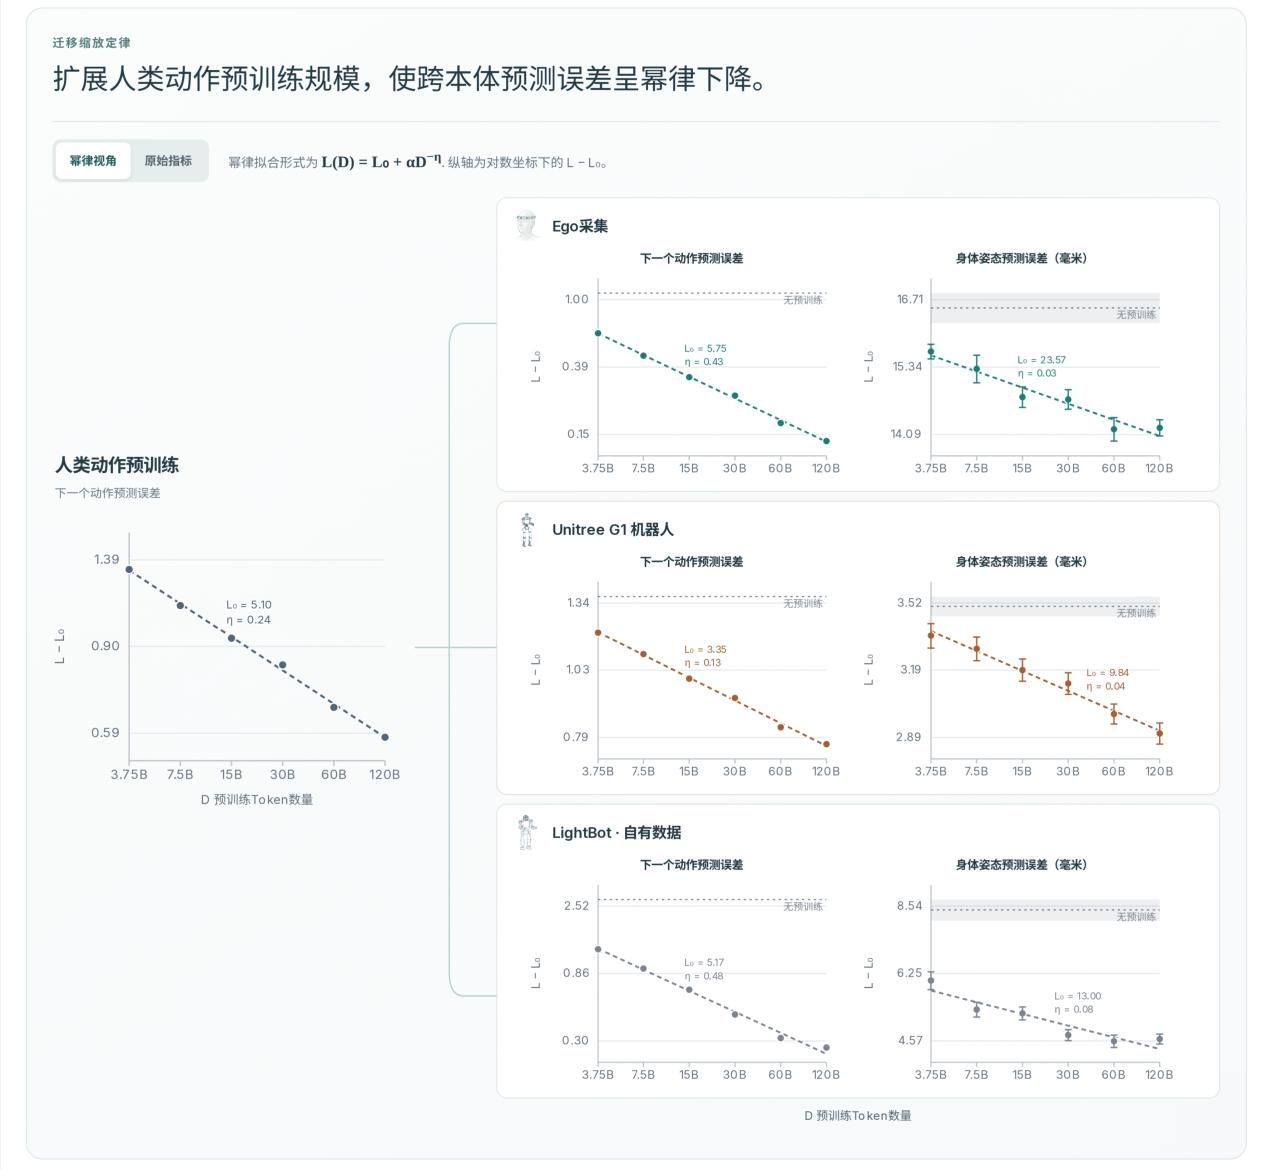
据官方介绍,Light-O1将基于视频的人类动作预训练拓展至10万动作小时。结果显示,随着预训练数据规模扩大,模型在目标领域适配后的动作预测损失呈幂律下降趋势,离线开环评估中的全身姿态误差也随之降低,表明人类动作预训练带来的收益能够跨越本体差异迁移至机器人动作预测。
在能力展示方面,搭载Light-O1的自研小型人形机器人LightBot可自主完成递毛巾、打开鞋柜归置拖鞋、捡垃圾等任务,将行动决策、移动导航和全身操作连接为连续执行过程,并能在执行失败或外界干扰时调整行动、自主重试。面对自然语言指令,模型可结合情境理解用户需求,推理完成目标所需的身体姿态、动作顺序与约束,再生成全身动作。
亮源新创同步在官网开源通用动作生成模型Light-O1-Preview,用户可体验从“理解需求”到“生成行动”的完整过程。官方表示,Light-O1的发布使其“规模化预训练—规模化对齐—规模化部署”三段范式核心技术成果均已落位,形成从基础模型预训练、能力对齐到真实世界部署的完整技术链路。