


【机器人也开始「刷视频」学动作了】#LightO1#
亮源新创发布全身智能基础模型 Light-O1,希望把互联网上的人类动作视频,变成机器人学习行动的新教材。
目前,机器人动作数据主要依靠遥操作、UMI 等方式专门采集,换一个任务或场景,往往又要重新组织人员和设备,成本高、速度慢。Light-O1 的思路,是先从互联网视频中学习人类如何移动、使用工具和操作物体,再结合语言与视觉信息,把这些动作知识适配到身体结构、观察视角各不相同的机器人上。
亮源新创称,Light-O1 的人类动作预训练数据已扩展至 10 万动作小时。实验中,随着预训练数据增加,模型适配不同视角和机器人本体后的动作预测损失、全身姿态误差均呈下降趋势。公司将其称为人类全身动作预训练的「跨本体迁移扩展规律」。
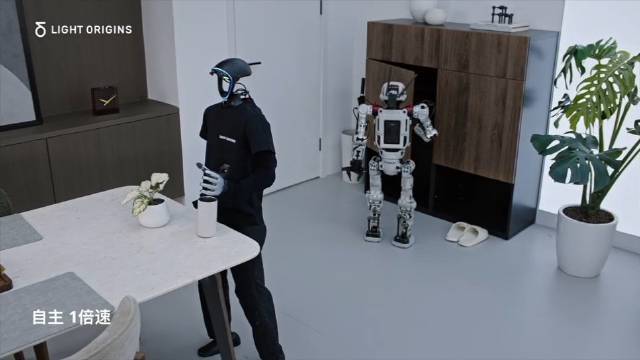
搭载 Light-O1 的小型人形机器人 LightBot,目前已演示递毛巾、打开鞋柜归置拖鞋、捡垃圾等连续任务;收到自然语言指令后,模型还能推理身体姿态、动作顺序和约束。通用动作生成模型 Light-O1-Preview 也已在官网开放体验。
这项工作的看点不只是机器人又学会了几个新动作,更在于体现训练数据的来源正在逐步改变。如果这条扩展规律能在更多机器人、更多真实闭环任务中成立,机器人或许可以先从海量人类视频中打好「动作基础」,再用少量本体数据完成适配。
不过,目前披露的证据仍以离线开环评估和自研机器人演示为主。面对更复杂的环境、陌生物体和长时间任务时,模型的泛化能力与稳定性,还需要更多公开测试验证。
#机器人##PhysicalAI#
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”