一场户外烧烤直播,乐享科技把具身智能大模型拉进了“真刀真枪”时代



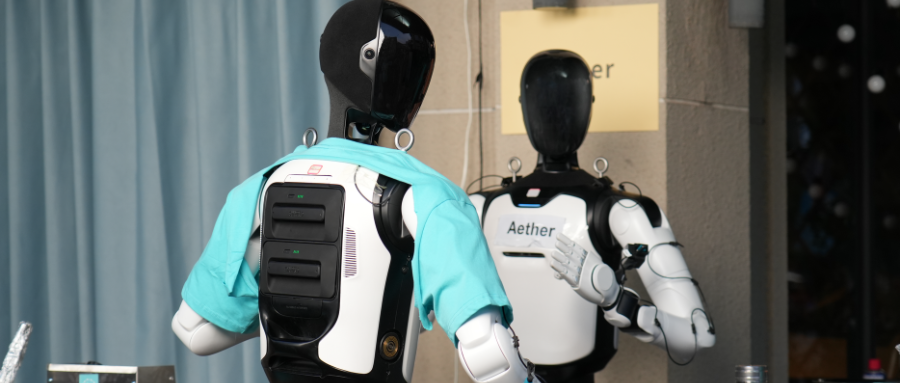
机器人烧烤真正值得看的,不是烤串。
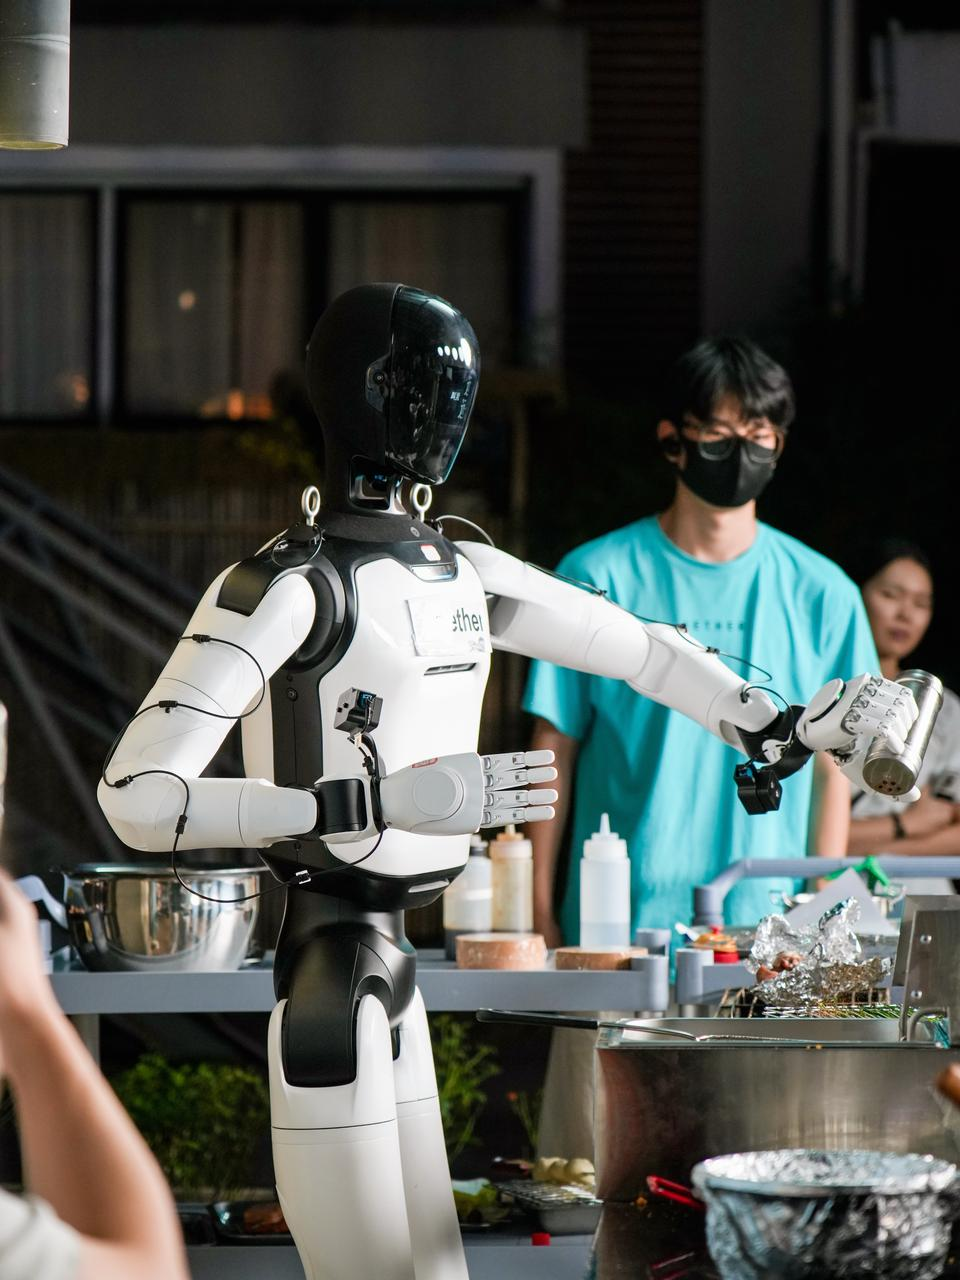
9月16日,乐享科技把搭载以太大模型的机器人拉到上海街头,进行了一场近1小时的户外直播。现场设置3桌、6位顾客,机器人需要完成从点单、任务规划、烧烤到上菜的完整流程。按照乐享科技的说法,全程无遥操、无剪辑、无预设脚本;据其披露,线上围观人数超过550万,现场还有超过30位行业媒体,一起见证了全球首次机器人完全自主的户外烧烤直播。
如果只看结果,这似乎是一场“机器人又学会了一项新技能”的展示。但真正让这场直播有别于以往 Demo 的,不是机器人最终把串烤了出来,而是整个过程被放进了一个明显不友好的环境里:没有实验室般的恒定条件,没有提前清场,没有为机器人保留一条绝对顺畅的行动路线,甚至现场的顾客也不是来配合演出的,而是来“添乱”的。
顾客可以临时改单、追加需求、挪动物品、打断任务;原定一位顾客未能到场后,现场没有停播,也没有重写流程,而是直接从围观人群中随机请了一位补位。换句话说,乐享没有让机器人演一场“完美烧烤秀”,而是把它扔进了一个更接近真实服务场景的开放环境:人会变卦,物体会移位,流程会被打断,计划会失效。
这也解释了为什么“烧烤”只是一个载体。真正被检验的,是具身智能在真实世界里的几个硬问题:长时序任务能不能持续推进?环境变化后能不能重新判断?被打断后能不能记得回来继续?失败后能不能恢复?没有人工接管时,系统还能不能自己把任务做完?
一、一场把不确定性变成了演示本身的直播
过去两年,具身智能行业并不缺少惊艳视频。机器人叠衣服、冲咖啡、翻跟头、擦桌子,镜头越来越精致,节奏越来越紧凑,配乐越来越燃。但这类内容也始终伴随着同一种质疑:我们看到的是第几次成功?镜头之外失败了多少次?如果现场突然有人走过去,如果道具被挪动,如果任务中途被打断,机器人还能不能继续?
演示视频的价值在于证明“做到过”,却很难回答“能不能持续做到”。这正是乐享这场直播试图改变的叙事方式。它没有把不确定性剪掉,反而把如何解决各种不确定性变成了演示本身。
从直播呈现看,几个片段颇具代表性。服务机器人在点单过程中被顾客临时要求“拿瓶水”,它没有卡在原地,也没有继续机械完成当前流程,而是先完成送水,再回到点单任务。
负责烧烤和负责服务的两台机器人本体不同,却能围绕同一任务自主协作、交接任务。还有一个细节是,机器人在没有人吩咐的情况下,主动为顾客递上纸巾。
这些瞬间之所以重要,是因为它们不再是简单的“指令—执行”。尤其是递纸巾这类动作,并不在任何明确指令里,它更像是机器人基于“人在吃烧烤”这一场景做出的自主推导。工具等待命令,智能则需要理解场景。二者之间的差别,不在于动作是否漂亮,而在于系统能不能从环境、任务和人的状态里推出下一步该做什么。
当然,直播里也并非没有瑕疵。机器人像人一样,第一次操作的时候,需要个了解的过程,没那么流畅,但可贵的是,失误的经验会直接成为下一次成功的执行基底。但恰恰是这些没有被藏起来的过程,让这场直播比一支精修视频更具价值。
对于具身智能来说,真正拉开差距的未必是不犯错,而是犯错或者遇到未知挑战的时候,能不能持续自进化,最终解决掉问题。乐享想证明的,也正是以太大模型在遭遇计划外情况时,能否仍能维持任务状态并继续推进。
二、以太大模型,被放在 VLA、WAM 之外的“第三条路”
支撑这些表现的,是以太大模型背后一套全新的具身大模型的思路。根据乐享提供的资料,以太大模型是全球首个跨本体通用具身大模型,核心不是简单回答“下一步该做什么”,而是试图解决一个更接近真实世界的问题:当环境突然变化、原计划失效时,机器人能否自己发现问题、重新判断、调整策略,通过自主智能、自进化,继续完成任务。
在路线选择上,以太大模型被放在 VLA、WAM 之外的“第三条路”来叙述。VLA 更强调从视觉、语言和状态到动作的映射,回答“看到场景后下一步怎么做”;WAM 或世界模型路线进一步引入对未来变化的预测,回答“动作之后世界会怎样”。
而乐享进一步追问的是:预测出来的动作,最终能不能被一副真实的身体做出来。
因为机器人面对的不是屏幕里的下一帧,而是一个会持续反作用于身体的物理世界。重量、摩擦、碰撞、人的突然介入,都可能让原本合理的动作在执行时失效。
因此,以太大模型采用了以神经元分配为核心的能量驱动架构,把目标完成度、动力学一致性、记忆一致性和物理约束放进同一套连续机制中。更通俗地说,机器人不是机械回放训练过的动作,而是在“感知—判断—行动—反馈”的闭环里持续修正自己。现实世界的每一次反馈,都会重新进入模型,影响它下一步的判断和行动。
乐享给出的关键数据是:200小时人类视频、0小时真机训练数据、4B参数。这组数据的意义不在于证明以太大模型已经到达通用智能,而在于它试图探索一条不完全依赖海量真机数据和参数堆叠的 Physical AI 路径。在行业普遍强调数据采集规模、真机时长和参数量的背景下,这组数字本身就是一种路线宣言:如果智能系统只能依靠无限堆料前进,那么它距离真实世界的可复制性仍然很远。
三、在执行中接收反馈,再开始下一步
以太大模型的另一项设计,是把高层认知和底层身体控制放进一条“脑—脊髓贯通”的信息通路。这是借鉴了人类大脑和脊髓的分层协同方式。简单来说,上层像大脑,负责理解任务和规划;中间像小脑,把想法变成动作并随时校正;底层像脊髓,处理平衡、力控和避碰等快速反应。更关键的是,这不是一条单向指令链,身体得到的真实反馈还会重新传回“大脑”,继续改变判断。
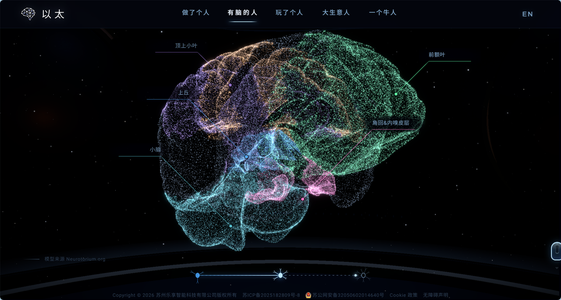
其核心主张是,认知和身体控制不应是割裂模块,而应形成双向贯通的信息流:思考结果流向身体,身体反馈再回传改变判断。这样一来,机器人不是先“想清楚”再“僵硬执行”,而是在执行过程中持续接收现实反馈,并根据反馈修正下一步行动。
落到直播里,技术最终还是要变成可以被观察的行为:任务被打断后还能接回来,抓取失败后会调整,信息不够时主动寻找新的观察角度,不同机器人还能围绕同一任务持续协作。
这些能力背后指向的其实是同一个问题:机器人能不能在现实不断变化时,继续保持对任务的理解。
跨本体是这场直播里容易被低估的一点。过去很多机器人智能展示,本质上是“一套算法适配一台机器”。一旦换本体、换关节结构、换自由度,原有能力就可能失效。
而以太大模型希望证明的是,智能不必被锁死在某一副身体里。烧烤机器人和服务机器人形态不同、动作边界不同,但它们运行的是同一个“大脑”。以太大模型让大家看到的是,当同一套智能进入不同身体以后,能不能根据各自能力边界找到合适的执行方式,并继续围绕共同目标协作。
这比单机完成动作更难。因为多机协作不只是“各自做好自己的事”,还需要理解对方状态、任务进度和现场优先级。直播中,服务机器人会在感觉顾客等待过久后主动确认出餐进度,烧烤机器人也会指引服务机器人取走可以先上桌的餐食。这类互动未必完美,但它呈现出一种方向:机器人之间开始围绕目标进行动态协同,而不是各自执行孤立脚本。
四、具身智能评价标准从“成功一次”转向“持续成立”
当然,一场近1小时的直播不足以证明“机器人已经通用”。它仍然是一个经过设计的任务场景,烧烤流程有边界,现场干扰虽然随机,但仍在安全可控范围内。外界可以继续追问:如果任务从烧烤换成更复杂的家庭整理、餐饮高峰、工业操作,以太大模型是否还能保持稳定?自进化沉淀下来的经验,能否跨场景、跨本体长期迁移?系统在面对更高风险场景时,安全边界在哪里?这些问题,显然需要更多场景、更长周期和更多第三方复测来回答。
但即便如此,这场直播仍然改变了一些东西。过去两年,具身智能行业习惯了用精修Demo证明“机器人做到过”:几十秒高光、最佳机位、反复重拍、剪掉失败。乐享这次反其道而行,把失败、停顿、临场补位和不可控干扰都留在了镜头里。它未必证明了Aether已经无所不能,却把一个更尖锐的问题抛给了行业:当预设条件被拿掉,机器人还能不能继续把事做完?
这也是这场直播可能带来的行业影响。它把具身智能的性能评价标准往前推了一步:从“演示里能不能成功一次”,转向“真实世界里能不能持续成立”;从“谁的视频更好看”,转向“谁敢把模型放到开放环境里接受围观”。当机器人开始走出实验室,行业需要比较的,也不应该再只是最好的一次,而是计划失效之后还有多少持续进化,且解决问题的能力。
结语:让机器人智能自己长出来
烧烤只是考题,不是答案。真正被围观的,是机器人在现实世界不照着程序走时,是否开始具备自己想办法的能力。
从跨本体、自主决策到自进化,乐享科技想推动的,也不只是一个更强的机器人模型,而是一套面向真实世界持续成长的具身智能底座。
如果说过去的具身智能更多是在回答“机器人能做什么”,那么下一阶段要回答的,可能是“机器人的智能能不能自己长出来”。而这,正是乐享科技试图打开的具身大模型新时代。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”