从硅基流动 Token 工厂看国产算力价值兑现之路
随着 AI Agent 在业务场景的落地,Token 消耗指数级增长,企业的 AI 落地需要持续、稳定、安全、高效、高性价比的 Token 服务作为支撑。但买回来的算力可能变为库存,芯片交付只是起点,模型能否在这颗芯片上高效运行,往往决定了它能否进入实际生产环境。换句话说,芯片本身决定了算力上限,而软件决定了这个上限里究竟有多少能被真正兑现。
当国产算力从“能用”走向“好用”,决定其商业价值的已不仅是芯片本身的峰值性能,还有让模型真正跑起来的那层系统软件。这个软件层已经从产业链的专业化分工中被推向台前,变得越来越重要,成为从芯片到 Token 价值兑换的关键一环,这背后的根本原因是:算力侧芯片架构多元,模型侧版本迭代迅速,客户端部署需求分化,跨芯片与多模型的适配复杂度持续攀升。
硅基流动,一家“开放、独立的词元(Token)供应平台”,于 2026 年 6 月向港交所递交上市申请,刚刚宣布完成 B+ 轮二期和 C 轮融资,2026 年度累计股权融资额近 29 亿元。其核心技术包括推理引擎与算力资源编排系统,前者负责跨芯片及多模型的适配与优化,后者则聚合不同供应商、不同硬件架构下的异构算力,将其转化为标准化的词元供应。这家公司用一系列可核验的公开记录,提供了一个观察国产算力如何通过软件层兑现价值的典型样本。
跨芯片 x 多模型,持续投入与领先成果
硅基流动对跨芯片推理的投入,早在 2023 年就已启动,到 2025 年 DeepSeek 热潮之前已有持续性技术研发与工程经验积累。这也离不开核心团队此前在 AI 系统软件上的经验,这是一个具备跨学科研发能力的团队,涵盖计算机科学、应用数学、深度学习算法、分布式系统、底层系统优化、AI 框架工程及 AI 基础设施开发等多个不同领域。
这才有了在 2025 年 2 月这个时间节点,硅基流动快人一步,率先推出部署在华为昇腾上的 DeepSeek R1/V3 服务,让国产算力推理走进商业化现实。
据硅基流动招股书,从 2023 年成立至 2025 年底累计研发费用约 2.84 亿元。这笔钱主要投向推理引擎优化、新模型适配、异构算力调度系统升级、下一代推理架构研发等核心技术领域,以及开展严格测试与验证所需的大量算力资源成本。技术研发全部由内部团队完成,未依赖第三方核心技术。
多芯片覆盖背后,需要持续处理软件兼容、通信、内存与精度等问题,这些投入到底取得了哪些领先的技术成果?
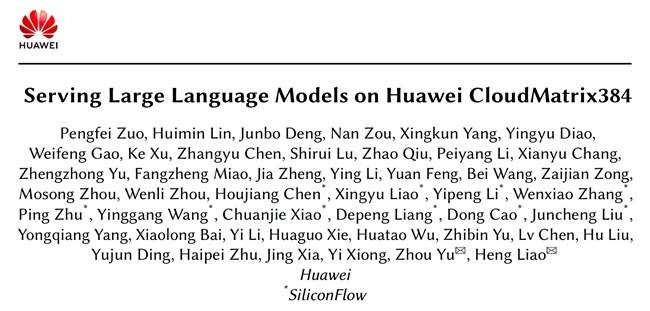
先关注一份重磅论文。2025 年 6 月,华为与硅基流动共同署名发布论文《Serving Large Language Models on Huawei CloudMatrix384》,这组数字是关键:在该超节点上部署 DeepSeek-R1 时,预填充吞吐量达到 6,688 token/s/NPU、解码阶段 1,943 token/s/NPU;按单位算力计算效率,预填充达 4.45、解码达 1.29 tokens/s per TFLOPS,双双超过 NVIDIA H100 与 H800 上的公开结果。服务在保证单用户 20 TPS 的前提下,单卡 Decode 吞吐突破 1,920 Tokens/s,性能比肩 H100;精度方面,昇腾 NPU 的 INT8 量化版本在 16 项权威基准测试中的准确率与 DeepSeek 官方 API 几乎一致。
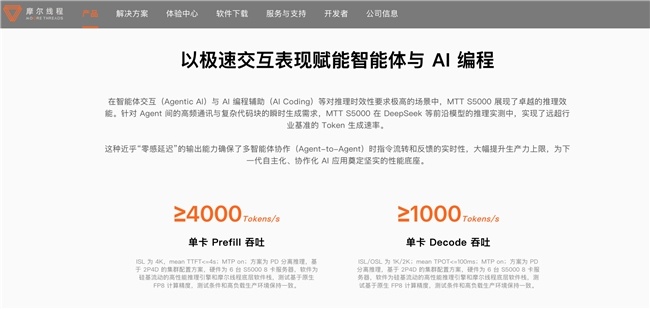
摩尔线程在其 MTT S5000 产品页上,列出了一组采用硅基流动推理引擎的 DeepSeek 性能数据:在 48 卡集群、2P4D 并行配置、FP8 精度等特定测试条件下,单卡预填充吞吐超过 4000 Token/s,解码吞吐超 1000 Token/s。芯片厂商愿意在自己的产品介绍中引用第三方软件引擎的性能,这说明:软件能力已进入国产算力性能优化链条中的关键位置。
异构混部的探索同样值得关注。2026 年 8 月,硅基流动与摩尔线程公开了一项 P/D 分离异构算力混部实验:4 台 S5000 预填充服务器搭配 2 台国际 GPU 解码服务器,对照为 4 台国际 GPU 的 2P2D 配置,两端均使用 FP8。这种方案让不同芯片在同一服务中各司其职,国产算力在预填充阶段切入生产链路,而非要求所有芯片在所有环节性能一致。其商业含义在于扩大可用供给与配置空间,而非简单的整机成本减半,为国产算力大规模商业化部署提供了可量化、可复制的实践路径。
硅基流动还与沐曦合作,在曦云 C550 集群上全球首发万亿参数模型 Kimi-K2 的商业化推理服务。同一套软件,可以横跨昇腾、沐曦、摩尔线程等多款国产芯片,把它们的理论算力逼近硬件极限。此外,在智源主导的跨芯片算子库 FlagGems 中,硅基流动是公开列明的贡献单位之一。
国产芯片“能用”是一回事,“跑得够准、够快、够稳”是另一回事,后者由软件决定,硅基流动无疑是推理软件层的领跑者。
多场景落地案例,上产线的算力才能发挥价值
一切技术的说服力,终究要落到真实的生产系统上。据公开数据,截至 2026 年 4 月,硅基流动平台注册用户超过 1,000 万,服务企业客户超过 1.3 万家;其解决方案在 AI、互联网、能源、金融、电信等领域头部客户场景深度落地。
能源领域,一家能源央企将硅基流动自研的大模型推理引擎选为优选方案,构建高性能大模型推理平台。这套体系的价值不在于把算力简单池化,而在于“随用随扩、按需调度”的弹性:前缀缓存技术节省超过 60% 的重复 Prefill 推理资源;持续批处理降低单请求的平均处理时间与整体延迟;单实例可承载 3 倍以上常规模型吞吐量。在客户高度关注的国产化与供应链韧性上,推理引擎通过统一的芯片接口抽象层与硬件资源插件机制,让新硬件接入保持“平滑迁移”。
交通领域,一家大型航空央企引入同一套推理加速框架,在算子、推理、模型三层分别击穿瓶颈:国产芯片利用率大幅拉升,AI 系统响应速度提升 2 至 5 倍,智能助手并发能力提高 3 倍,推理成本降低 60%,模型更新周期从数周压缩到 3 天以内。支撑这一切的,是一条被打通的“国产芯片+国产模型+国产推理引擎”全栈闭环,是一份可复制到整个交通行业的 AI 国产化模版。
在算力运营侧,2026 年 5~8 月,硅基流动密集签约,与武汉光谷爱计算、贵州移动、北京数据集团、贵州数家科技、算家计算、山东铁路发展基金、浙江省数据集团、宇信科技等多家合作伙伴发起算力联合运营项目。共建 Token 工厂,一方提供推理软件与流量资源,一方提供算力资源,把全国各地的算力底座直接转化为可调用、可计费、可交付的 Token 产能。
国产算力大规模落地,硬件是基座,软件是桥梁
2025 年,国务院发布《关于深入实施“人工智能+”行动的意见》明确提出了两个方向:“强化智能算力统筹”,“支持人工智能芯片攻坚创新与使能软件生态培育”,“完善全国一体化算力网”;发展“模型即服务”、“智能体即服务”,“打造人工智能应用服务链”。硅基流动的工作恰好落在这两个方向的交叉点:在多种国产芯片上进行算子、框架及推理等多层联合优化,同时以多种服务方式提供模型能力并参与开放的应用生态。
2026 年 8 月,工业和信息化部印发《信息通信行业发展“十五五”规划》,明确提出“有序部署万卡、十万卡及以上智算集群,面向场景按需部署推理算力设施,加大力度适配国产算力芯片”。这一政策信号表明,大模型跑在国产芯片上的推理效率成为产业关注的核心命题。
硅基流动的实践,是一条推动国产芯片从可用到好用的实干路线。早期跨芯片研发投入、两年超 2.8 亿元的累计研发费用、与芯片厂商、模型厂商深度合作,链接算力、模型与应用,通过公有云与本地部署以及联合运营等创新方式实现商业转化。
国产算力的价值兑现,不止于芯片出货。从一颗芯片到一笔模型服务的 Token 收入,中间需要经历权重加载、算子适配、并行调度、性能验证、故障处理等一系列系统软件工程。正是这些“看不见”的环节,决定了芯片在真实负载下能交付多少有效工作量、创造多少业务价值。
国产算力的大规模落地,硬件是基座,软件是桥梁,而这座桥梁,正在成为价值兑现的关键变量。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”