
刚刚,华为昇腾960超节点提前登场!韬定律立功性能翻倍,剑指英伟达



智东西
作者 | 李水青
编辑 | 心缘
智东西9月17日上海报道,昨日,华为监事会主席郭平关于“华为ICT与计算的目标是成为‘英伟达’”的内部访谈内容刚刚刷屏,今日,华为就对外放出了憋了一年的算力“大招”。
在刚刚开幕的华为2026年全联接大会上,华为灵衢互联架构及超节点集群方案重磅亮相,华为推出了昇腾960DT芯片、昇腾960超节点、鲲鹏950超节点升级、OceanStor M900记忆存储、灵衢全光交换设备等一系列AI基础设施新品。
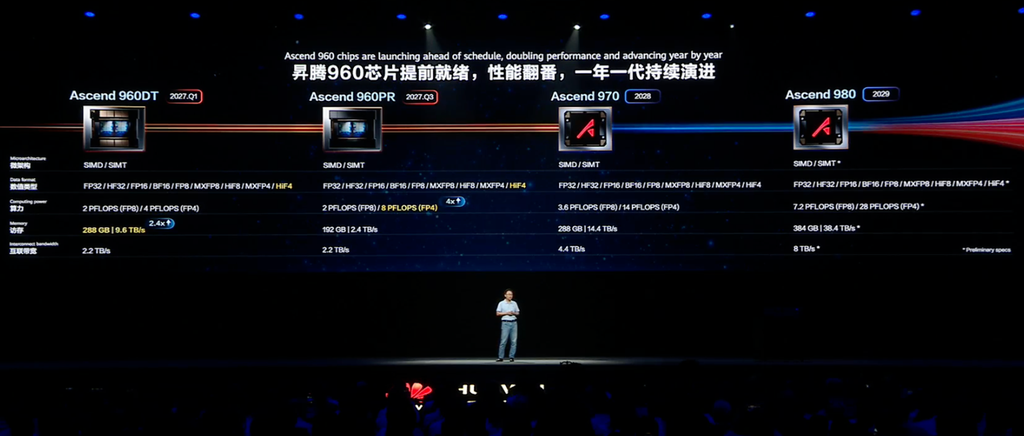
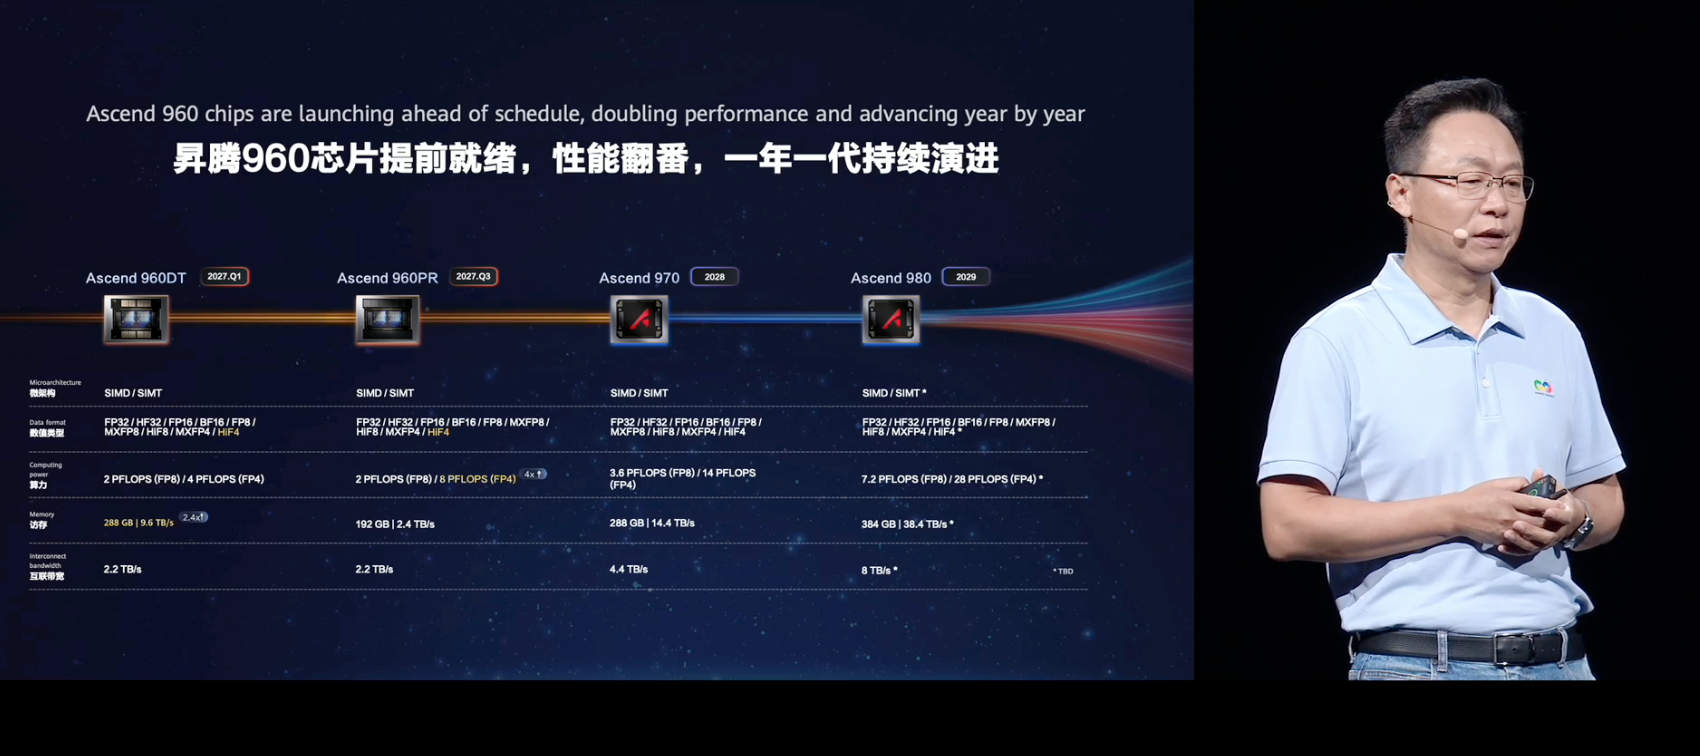
华为副董事长、轮值董事长汪涛现场宣布,昇腾960DT芯片将提前就绪。该芯片支持2 PFLOPS(FP8)、4 PFLOPS(FP4)算力,相比上代实现翻倍性能。汪涛称,该芯片目前研发超预期,预计2027年一季度将就绪。
华为昇腾系列芯片的提前就绪离不开韬定律。依托这一 “时间缩微” 替代 的创新方向,华为昇腾系列芯片将继续坚持一年一代的演进节奏。在2028年和2029年,华为将陆续推出昇腾970和980芯片,来实现算力性能继续翻倍。
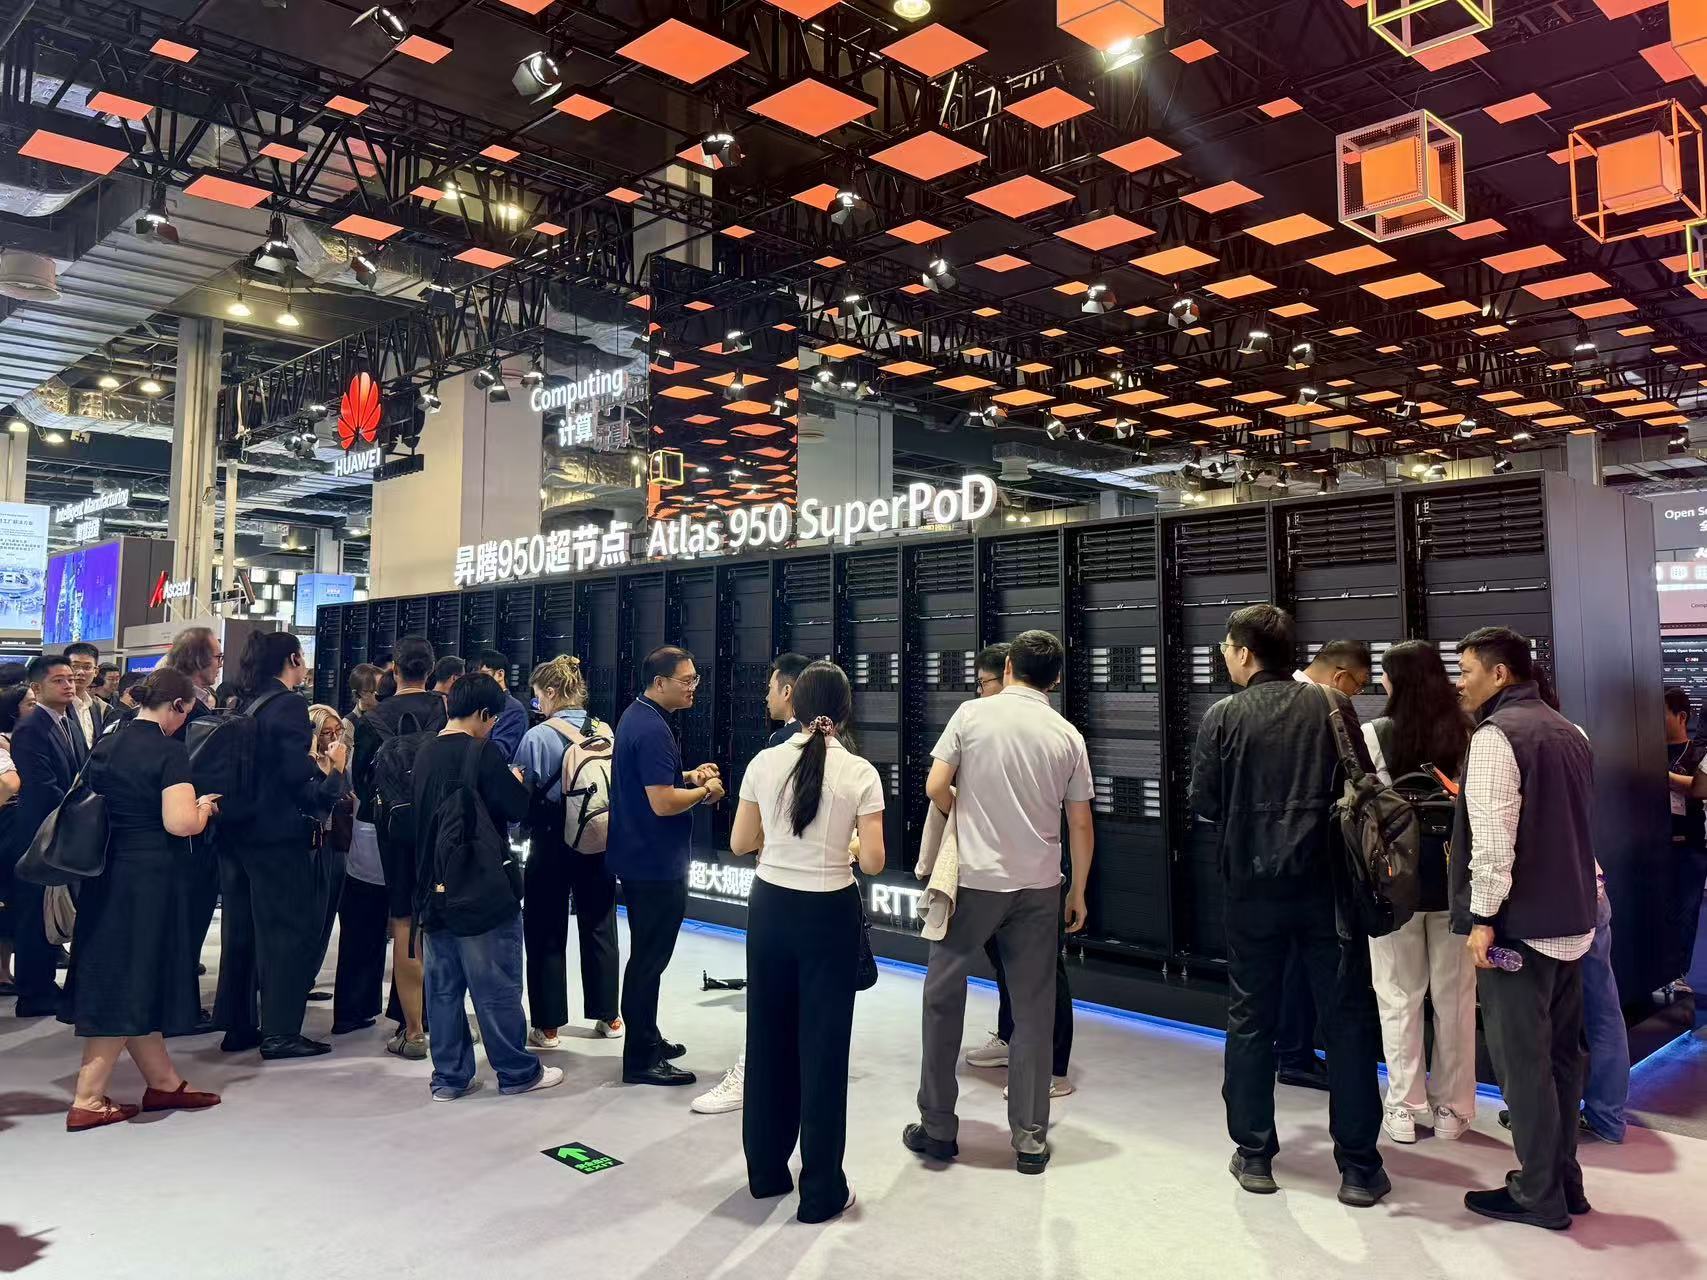
汪涛还透露,华为昇腾910C超节点已部署超过1000套,昇腾950超节点已经开始规模商用。
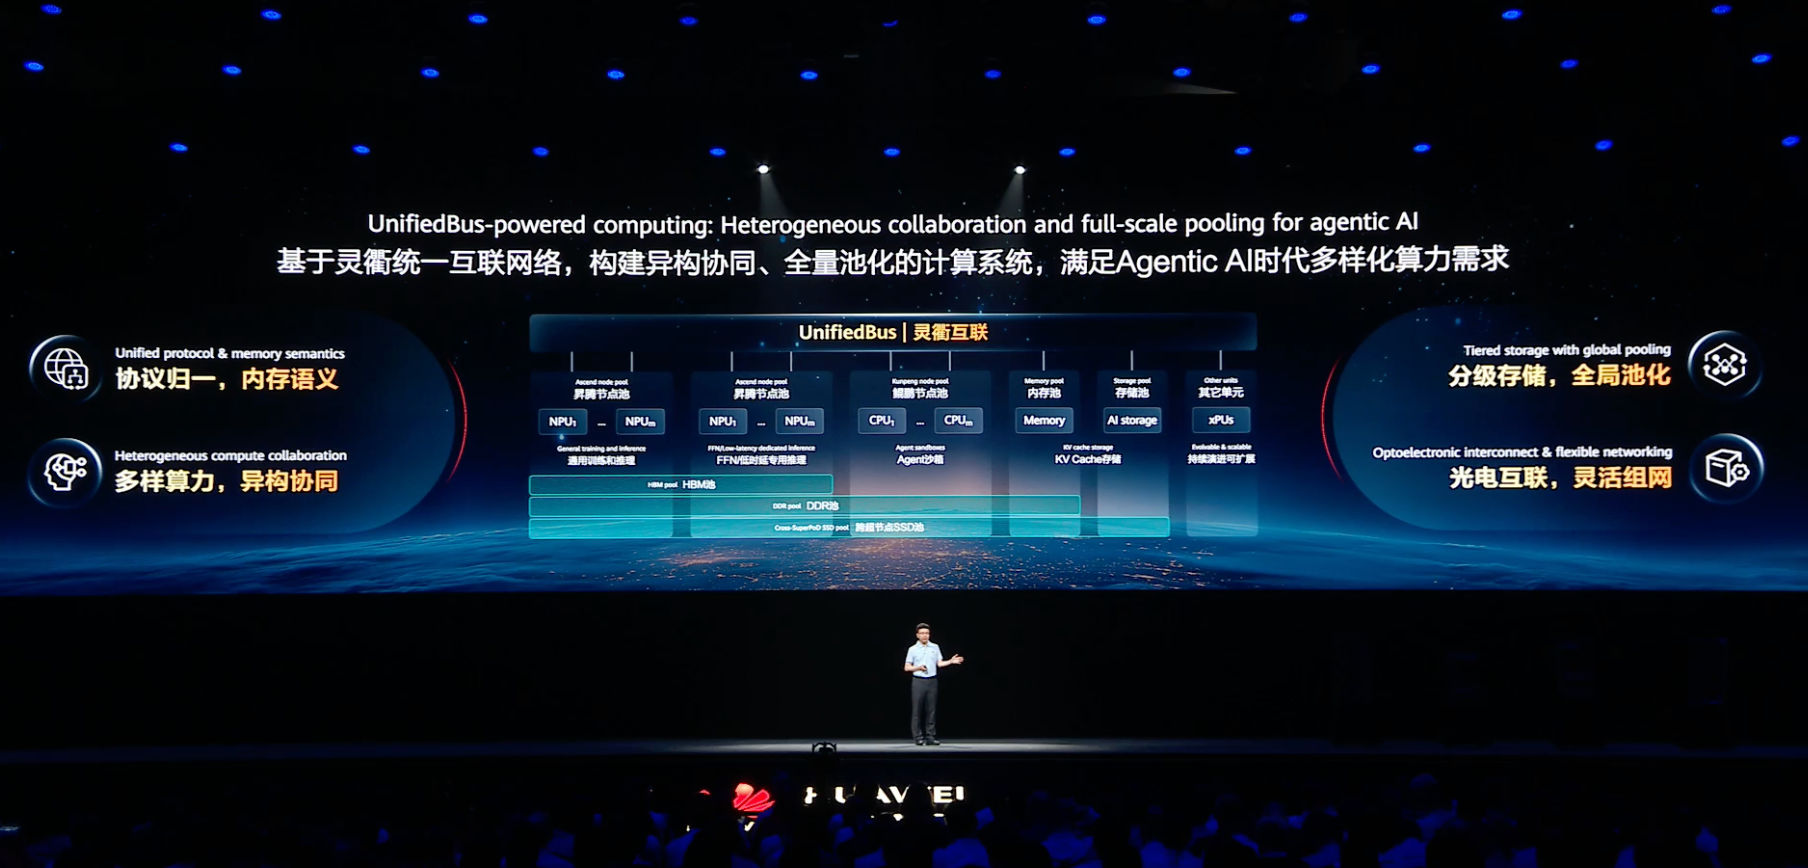
本次发布的更深层焦点——灵衢UnifiedBus,是华为整个算力底座的统一互联总线协议。华为常务董事、ICT BG CEO杨超斌在演讲中提到,基于灵衢UnifiedBus的单集群可支持100万颗AI处理器,10万卡集群的模型浮点算力利用率(MFU)从20%提升至35%。
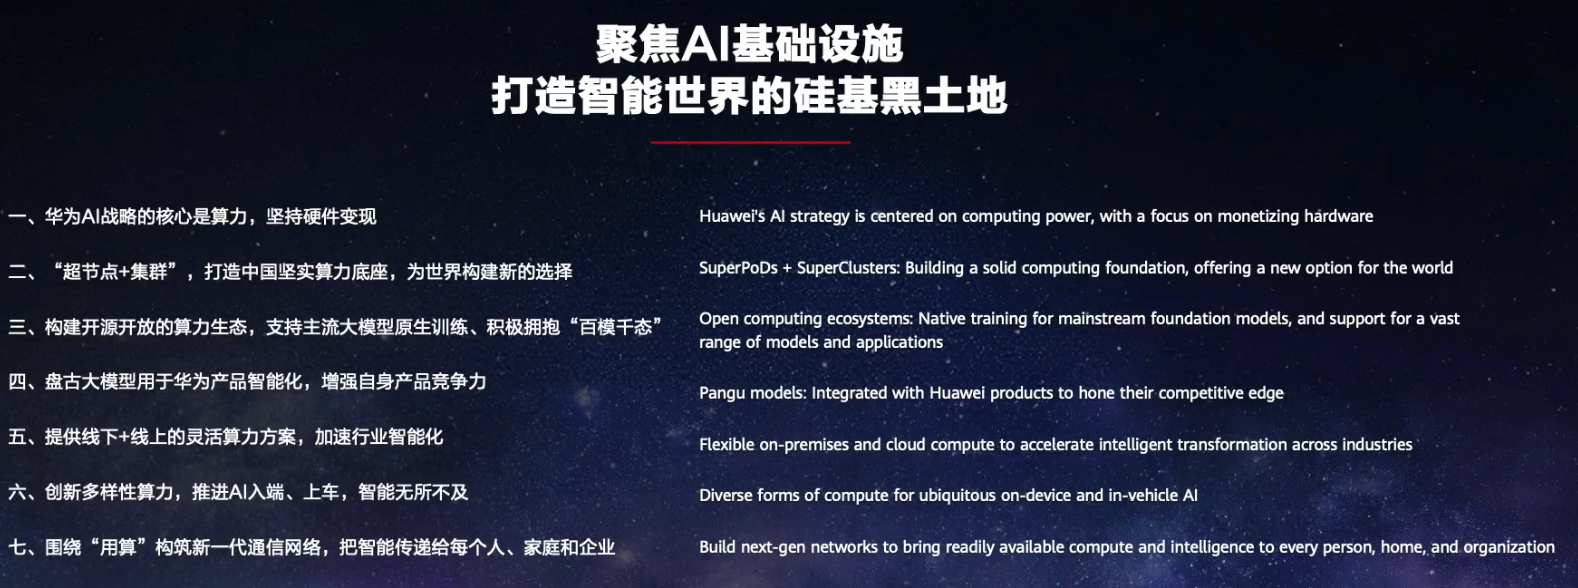
汪涛谈道:“AI变革的速度超过历史上任何一次技术革命,智能世界正加速到来。”强大的AI基础设施是智能世界的坚实底座,为此华为坚持聚焦打造智能世界的硅基黑土地,包括“AI战略的核心是算力,坚持硬件变现”、“超节点+集群,打造中国坚实算力底座”等七大战略。
生态方面,汪涛宣布华为昇腾已经跨越生态拐点,CANN社区月活开发者突破5000多名,外部开发者首次超越了内部开发者,占总开发者数量的61%。
华为鲲鹏生态全球开发者超过了416万,支持了560多个全球的开源项目;openEuler(开源欧拉)的装机量也超过了2000万套,成为中国服务器操作系统份额第一。
一、打破10万卡集群通信墙,华为憋了一年的大招来了
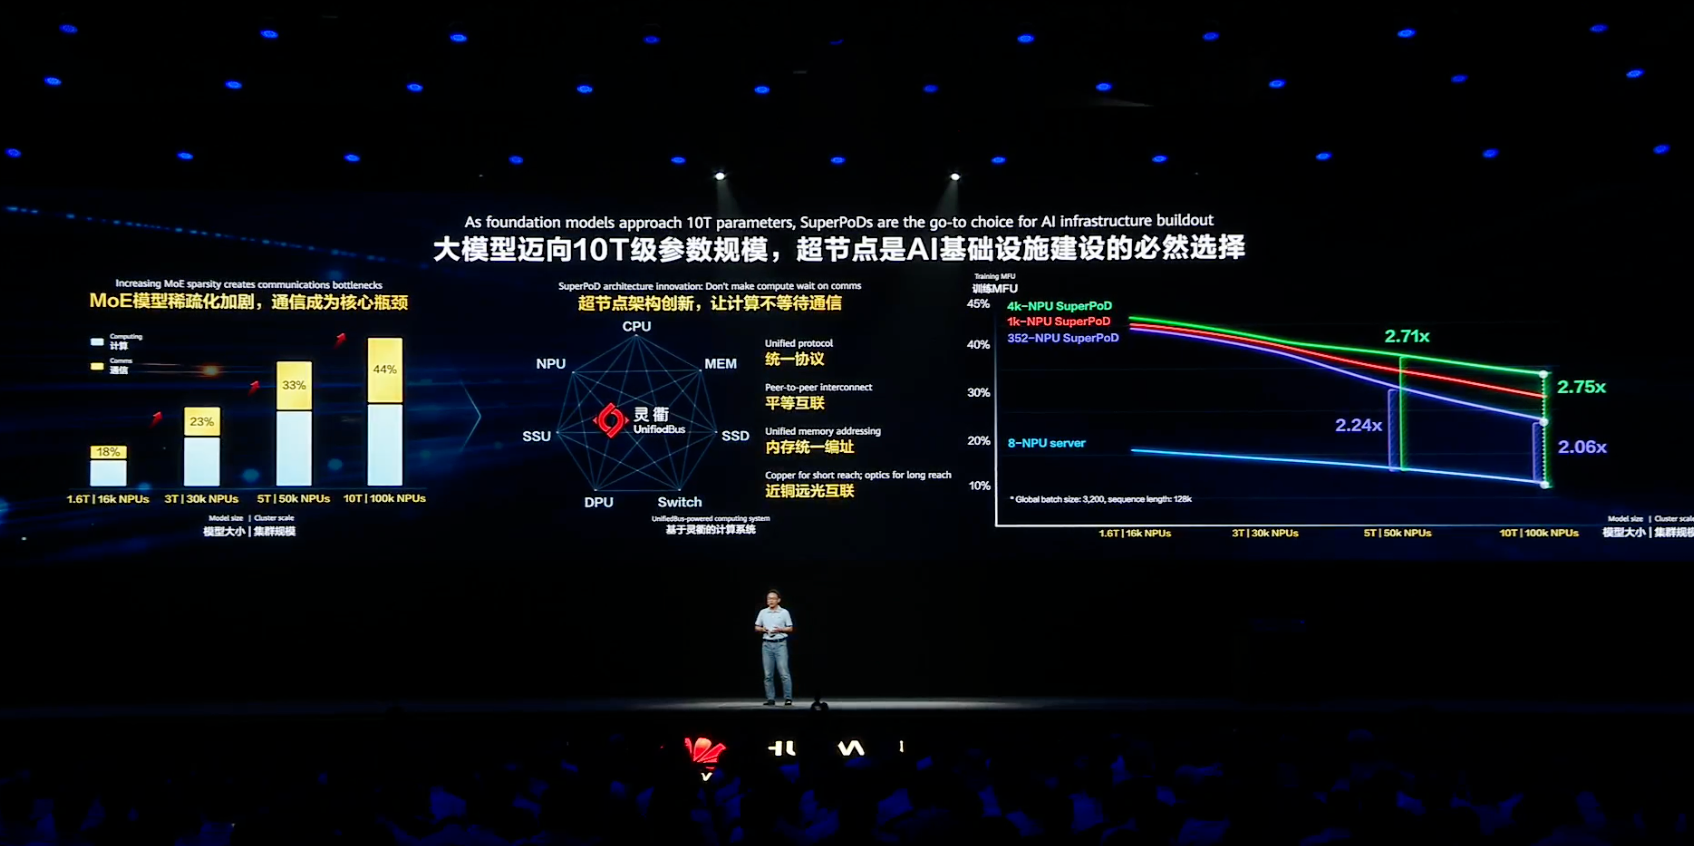
大模型迈向10T级参数规模,超节点是AI基础设施建设的必然选择。
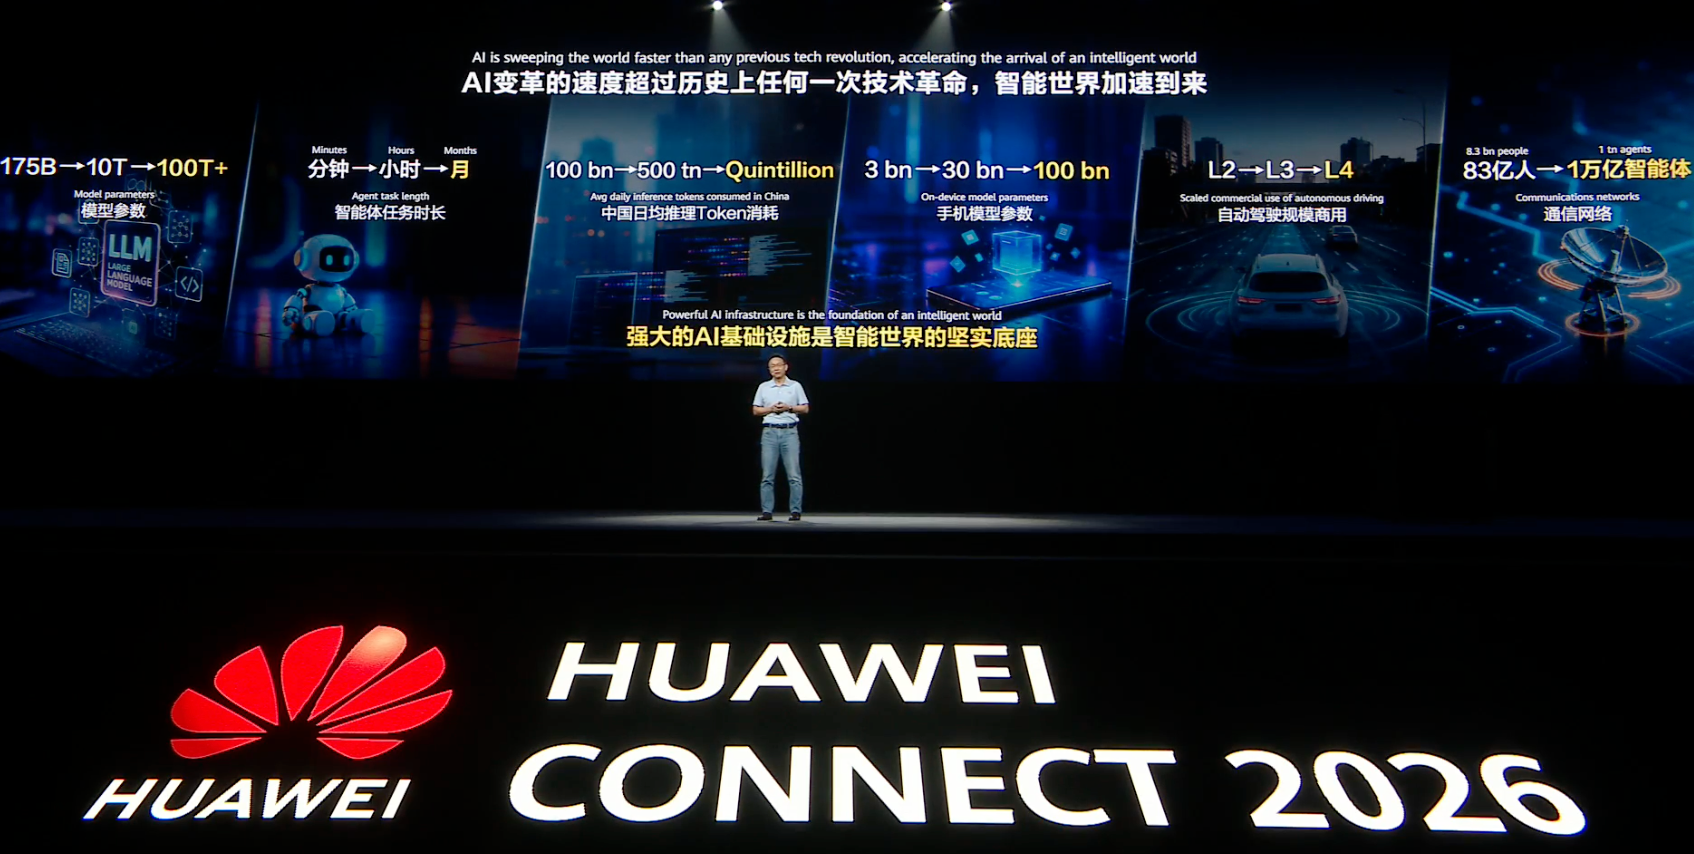
汪涛认为,10万卡算力集群即将成为训练SOTA模型的标准配置,但也面临巨大挑战:大规模跨节点通信开销巨大,导致MFU(模型浮点算力利用率)提升困难,集群整体有效算力远低于卡数简单相加的理论值。
因此,围绕减少通信占比来优化计算系统架构,是构建一套高效率的AI基础设施的合理技术选择。
华为的超节点设计的理念,是以一套协议平等连接超节点内所有组件,支持跨物理服务器的统一内存编址,并采用近铜远光的这种互联方式,从而使数万颗芯片之间的通信有近乎线性的带宽与时延。它像一台计算机一样工作,能够有效提升MFU。
为了打造这套复杂的系统,首先要有能够平等连接集群内所有组件的互联协议。
这就是华为在去年HC大会上推出的灵衢UnifiedBus,相关技术规范已经全面开放。今天,以灵衢UnifiedBus为核心的全新超节点“全家桶”重磅登场。
二、灵衢一统、11芯撑起、昇腾960面世:华为超节点冲向百万卡
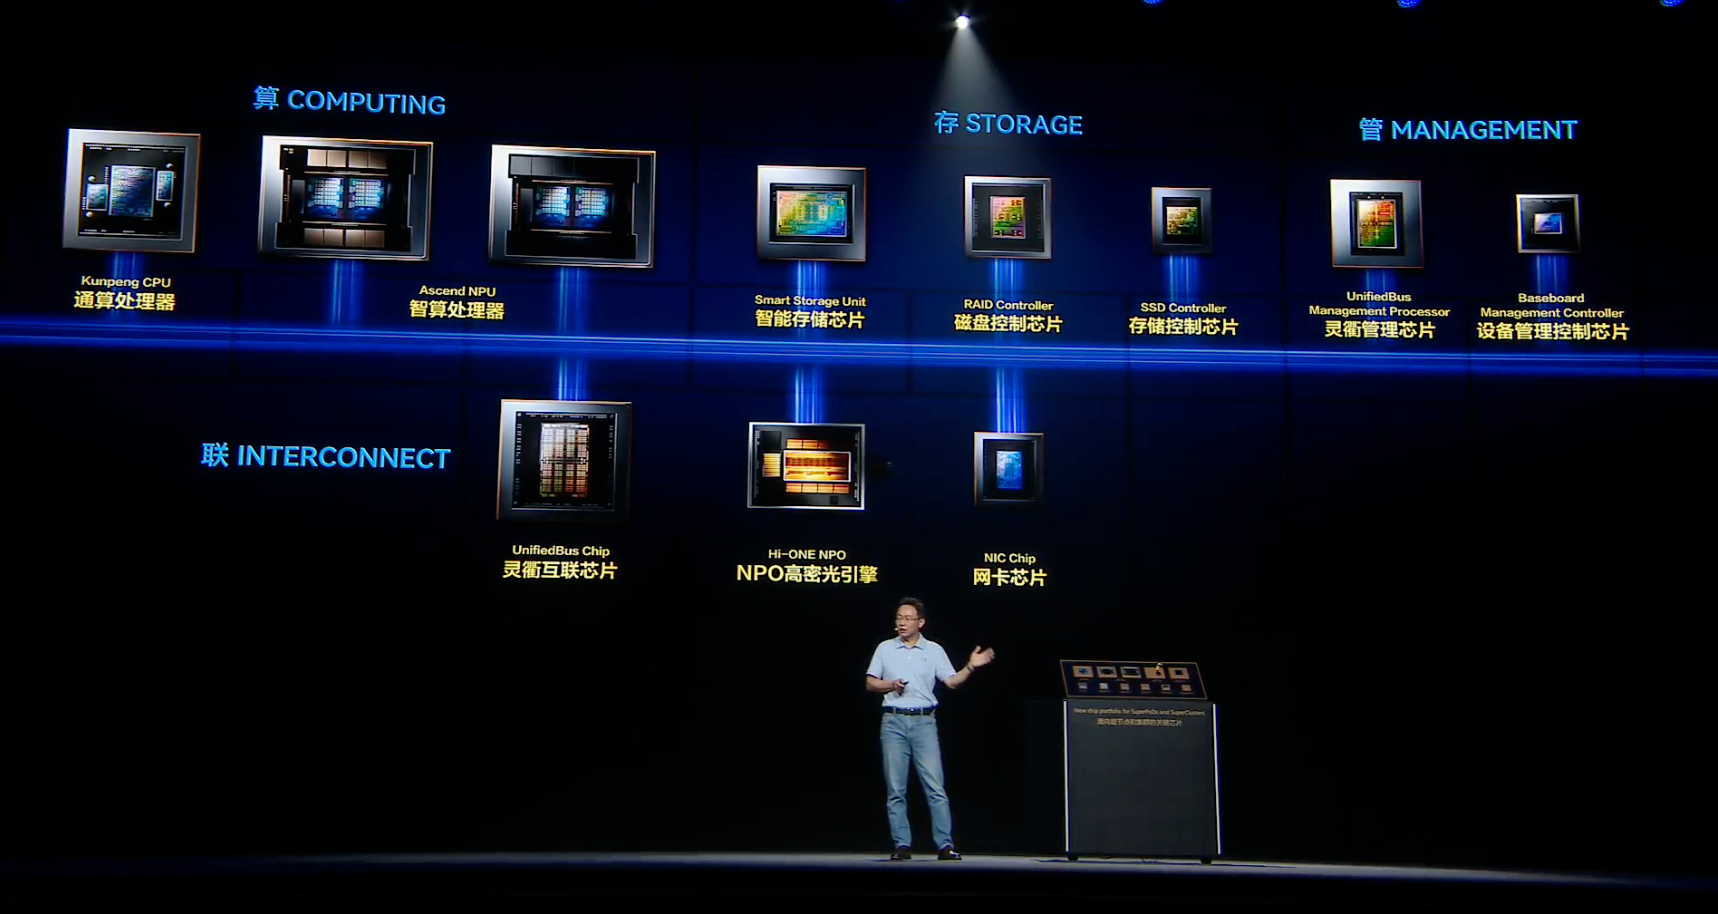
汪涛继续谈道,基于灵衢UnifiedBus,华为目前已打造了超节点和超节点集群开发11颗关键芯片。
1、11颗芯片撑起超节点,昇腾960DT来了
在所有芯片中,昇腾芯片是整个系统中的核心部件。
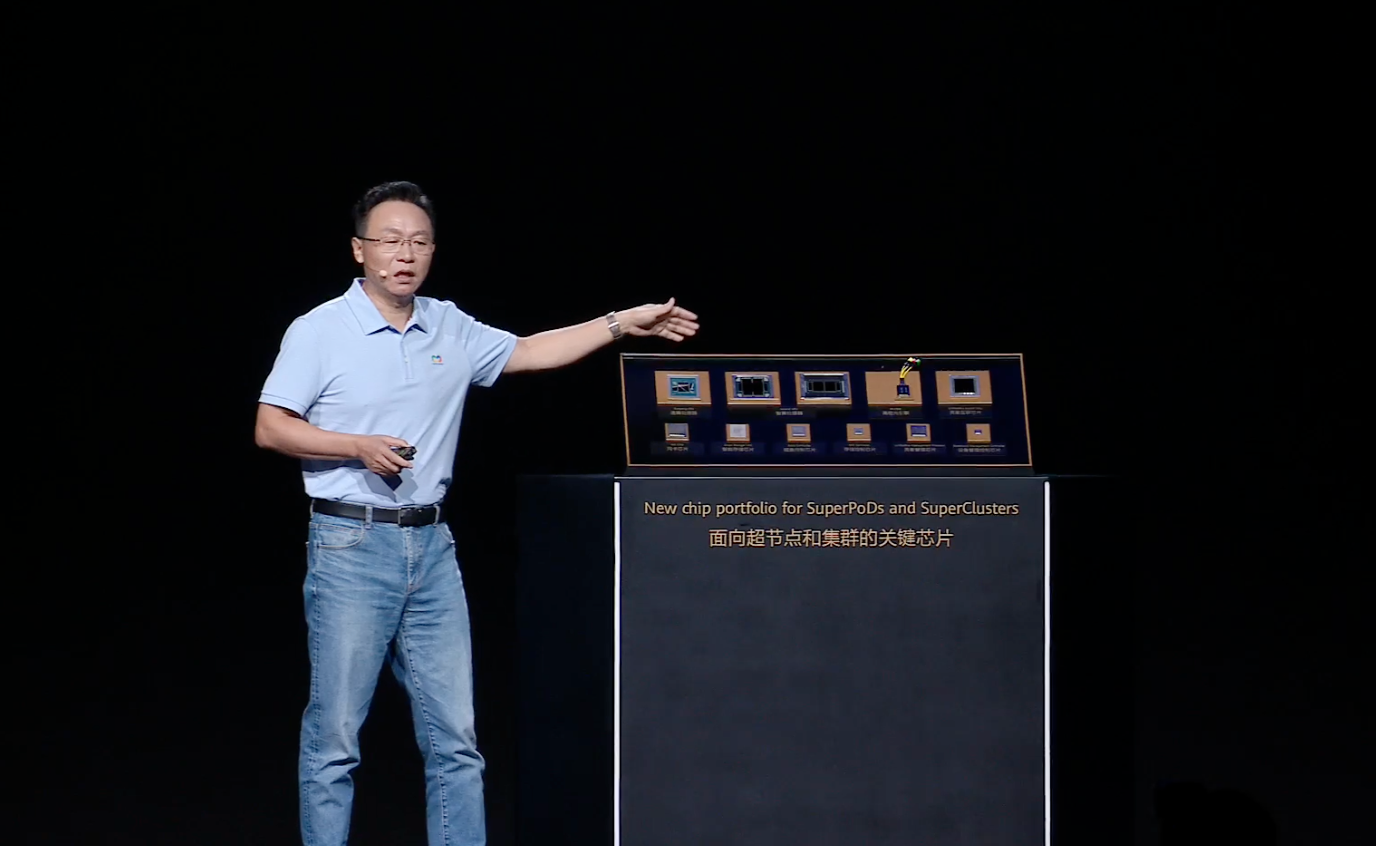
汪涛现场宣布推出昇腾960DT芯片。该芯片支持2 PFLOPS(FP8)、4 PFLOPS(FP4)算力,片上HBM最大可支持288GB,带宽可以支持到9.6TB每秒,能实现翻倍性能。该芯片目前研发超预期,比原计划目标提前三季度,预计2027年一季度将就绪。
昇腾960PR将进一步支持8 PFLOPS的FP4算力,比原计划提前一季度,预计2027年的三季度可以准备就绪。
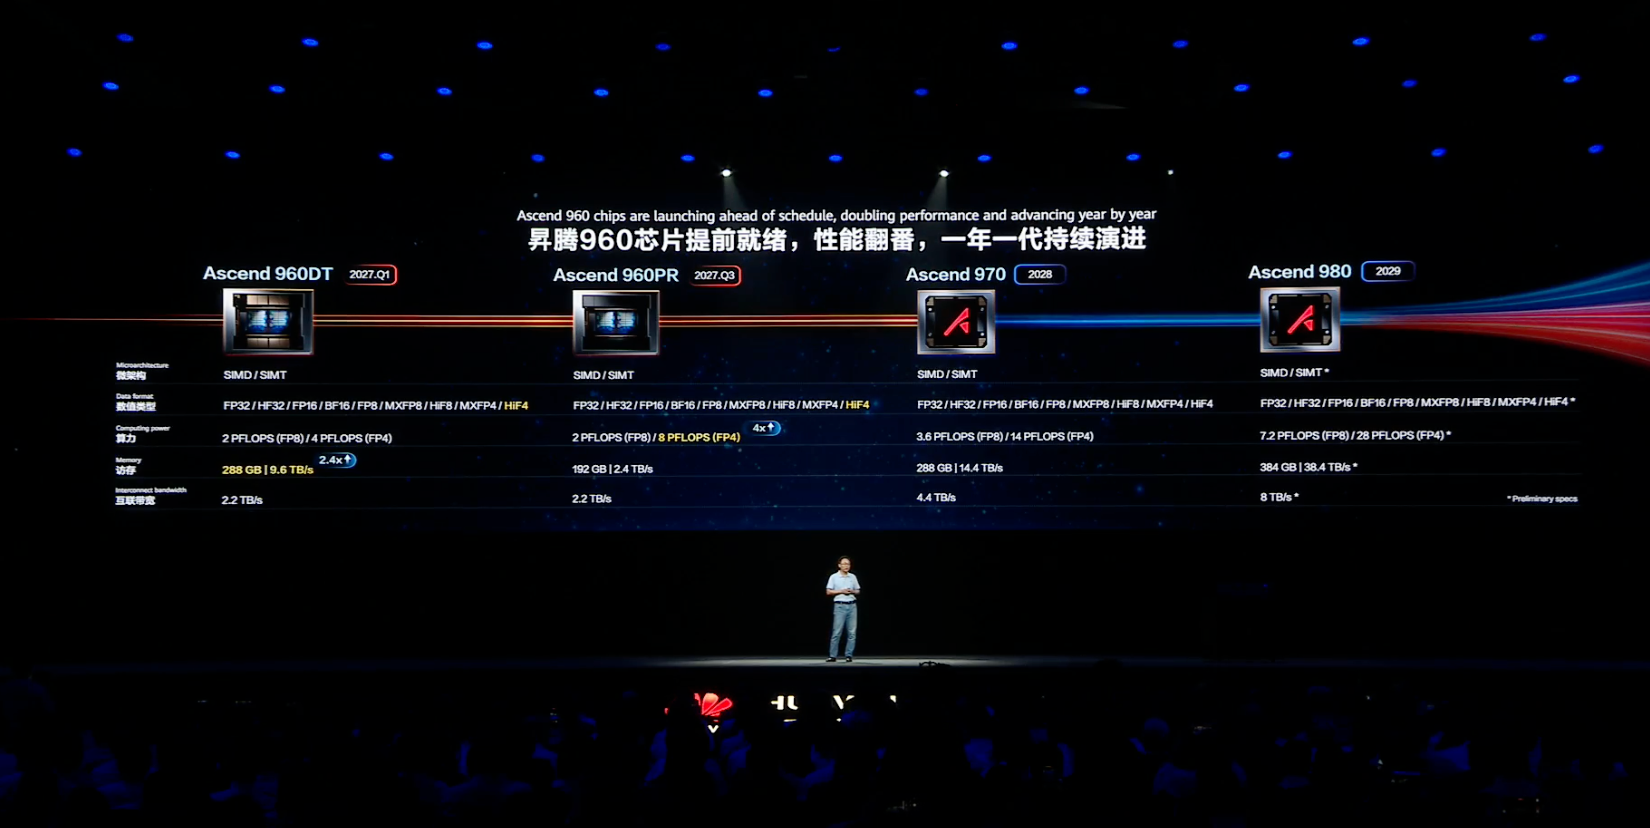
未来,华为昇腾系列芯片将继续坚持一年一代的演进节奏。在2028年和2029年,华为将陆续推出昇腾970和980芯片,依托韬定律的创新方向来实现算力规格继续翻倍,仿真带宽、仿真容量、互联带宽等也会大幅提升。
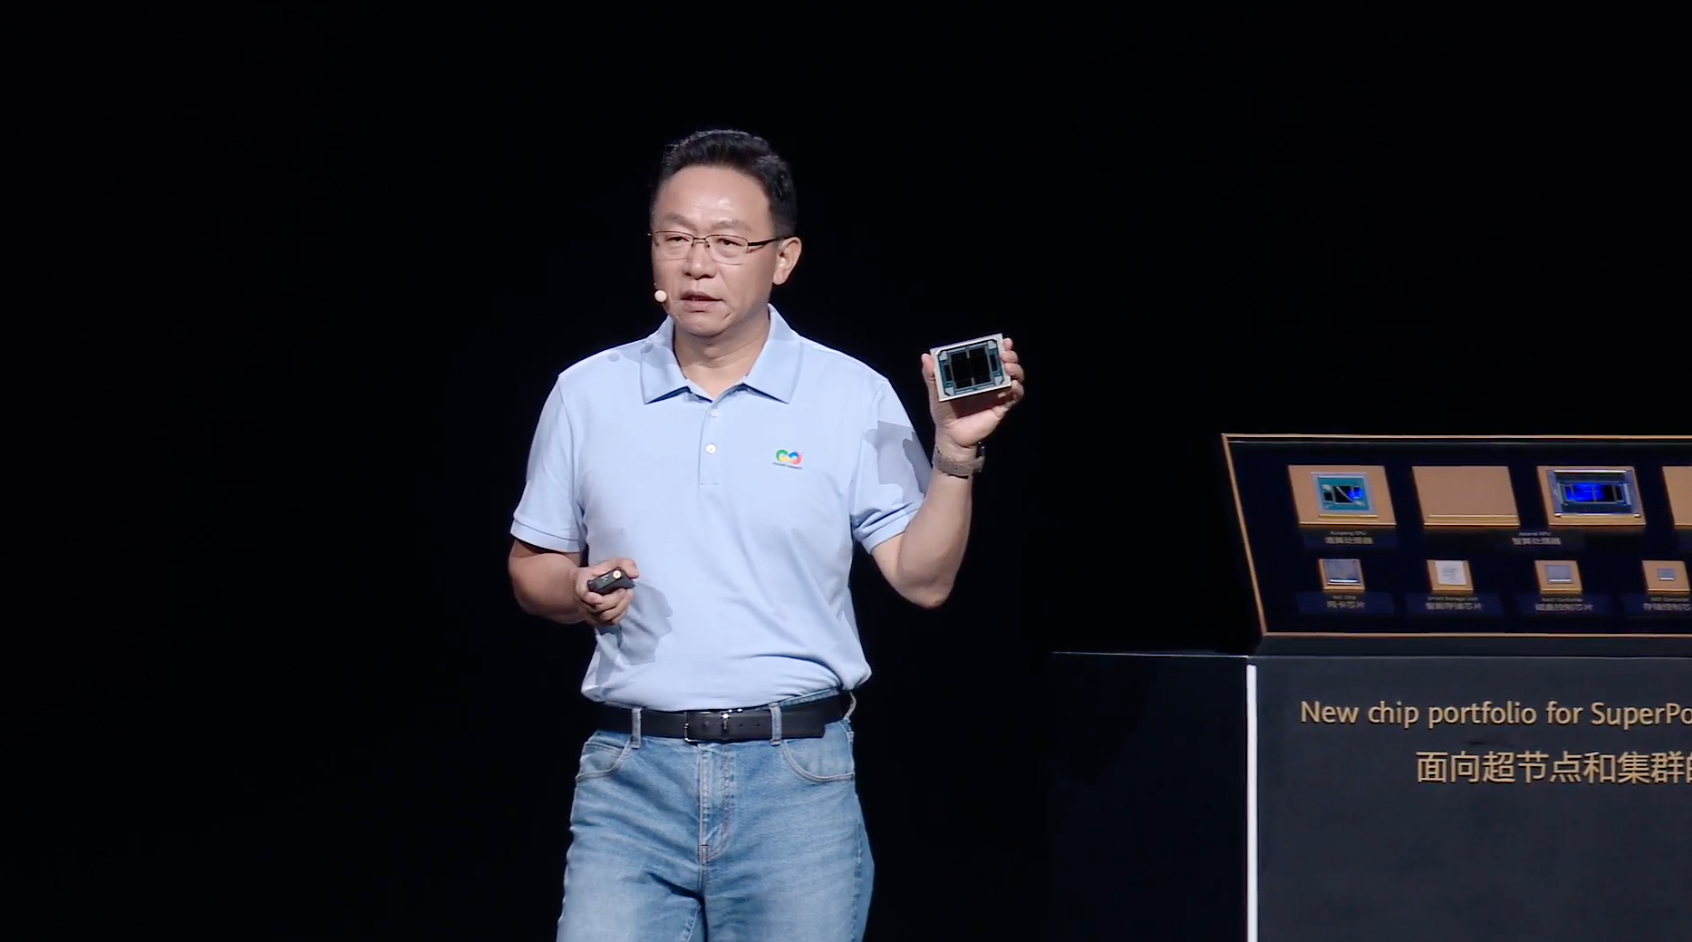
汪涛还现场展示了基于灵衢UnifiedBus的超节点集群11颗关键芯片,主要包括以下四类:
(1)计算类芯片,包括鲲鹏CPU、昇腾NPU,它是关键的计算芯片,承担着最重要的计算功能。
(2)互联类芯片,它不仅有Scale-out平面,大容量的交换芯片,更要有Scale-up平面的低时延的交换芯片。同时它面向未来跨柜的高速互联,还必须要有能够实现高速光互联的芯片。
(3)存储类的芯片,除大家熟知熟知的介质控制控制器芯片。华为为AI的KV Cache专门打造了Smart Storage Unit,以实现平等的一跳直达的缓存系统。
(4)还有各类管理功能的套片,来实现复杂系统中各方面的协调与管理。
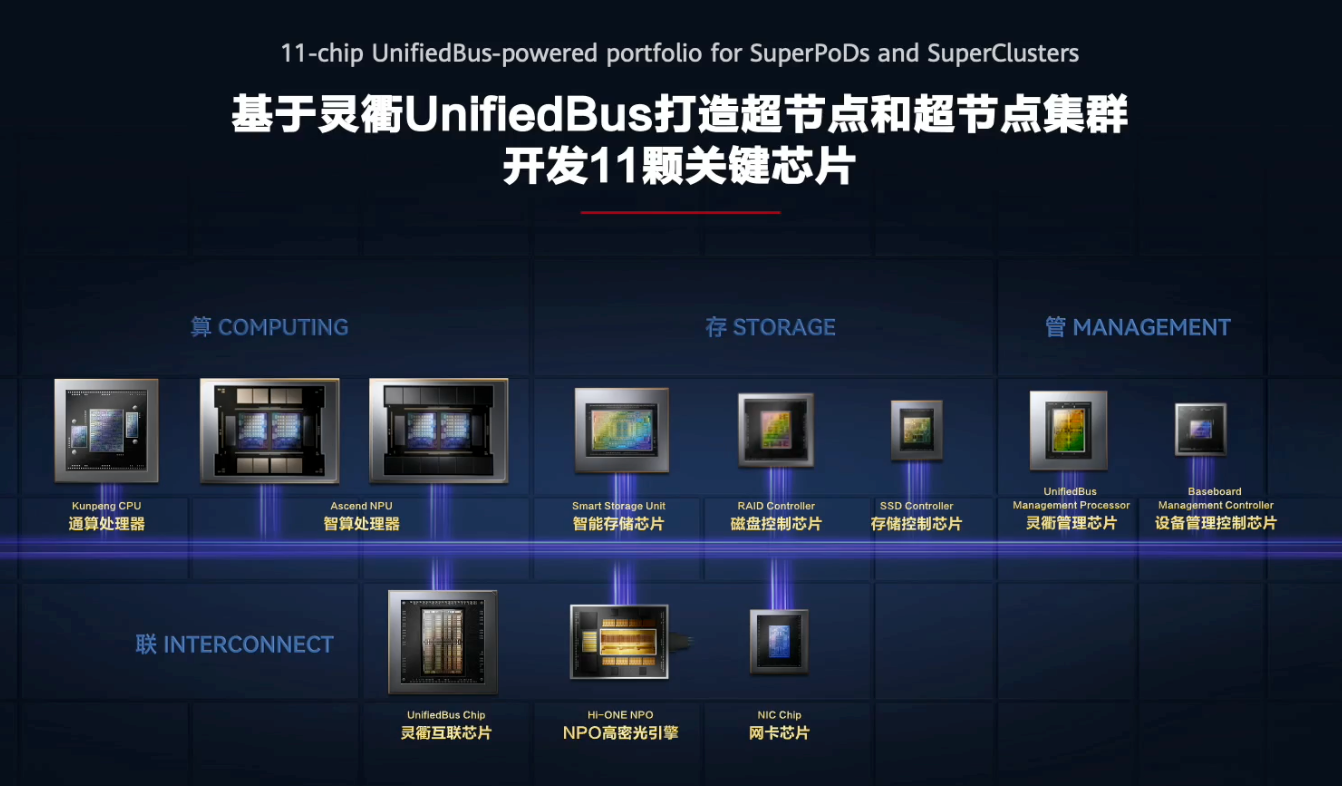
汪涛称,正是有了这11颗关键芯片,华为才能够为AI打造更有竞争力的超节点和集群。
2、推出业界首个量产NPO,昇腾960超节点冲上4096卡
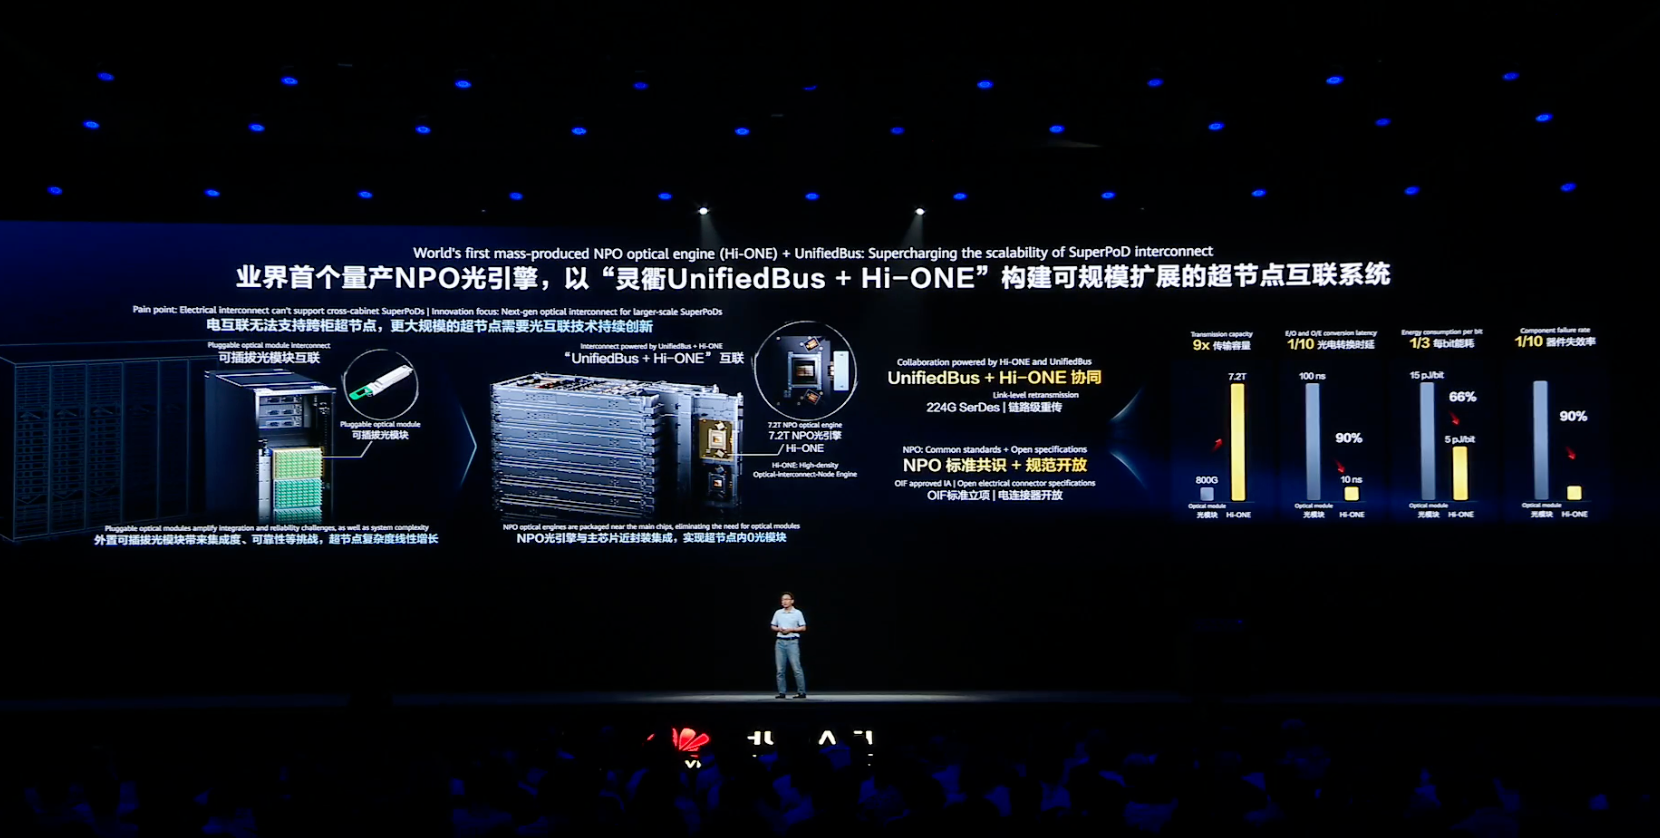
电互联无法支持跨柜超节点,更大规模的超节点需要光互联技术持续创新。
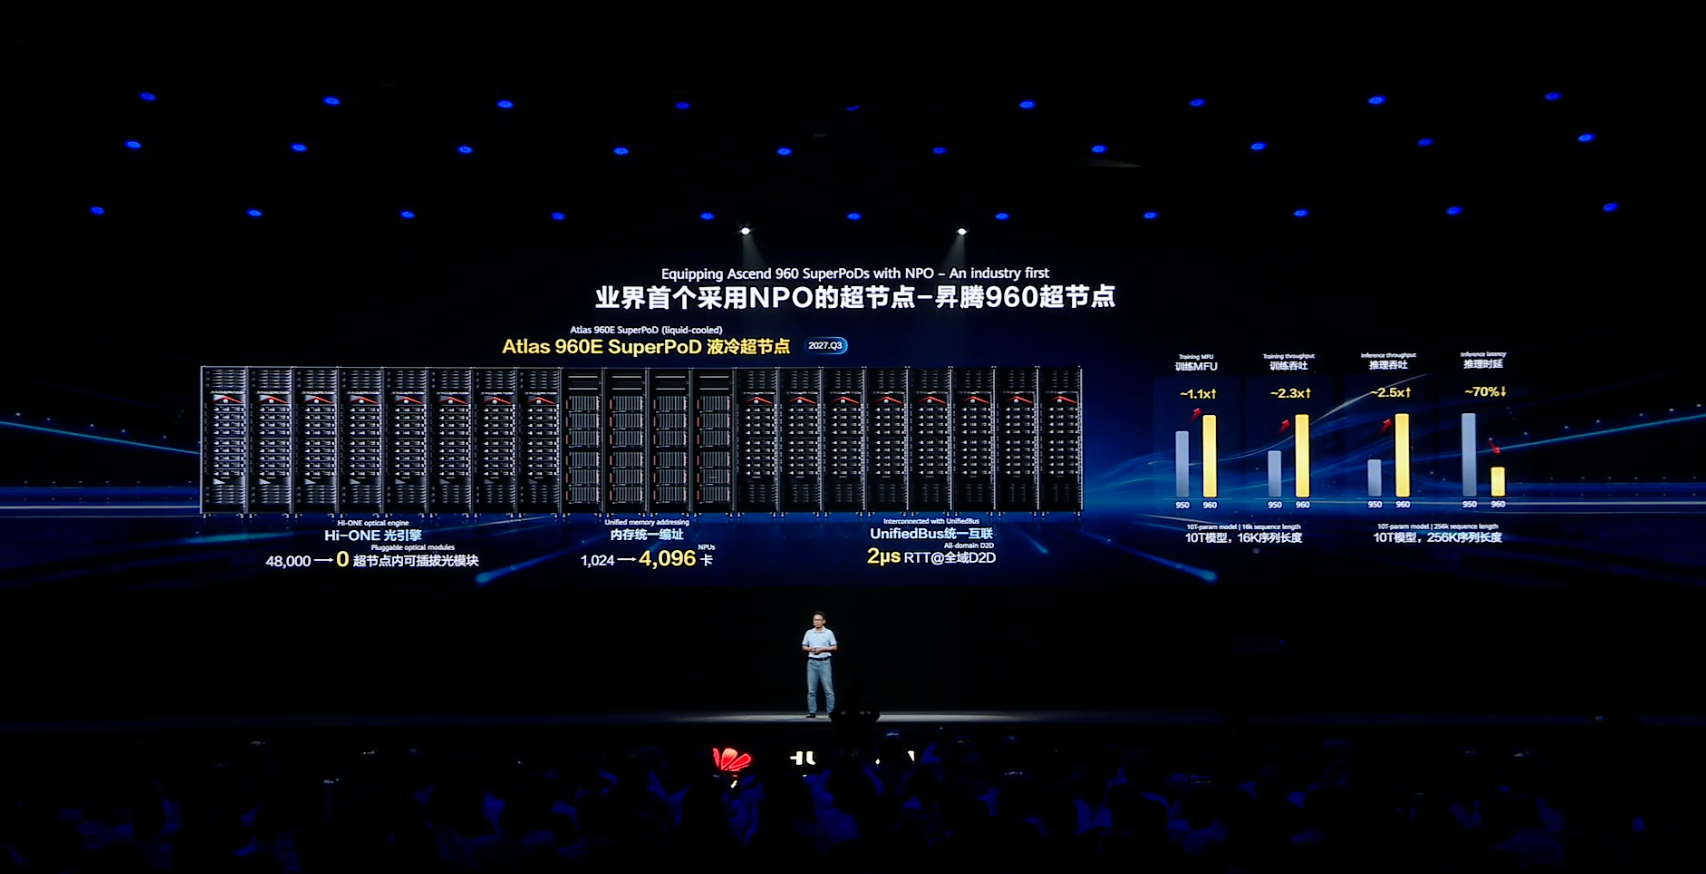
为此,华为今日宣布推出业界首个量产NPO(近封装光学)光引擎——Hi-ONE,以“灵衢UnifiedBus+Hi-ONE”构建可规模扩展的超节点互联系统。
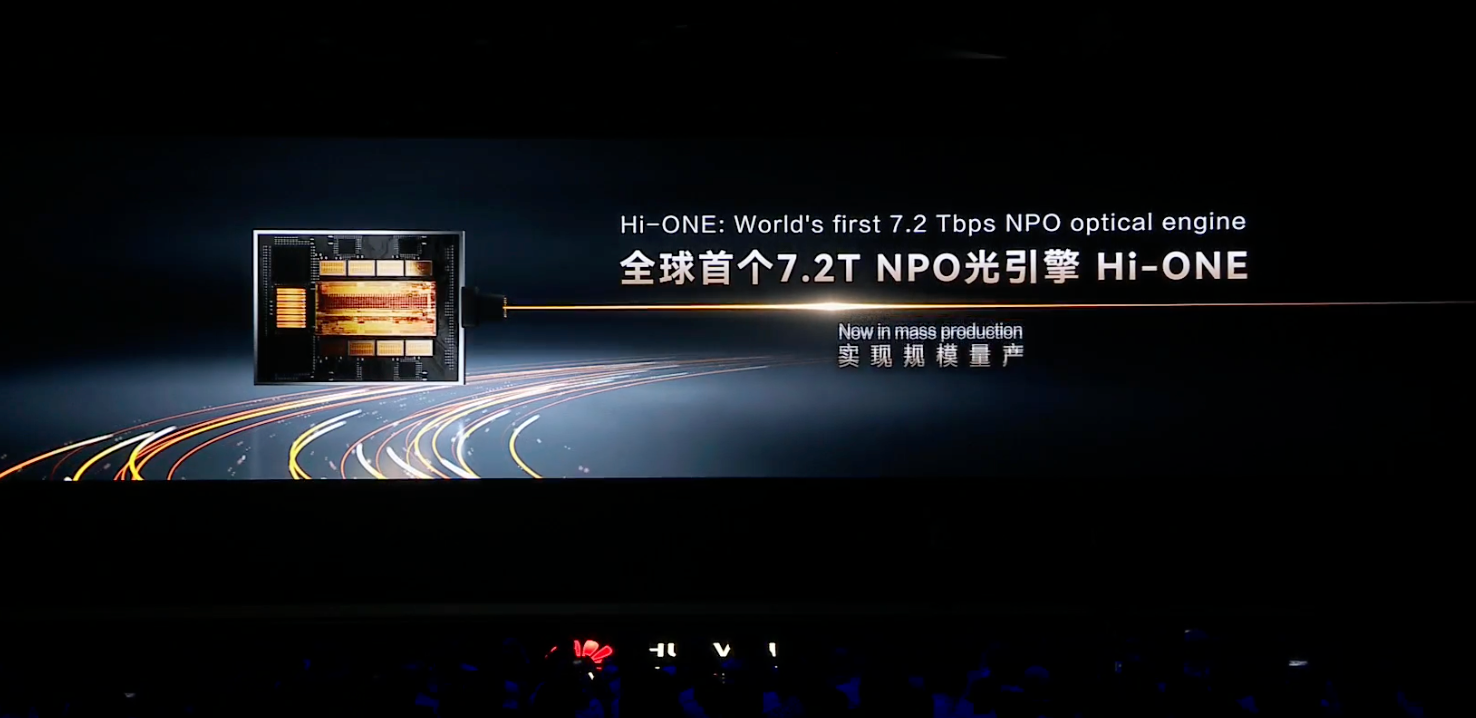
汪涛宣布,全球首个7.2Tbps NPO光引擎Hi-ONE实现规模量产,这是业界首个量产的NPO产品,是目前行业最大传输能力的NPO产品,也是唯一实现内置光源的NPO产品,它能把高带宽、高可靠、低时延和低功耗完美的融为一体。
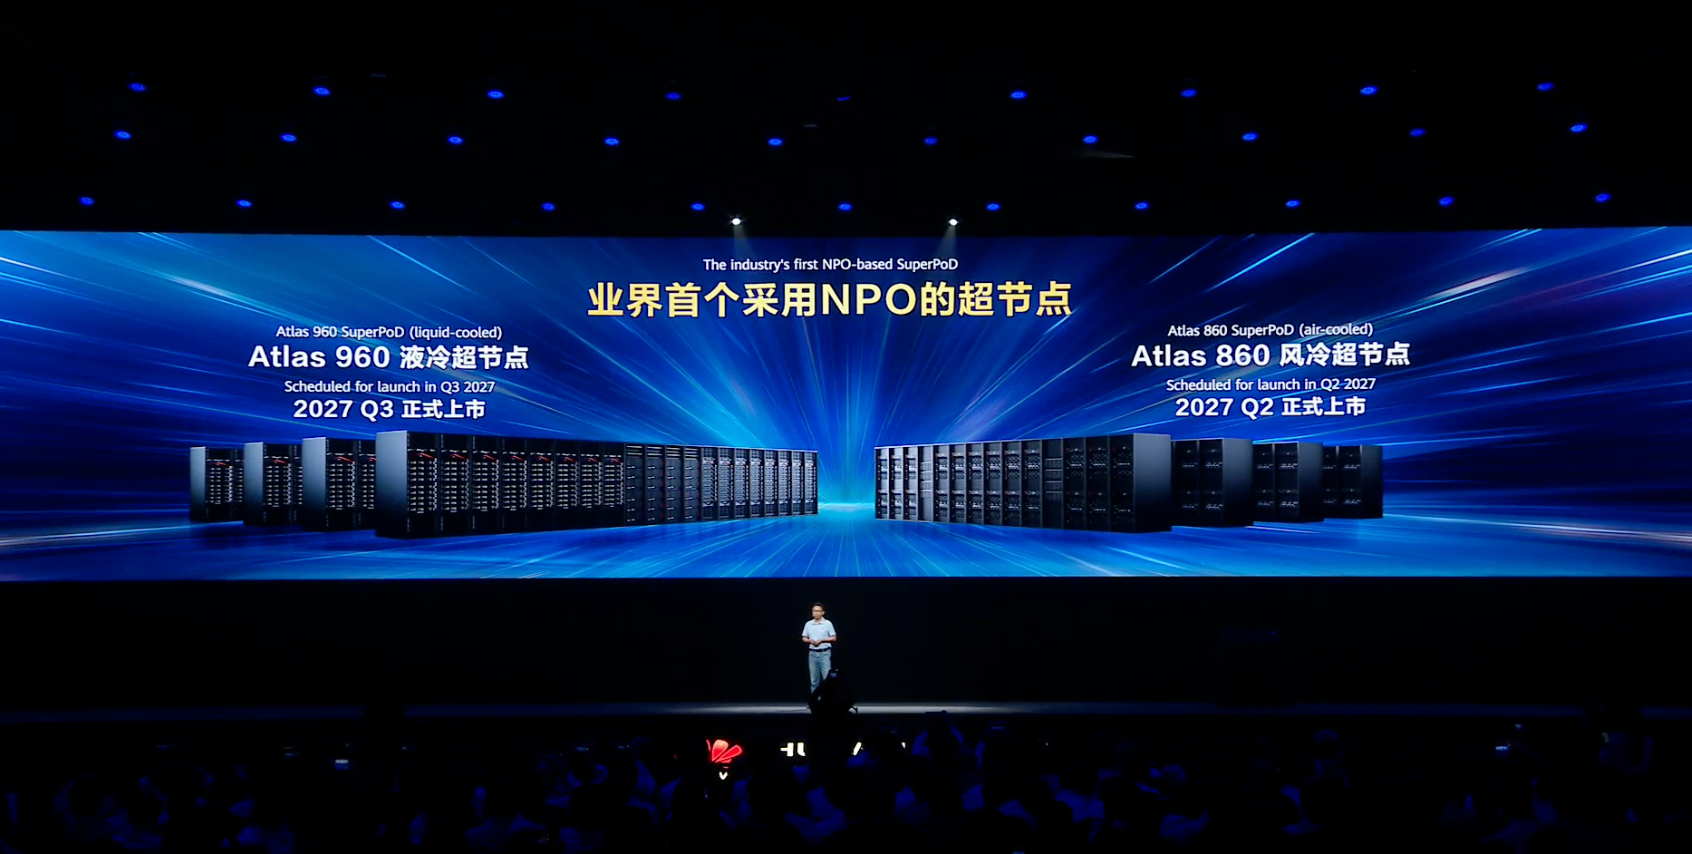
今日,华为还正式推出业界首个采用NPO的超节点——昇腾960超节点。
单个昇腾960超节点可实现4096卡规模,最大可提供8 EFLOPS FP8的算力,实现高达1PB的HBM容量,系统无故障运行的时间提升1倍,系统可用度可以达到99.8%。昇腾960风冷超节点和液冷超节点分别将于2027年Q2和Q3上市。
3、鲲鹏超节点:4096节点、256TB统一内存池,Agent启动快30倍
海量Agent并发与交互,需要通算超节点,为此华为鲲鹏超节点全新升级。
随着Agent应用的深入,智算系统中CPU和NPU的计算负荷发生了较大的变化。一方面,多Agent交互需要秒级启动、数十万个沙箱,需要毫秒级的沙箱拉起的速度。同时多Agent的海量信息检索也需要与之匹配的向量检索性能,单服务器需要数十万的TPS(每秒事务处理数)。
为此,华为将超节点的架构引入了通算系统,通过超节点的内存统一编制,把多台通用算力的服务器的内存形成一个统一的共享内存池,可以显著提升Agent沙箱启动的速度和提升Agent向量检索的性能,并提升整个AI Infer的资源利用效率。
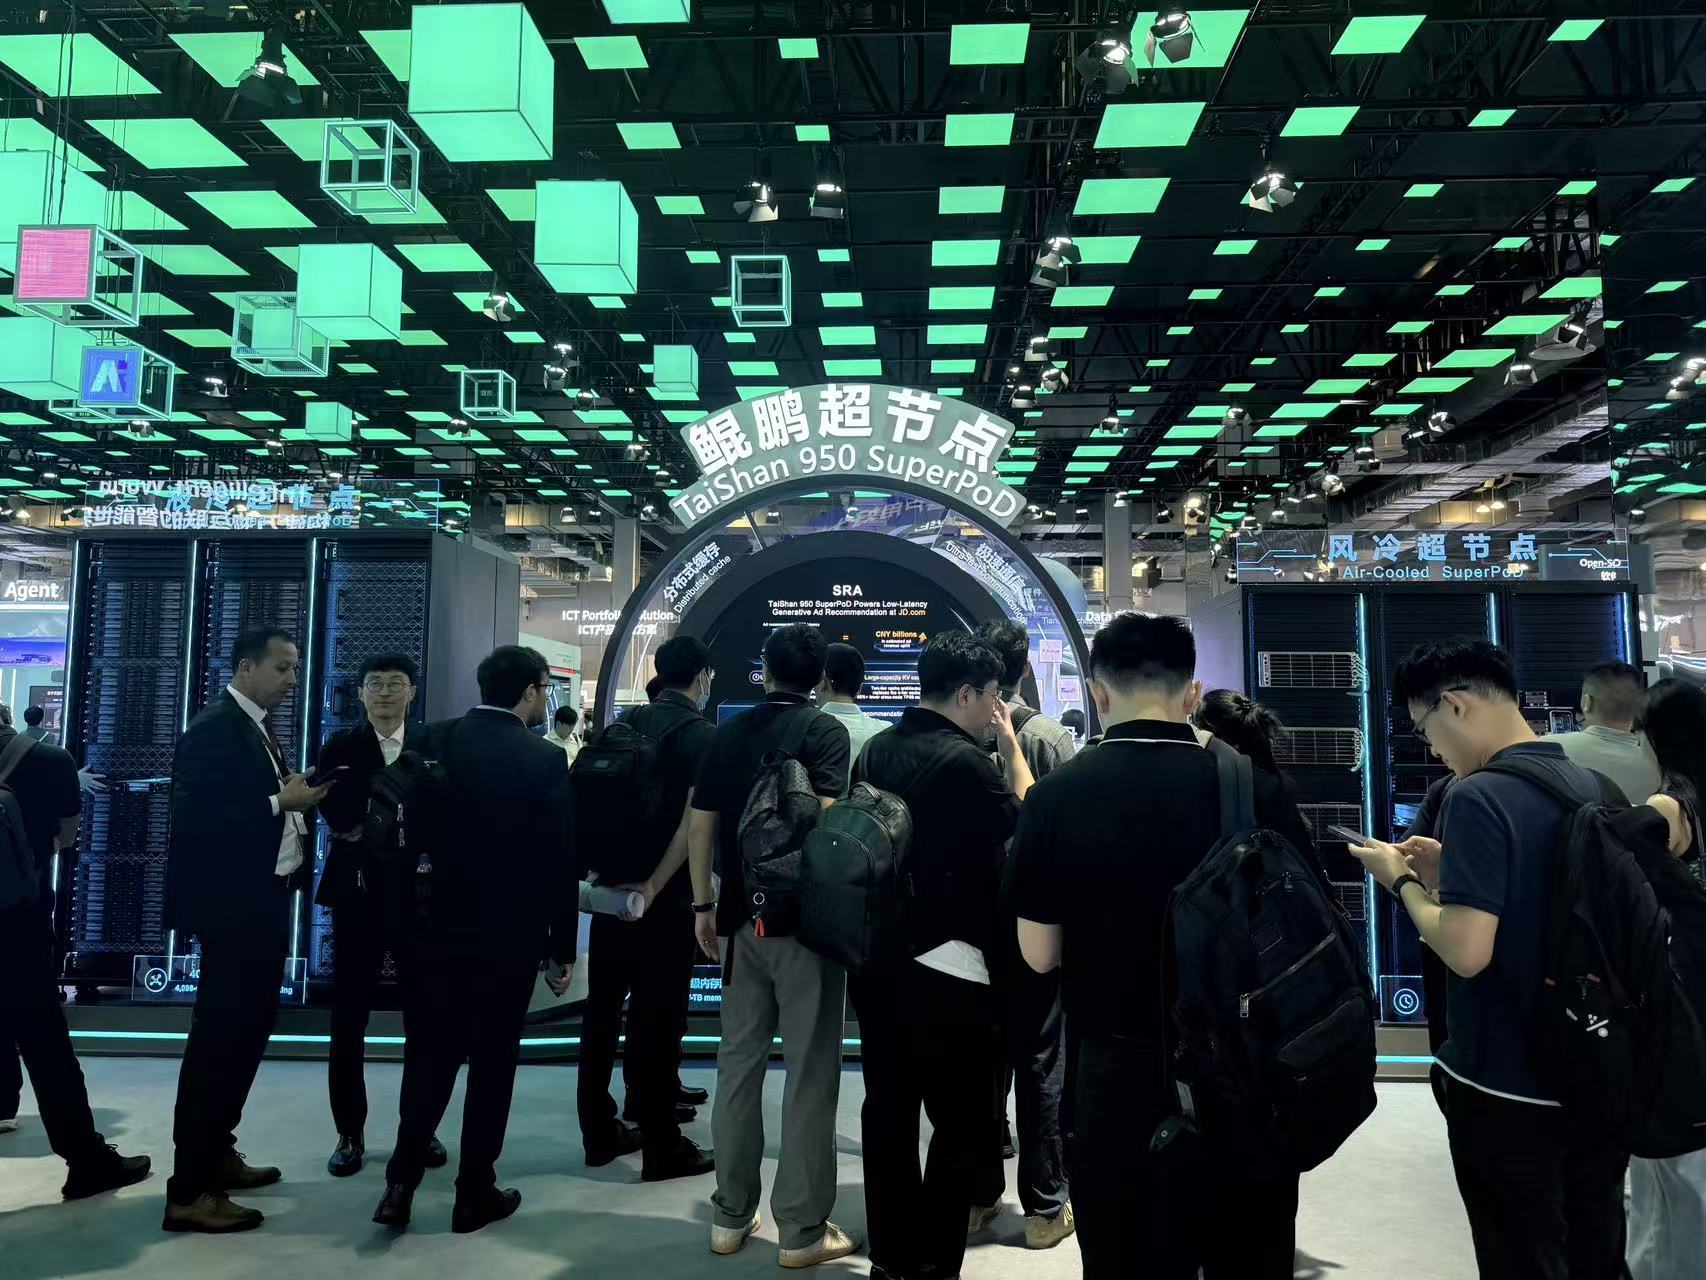
去年,华为发布了全球首个通算超节点——泰山950 SuperPoD,很多客户进行了规模部署。今天,鲲鹏超节点将全面升级,基于灵衢,最大支持4096节点,形成高达256TB的统一内存池。
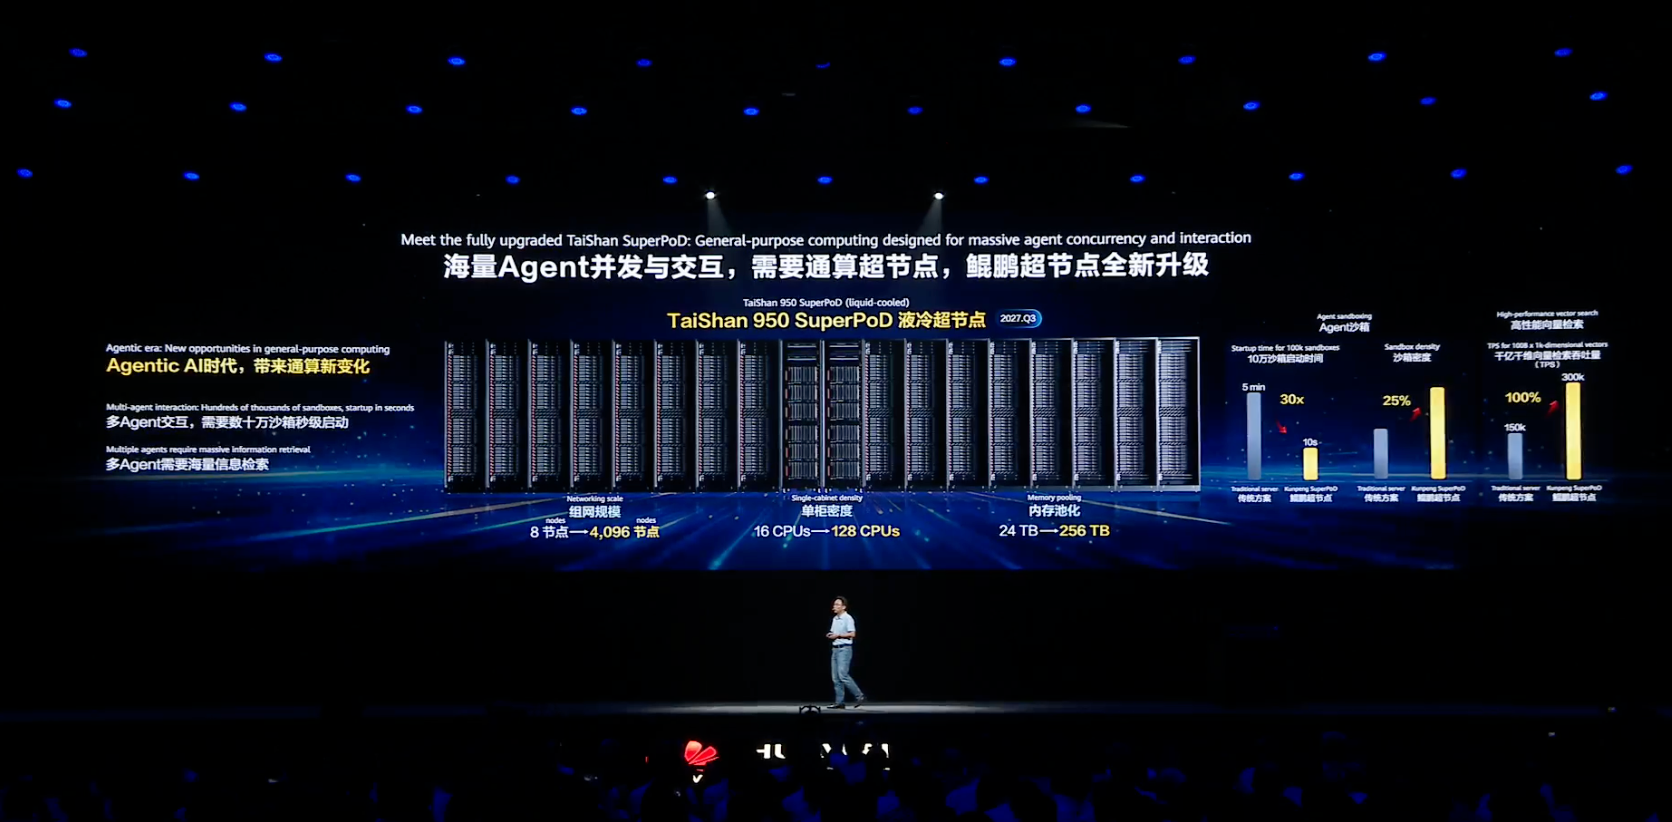
鲲鹏超节点可显著加速Agent的性能。10万级别的沙箱启动,相比传统服务器方案提升30倍,沙箱密度进一步提升25%;在复杂的向量检索场景下,实现检索效率比传统服务器性能倍增,达到30万TPS。
4、推出AI记忆存储方案,KV Cache时延降超50%
Agent与长序列需要多层次KV Cache架构,华为基于灵衢打造了AI记忆存储OceanStor M900。
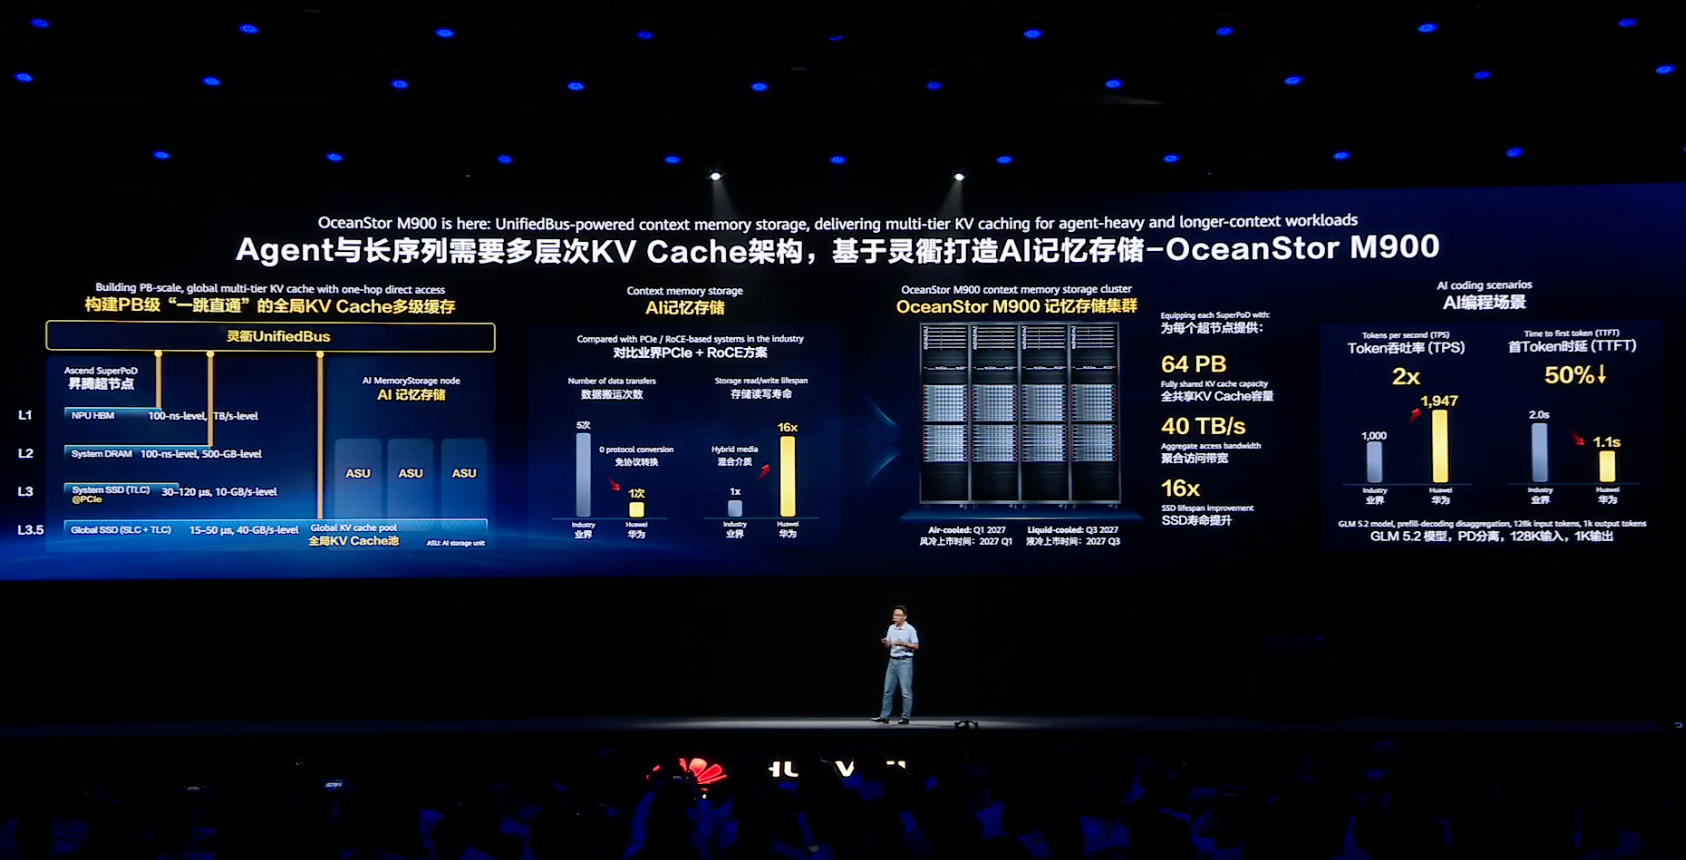
华为OceanStor M900搭载灵衢UnifiedBus总线,支持直连华为L3.5层的PB级KV Cache解决方案。业界通常采用是PCIe加RoCE互联的L3.5层的存储系统,其GPU或NPU访问SSD池需要5次数据搬运,华为的OceanStor M900只需要1次数据搬运,I/O时延和首token时延可降低超过50%。
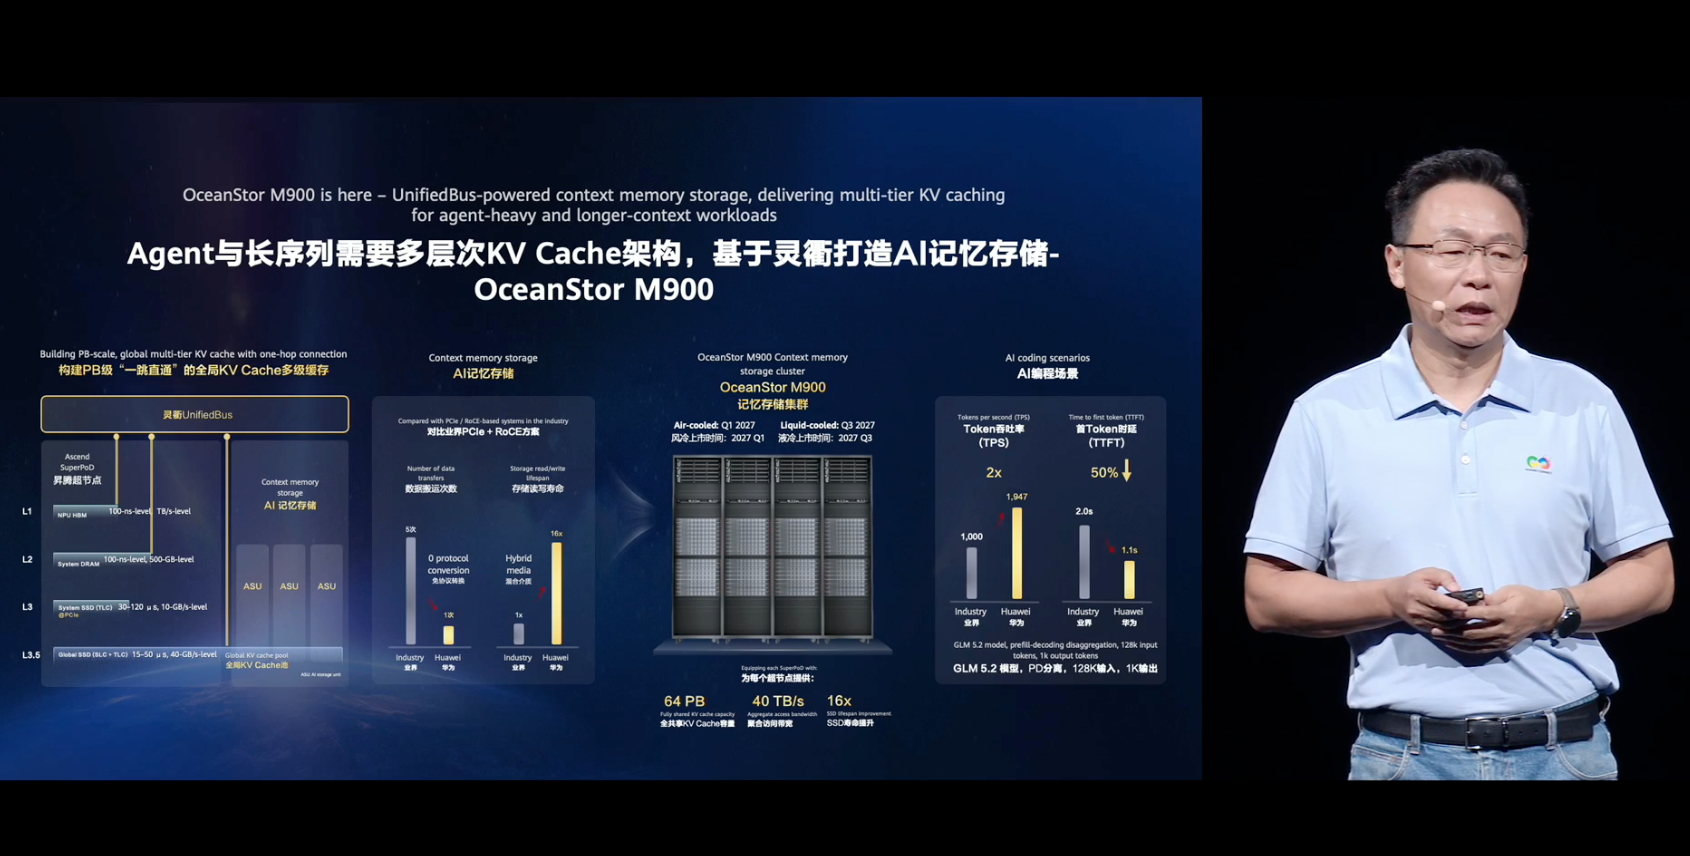
同时华为的OceanStor M900可将SSD的读写寿命提升16倍,从底层来保障KV Cache的高命中率和常温可靠。
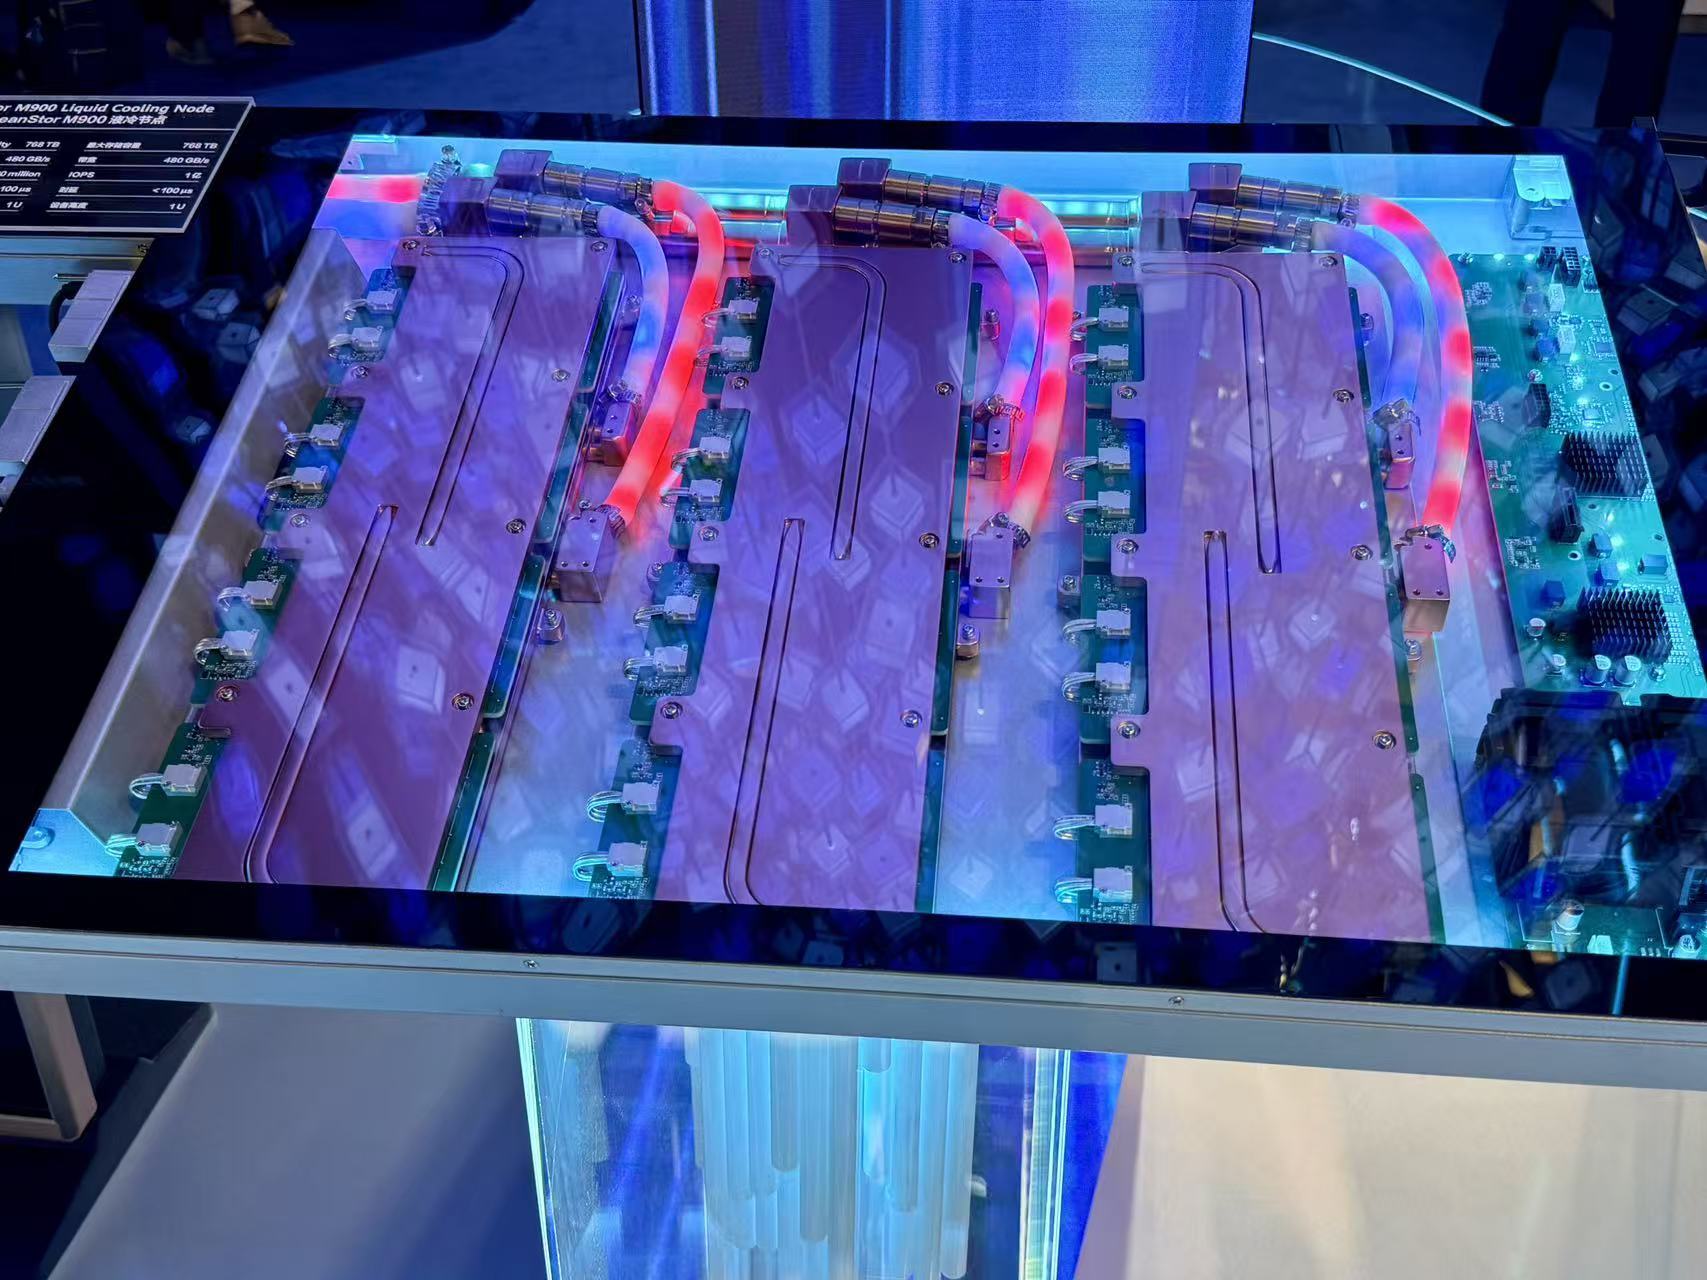
▲OceanStor M900液冷节点
5、灵衢+二层CLOS组网,华为打造100万卡超大规模集群
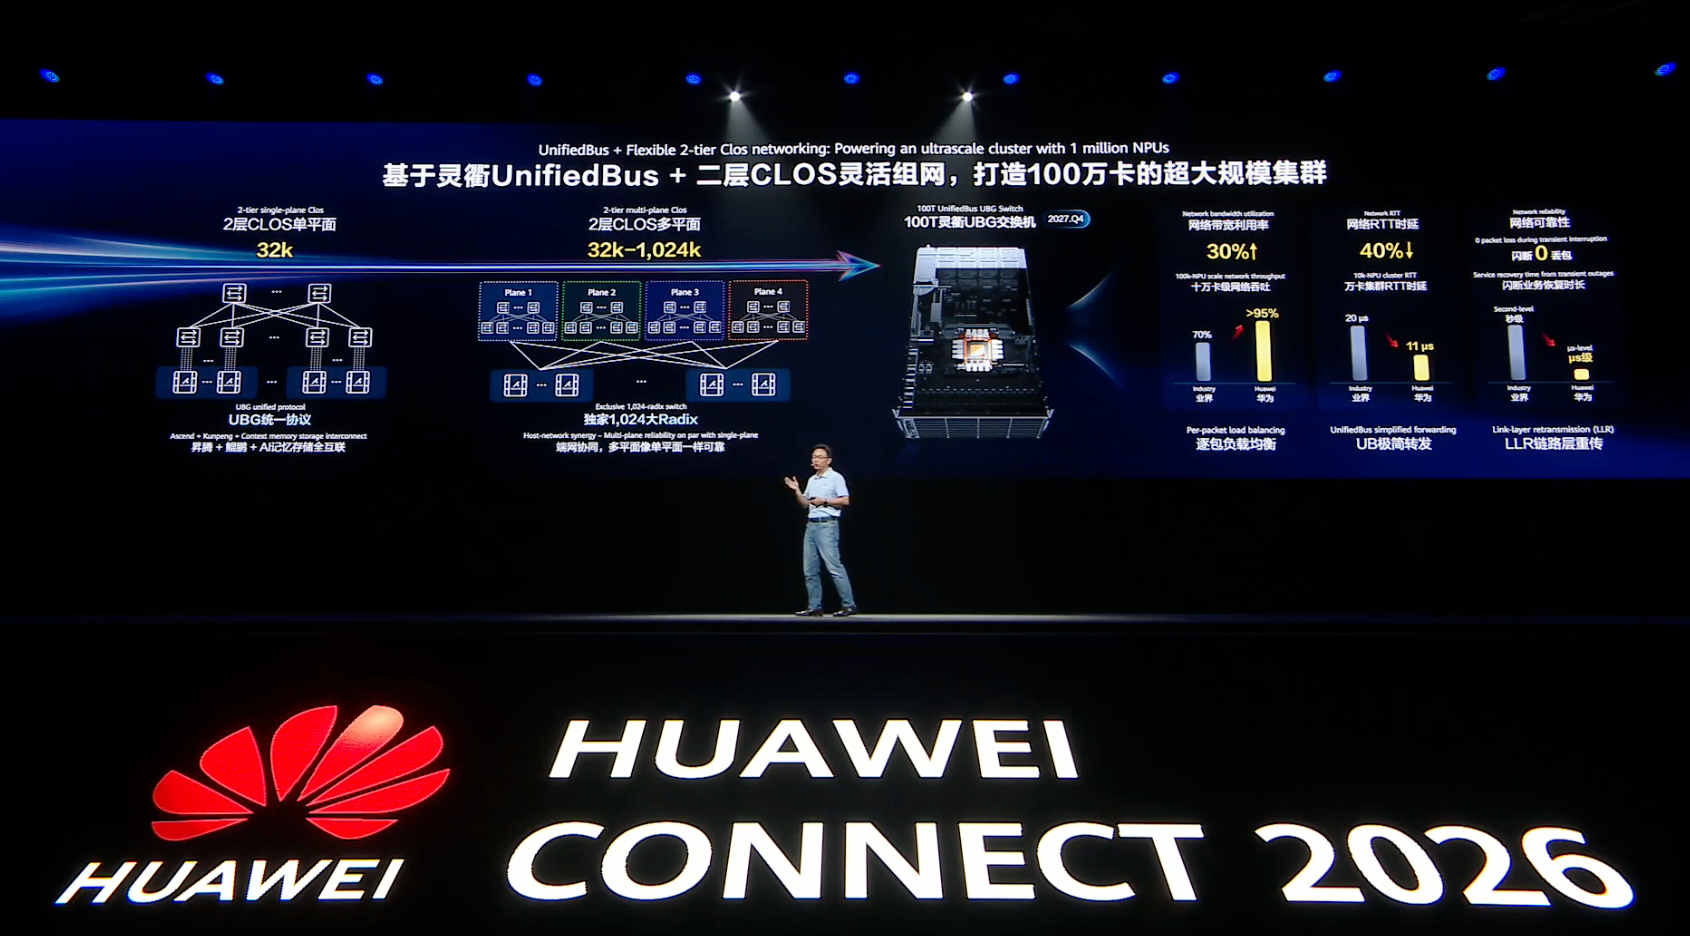
基于灵衢UnifiedBus+二层CLOS灵活组网,华为打造了100万卡的超大规模集群。
超节点集群是由多个超节点通过Scale out网络交换机互联形成的一个大的集群。昇腾960超节点最大规格为4096张NPU卡,多个NPU超节点通过华为的灵衢网络来连接在一起,能构建一个更大规模的超节点集群。
超节点集群支持多种组网模式:一是采用两层CLOS单平面组网,华为可以实现3.2万张昇腾960卡的高效互联。二是采用两层CLOS多平面组网,华为最大集群规模可达到51.2万张昇腾960。
华为要发挥“计算+通信”综合优势,打造Agentic时代的超节点集群,加速10万亿大模型训练和推理。
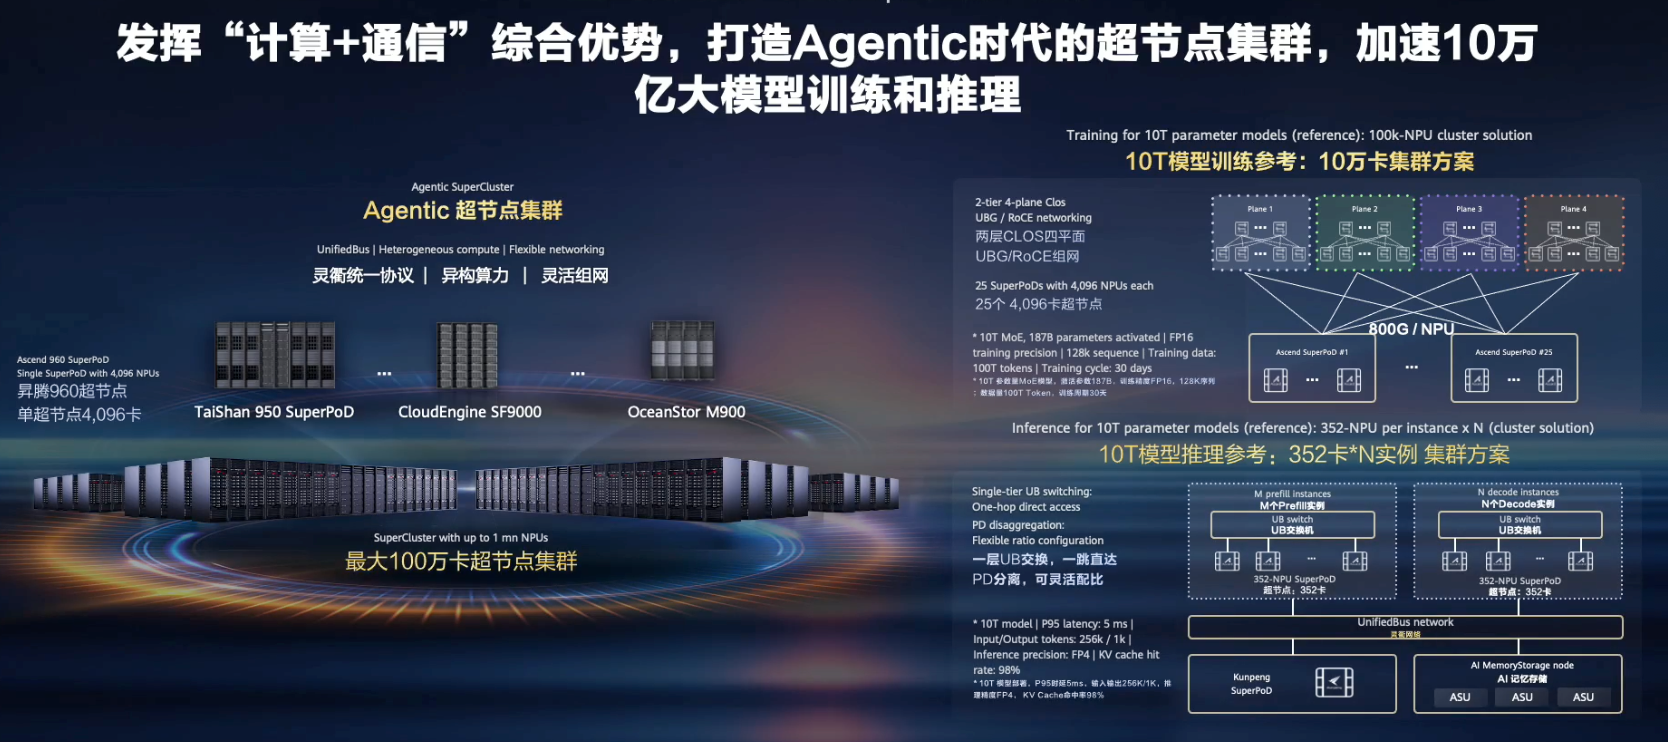
这样的超节点集群具备三大特征:
(1)以灵衢UnifiedBus来统一互联,把多种互联协议统一为灵衢协议,来大幅度减少协议的转换开销。
(2)它将昇腾超节点、鲲鹏超节点以及KV Cache等子系统对等互联。
(3)华为能提供多层次高带宽大容量的存储系统,且各类KV Cache均可一跳直达,来满足系统中各类热温冷的KV Cache需求,最大化来提升整个资源的利用效率。
二、四大举措推进AI入端、上车、进家,构筑新一代通信网络
轻量化终端,也会成为智能入口。
过去,传统的终端为用户提供单体功能。未来,AI将重构终端和人机的关系,围绕人来构建融合的智能空间。人和智能体要相互生,AI入端正在全面加速。
以手机为例,端侧模型的参数从2026年到2030年将实现10倍的这样的跃迁,从17B-30B将很快提升到70-100B,端侧的算力也有望从20-80Tops提升到180-200Tops。
华为将从四个方面来构建能力:
1、通过“麒麟+昇腾”组合,来实现端侧算力的自给自足。
2、通过“盘古+三方大模型”来实现端侧智能,好用易用。最近,华为在全新发布的华为Mate X2非凡大师上,首先商用了原生的盘古MoE全国产大模型,参数量为30B,激活参数为2B,主打智能、安全、快速。
3、HarmonyOS不仅是万物互联的操作系统,也将是智能无处不在的Agent OS,华为将从系统底层架构、运行机制、交互逻辑方面全面重构,来支撑Agent和人共生共用。
4、华为丰富的AI生态,是小艺系统智能体的枝繁叶茂的基础。
今年6月华为开发者大会上,华为发布了鸿蒙智能体框架,将全面开放北向应用和南向设备AI接入的能力。
华为将重点围绕智能手机、AI PC、车和家庭场景来打造四大端侧算力平台,通过端端算力的协同和端云算力的协同来,构筑分布式的群体智能,围绕个人移动空间、办公空间、车空间和家空间,提供一体的、连续的智能服务。
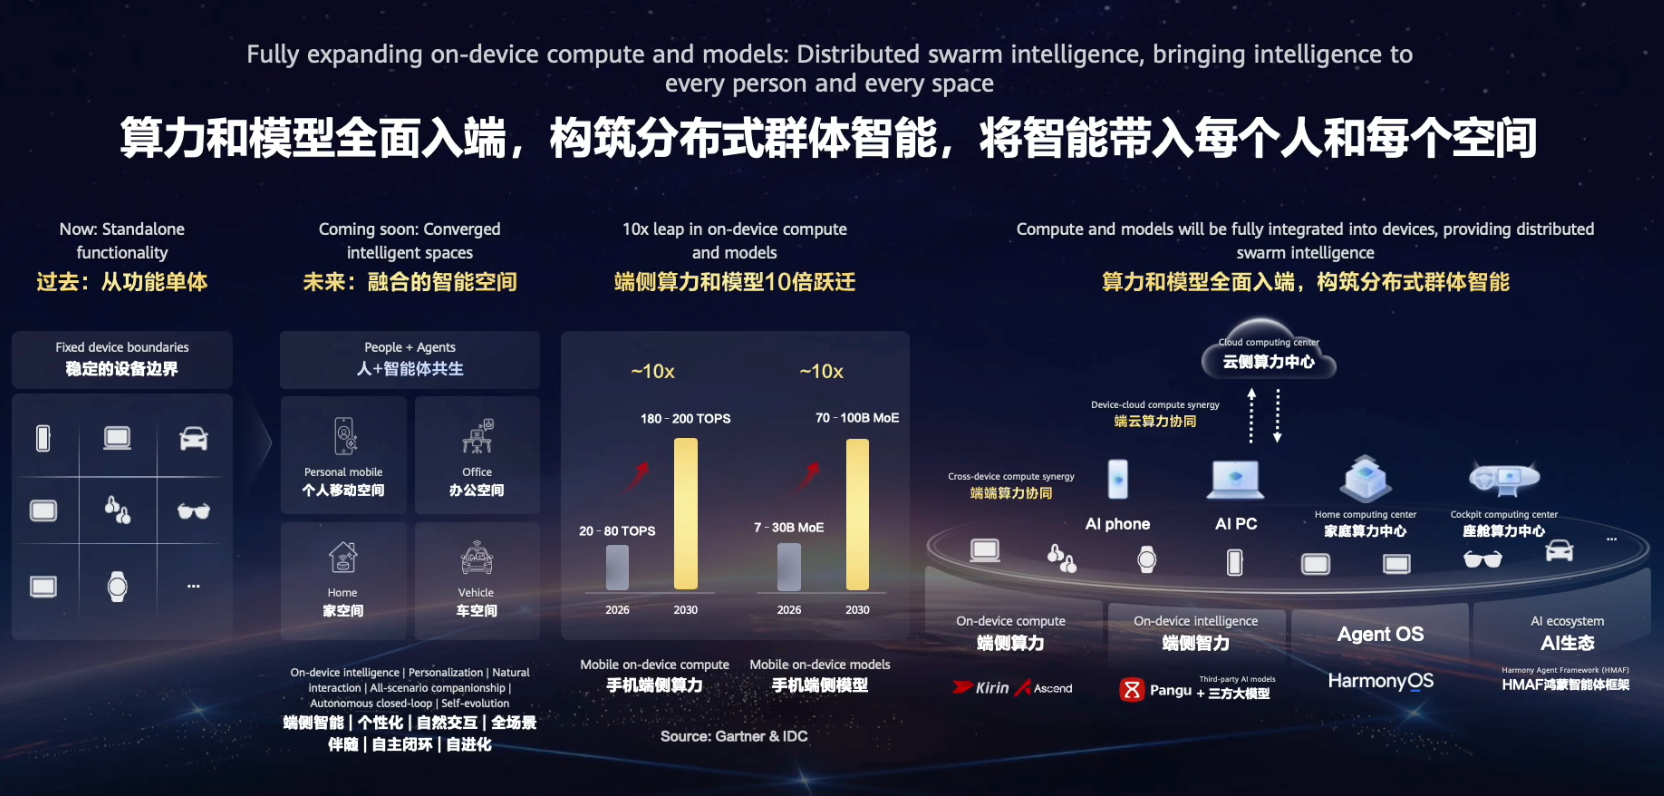
物联生态方面,开源鸿蒙生态规模已经超过13亿。汪涛称,AI Coding大幅提升了华为终端的开发效率,轻智能终端的时代已经来临。
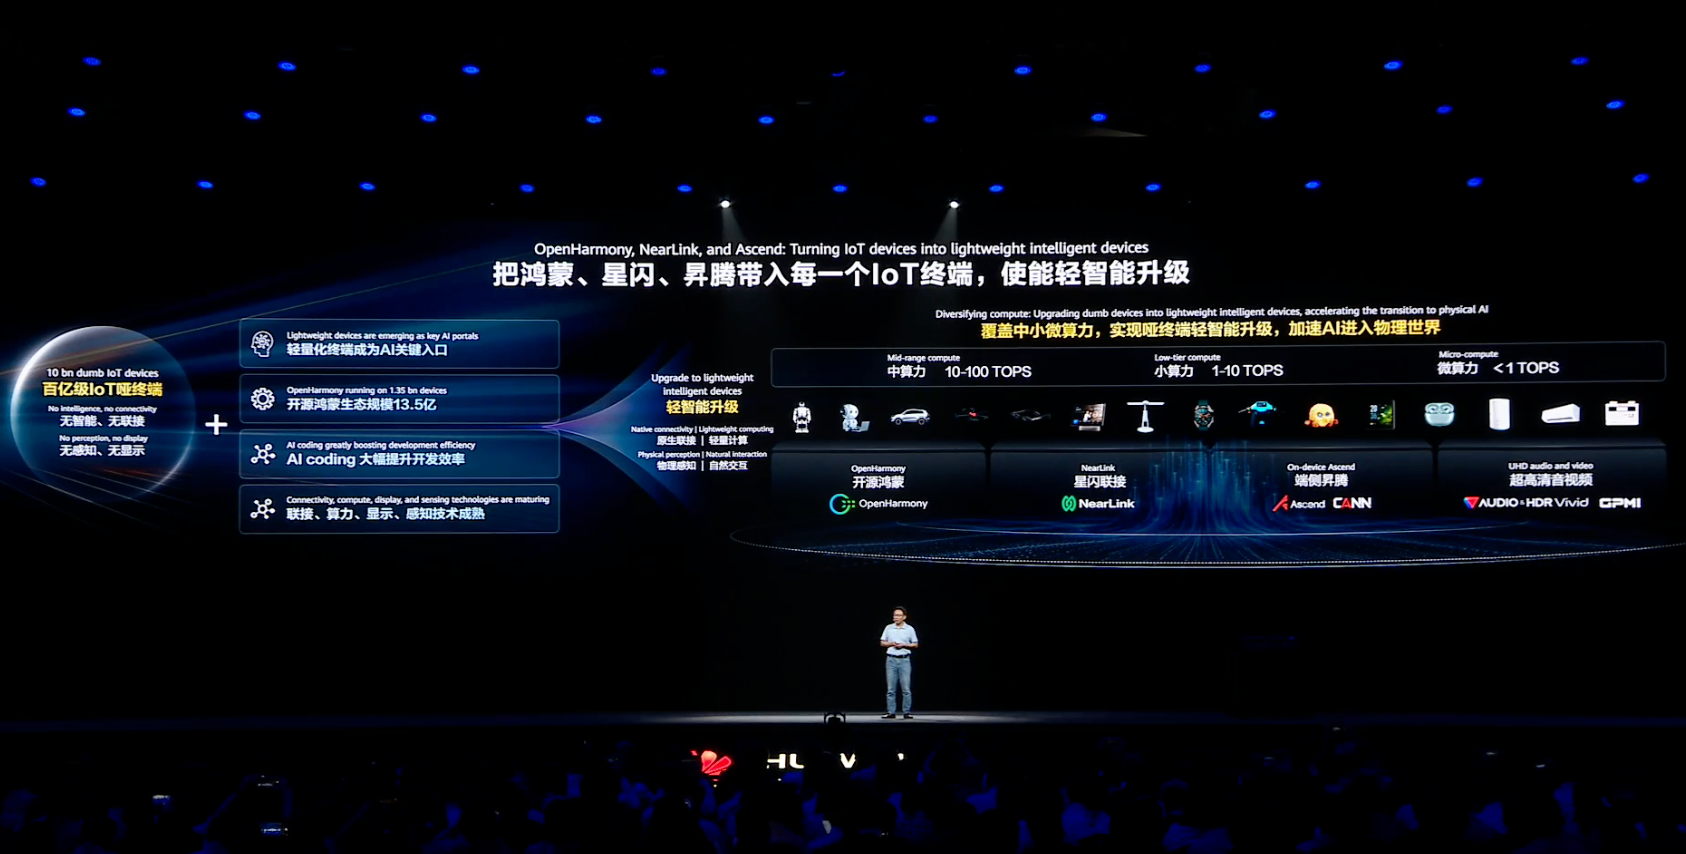
围绕“用算”,汪涛最后还提出构筑新一代通信网络,将算力连接在一起,最终形成硅基黑土地。
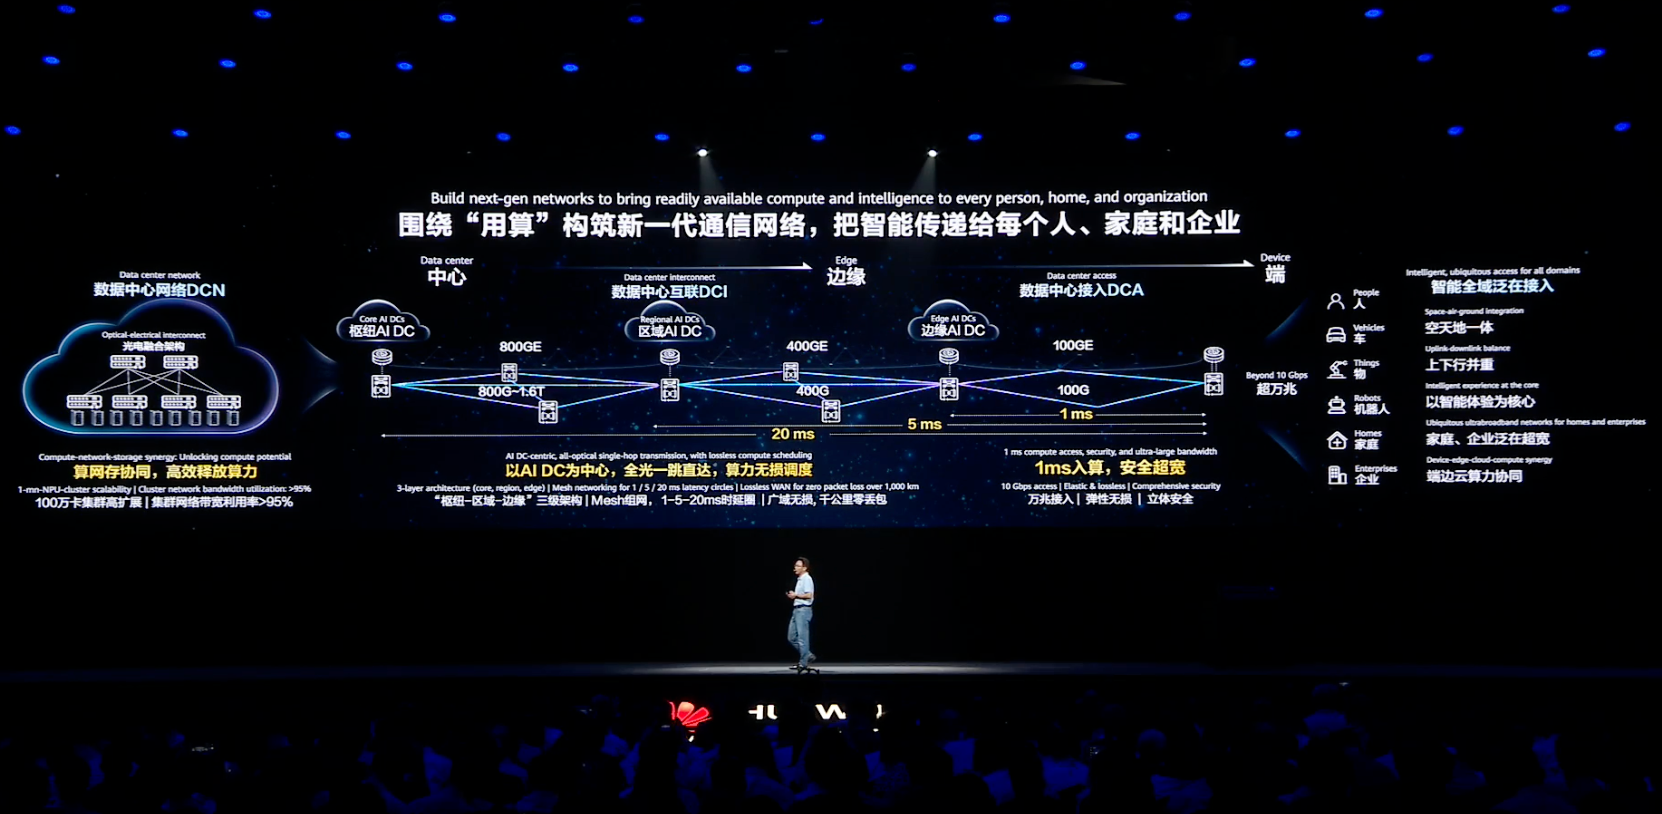
他提到。AI时代的通信网络将围绕运算,以及5G或6G、万兆光网等新兴通讯技术,从中心到边缘、再到终端,面向不同用户按需提供网络的连接能力,保障智能触达每一个人、家庭和企业。
三、华为鲲鹏开发者超416万,昇腾跨越生态拐点,私有云公有云兼顾
构建开源开放的算力生态,是华为的核心战略。
汪涛宣布,截至目前,华为鲲鹏生态全球开发者超过了416万,全球生态合作伙伴超过了7200家,支持了560多个全球的开源项目。openEuler(欧拉)的装机量也超过了2000万套,成为中国服务器操作系统市场份额第一。
同时,华为昇腾已经跨越生态拐点。CANN已成为中国最活跃的AI开源社区,社区月活开发者突破了5000多名,外部开发者首次超越了内部开发者,占总开发者数量的61%;基于昇腾的原生训练模型已超过40个。
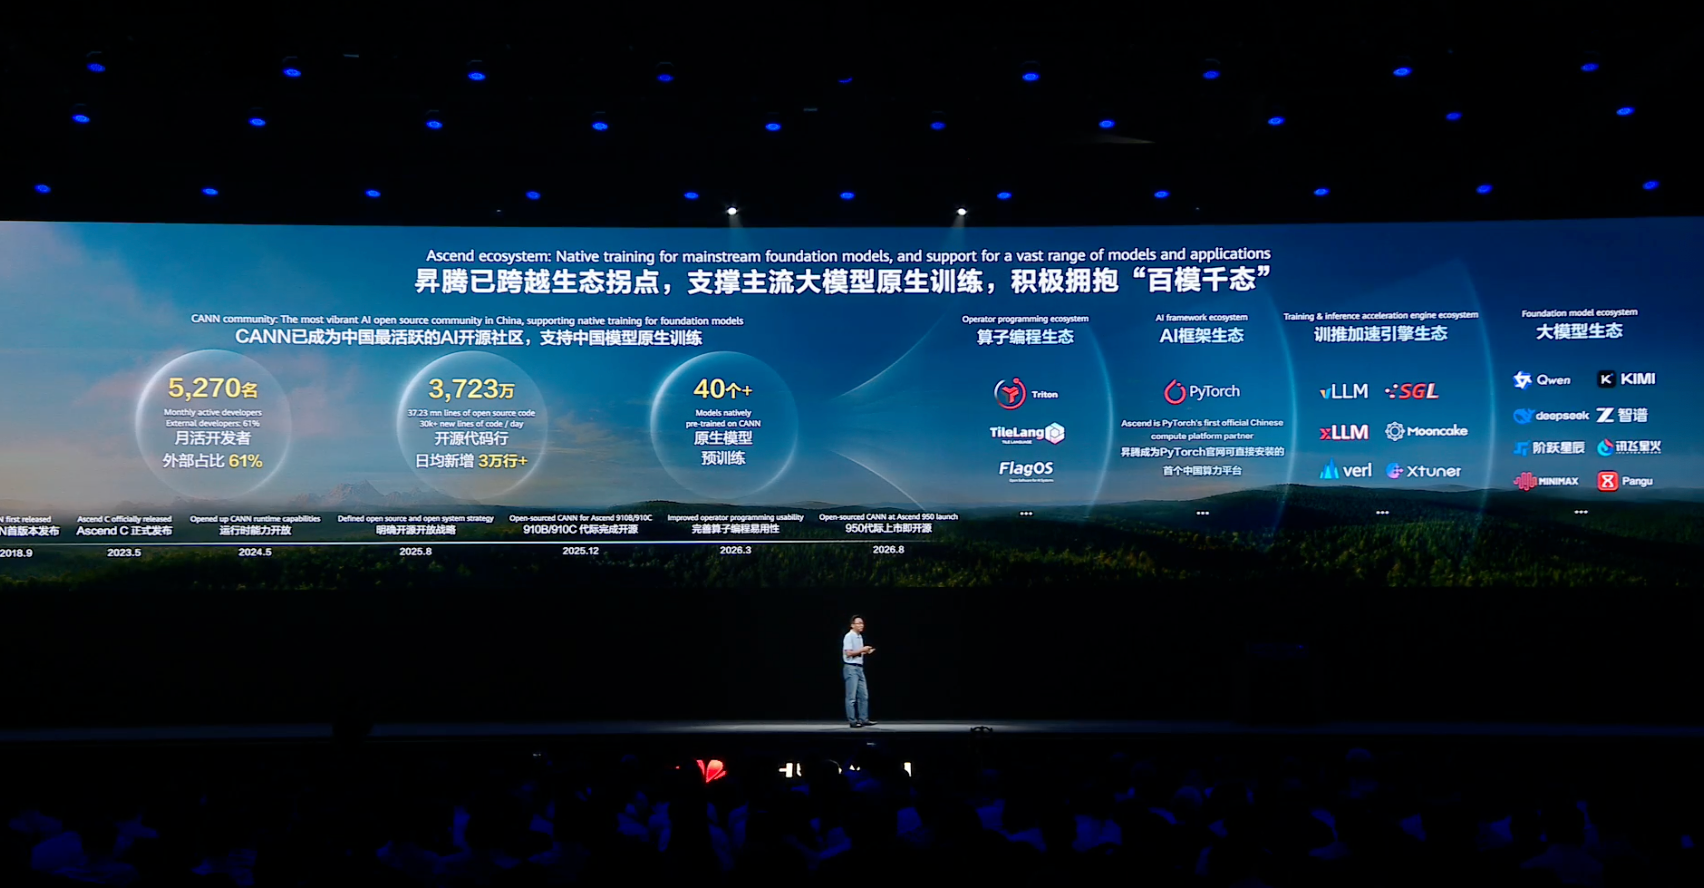
其生态已经覆盖了90多个主流的三方社区,如PyTorch、Triton、vLLM、VRR等,在Linux基金会的大力支持下,昇腾已经成为继英伟达、AMD和英特尔之后,在PyTorch官网上可以直接安装的算力平台。
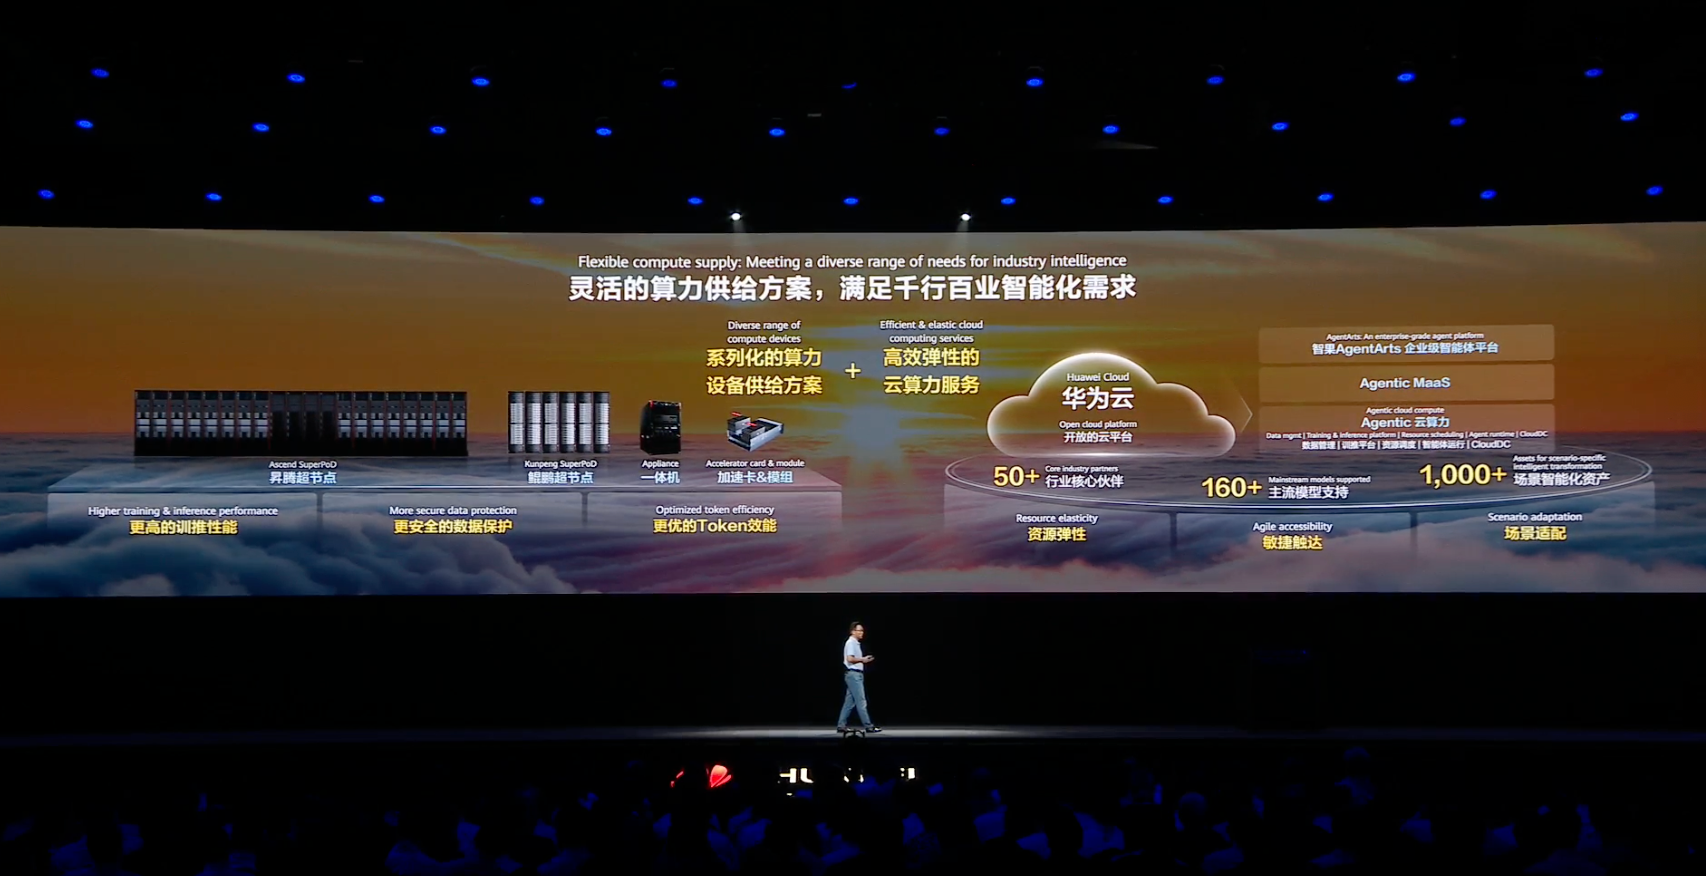
当前AI算力仍处于供不应求的状态,如何提升算力利用率,是AI产业发展我们面临的共同的挑战。不同的应用场景、不同的创新模式、不同的智能化阶段,对算力供给的模式提出了多样性的需求。
汪涛称,华为面向千行百业打造硅基黑土地,通过算力基础设施和云服务两种方式,也就是两套核心能力,以灵活的算力供给来满足客户的智能化需求。
结语:灵衢破墙,华为要重做Agent时代的算力底座
从灵衢打破通信墙,到11颗芯片撑起超节点,再到百万卡集群与开源生态跨越拐点,华为正以“计算+通信”的垂直整合能力,为10万亿级大模型时代构筑算力底座。
当算力供给从“卖卡”走向“卖集群”、从“硬件变现”走向“生态共赢”,AI基础设施的竞争已升维为体系化能力的较量。华为的硅基黑土地,正试图为智能世界提供另一种坚实选择。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”