英伟达展示DSX MaxLPS技术,AI工厂每兆瓦token吞吐量最高提升40%



IT之家 9 月 17 日消息,科技媒体 Wccftech 昨日(9 月 16 日)发布博文,报道称在 AI 基础设施峰会上,英伟达展示了面向 AI 工厂的 DSX MaxLPS 功耗调度系统,每兆瓦 token 吞吐量最高提升 40%。
IT之家注:每兆瓦 token 吞吐量是指数据中心每消耗 1 MW 电力时,AI 系统每秒能够生成或处理多少个 token。该指标把功耗纳入计算,因此更适合衡量 AI 数据中心在电力受限条件下的产出能力。
英伟达 DSX MaxLPS 技术已由 Emerald AI 集成至 Conductor 平台,用于电网条件下的数据中心负载编排。
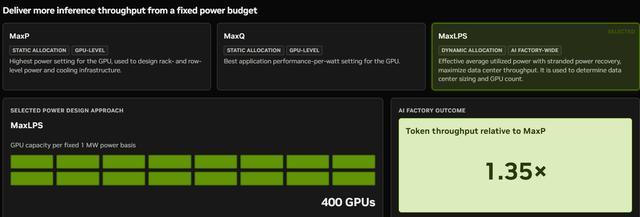
Conductor AI 平台中的 DSX Flex 可依据电网状态动态调整数据中心用电需求。平台已接收 200 次电网状态信号,相关操作均未要求用户干预。Lambda 等云服务商测试后,在固定功率预算下取得 24% 的 token 吞吐量提升。
Lambda 是一家 GPU 云服务商,客户数量超过 10,000 家。测试集群包含 5 个机架和 19 个节点。在与 16 个节点满功率运行相同的功率预算下,19 个节点的集群吞吐量从约每秒 400 万个 token 提升至每秒 500 万个,增幅为 24%,每瓦性能提升 23%。
NVIDIA 还披露,Vera Rubin 和 Groq 3 LPX 机架在相同站点功耗范围内,GPU 数量最多可增加 40%。在不新增电力线路的条件下,token 吞吐量最多可提升 35%。在 100K 上下文、Qwen 3.8 27B 工作负载中,Groq 3 LPX 达到每位用户每秒 2,529 个输出 token。
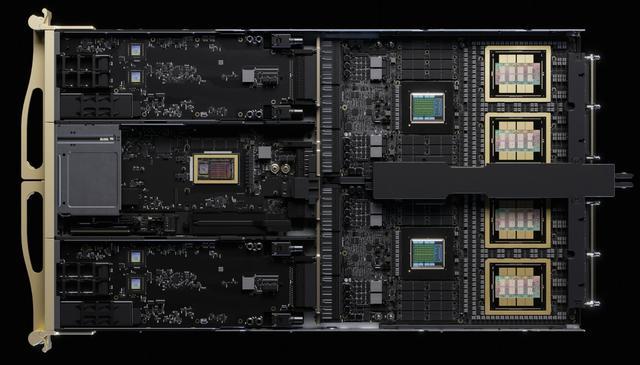
多家人工智能企业已参与早期测试 Vera CPU,相关结果显示性能最高提升 1.9 倍、吞吐量提升 73%、查询任务吞吐量提升 3.3 倍。
Perplexity 测得 SPACE 安全沙箱启动速度提升 1.9 倍,DeepInfra 测得编排步骤延迟速度提升 2.2 倍。
Redpanda 的测试显示,Vera CPU 相比其他 CPU 延迟降低 5.5 倍,吞吐量提升 73%。Starburst 测得查询吞吐量提升 3 倍,Kinetica 测得分析查询性能提升 2.7 倍。
“特别声明:以上作品内容(包括在内的视频、图片或音频)为凤凰网旗下自媒体平台“大风号”用户上传并发布,本平台仅提供信息存储空间服务。
Notice: The content above (including the videos, pictures and audios if any) is uploaded and posted by the user of Dafeng Hao, which is a social media platform and merely provides information storage space services.”