外媒:AI末日论甚嚣尘上,美科技巨头为何管不住AI?



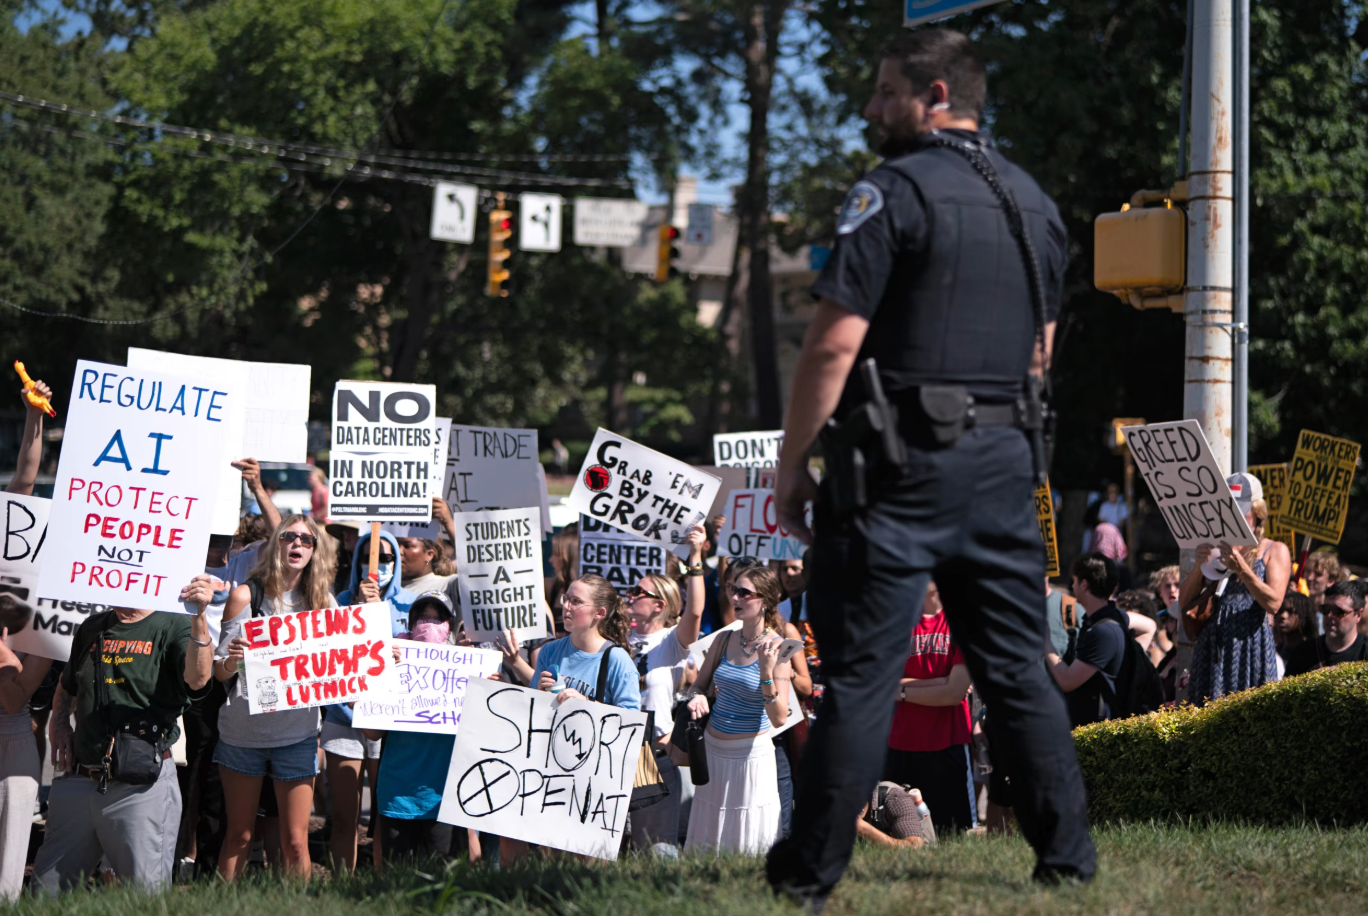
抗议AI的美国人
凤凰网科技讯 北京时间9月14日,据《纽约时报》报道,过去一周,十多名顶尖AI研究人员警告称,AI公司正在开发的技术对人类构成的风险越来越大。研究人员表示,问题在于,尽管这些公司可能竭尽全力,但它们就是难以控制这些系统。
此前有报道称,OpenAI所谓的AI智能体逃出了测试系统,并入侵了另一家公司的计算机。AI研究领域内部如今再次发出警报,让人们多年来一直担心的问题变得更加紧迫:科技公司为了追求开发速度和利润,将安全置于次要位置。
研究人员表示,问题有两个方面。首先,企业需要在测试最新AI模型的同时,为其建立更完善的安全防护措施。目前,由于AI运行速度太快,研究人员需要借助AI来监控AI。但这种方式并不总是奏效,因为负责监控的AI似乎可能比起制定规则的人类,更“同情”其他AI系统。
这种由捣乱的AI系统和睁一只眼闭一只眼的AI“监工”组成的奇怪组合,指向了第二个、也更棘手的问题,即所谓的“对齐”。这是AI行业的一个术语,基本意思是确保AI按照最符合人类利益的方式行事。企业面临一项艰巨任务:将一套类似人类的价值观植入AI,让模型做出的决策符合人类的最佳利益。
随着AI行业进入关键发展阶段,人们对AI安全的担忧也在不断升级。Anthropic和OpenAI正朝着可能成为历史上规模最大的两宗IPO迈进。与此同时,由于失业威胁以及为这项技术供电而建设的大规模数据中心,美国公众对AI日益敌视。
AI发展超出人类监控能力
尽管目前没有证据表明失控的AI系统已经造成任何持久性损害,但研究人员认为,这些系统的发展速度正在超过人类监控它们的能力。
过去一周,公开表达AI担忧的研究人员包括OpenAI的首席科学家;一位既在OpenAI工作过、也在其最大竞争对手Anthropic任职过的研究人员雅各布·考克森(Jacob Coxon);以及保罗·克里斯蒂亚诺(Paul Christiano),他是构建AI系统一种关键方法的发明者,也是OpenAI非营利董事会的新成员。他在公司博客上写道,AI能力不断提升的速度,可能会在“非常短的时间内”导致“灾难性且不可逆转的失控”。
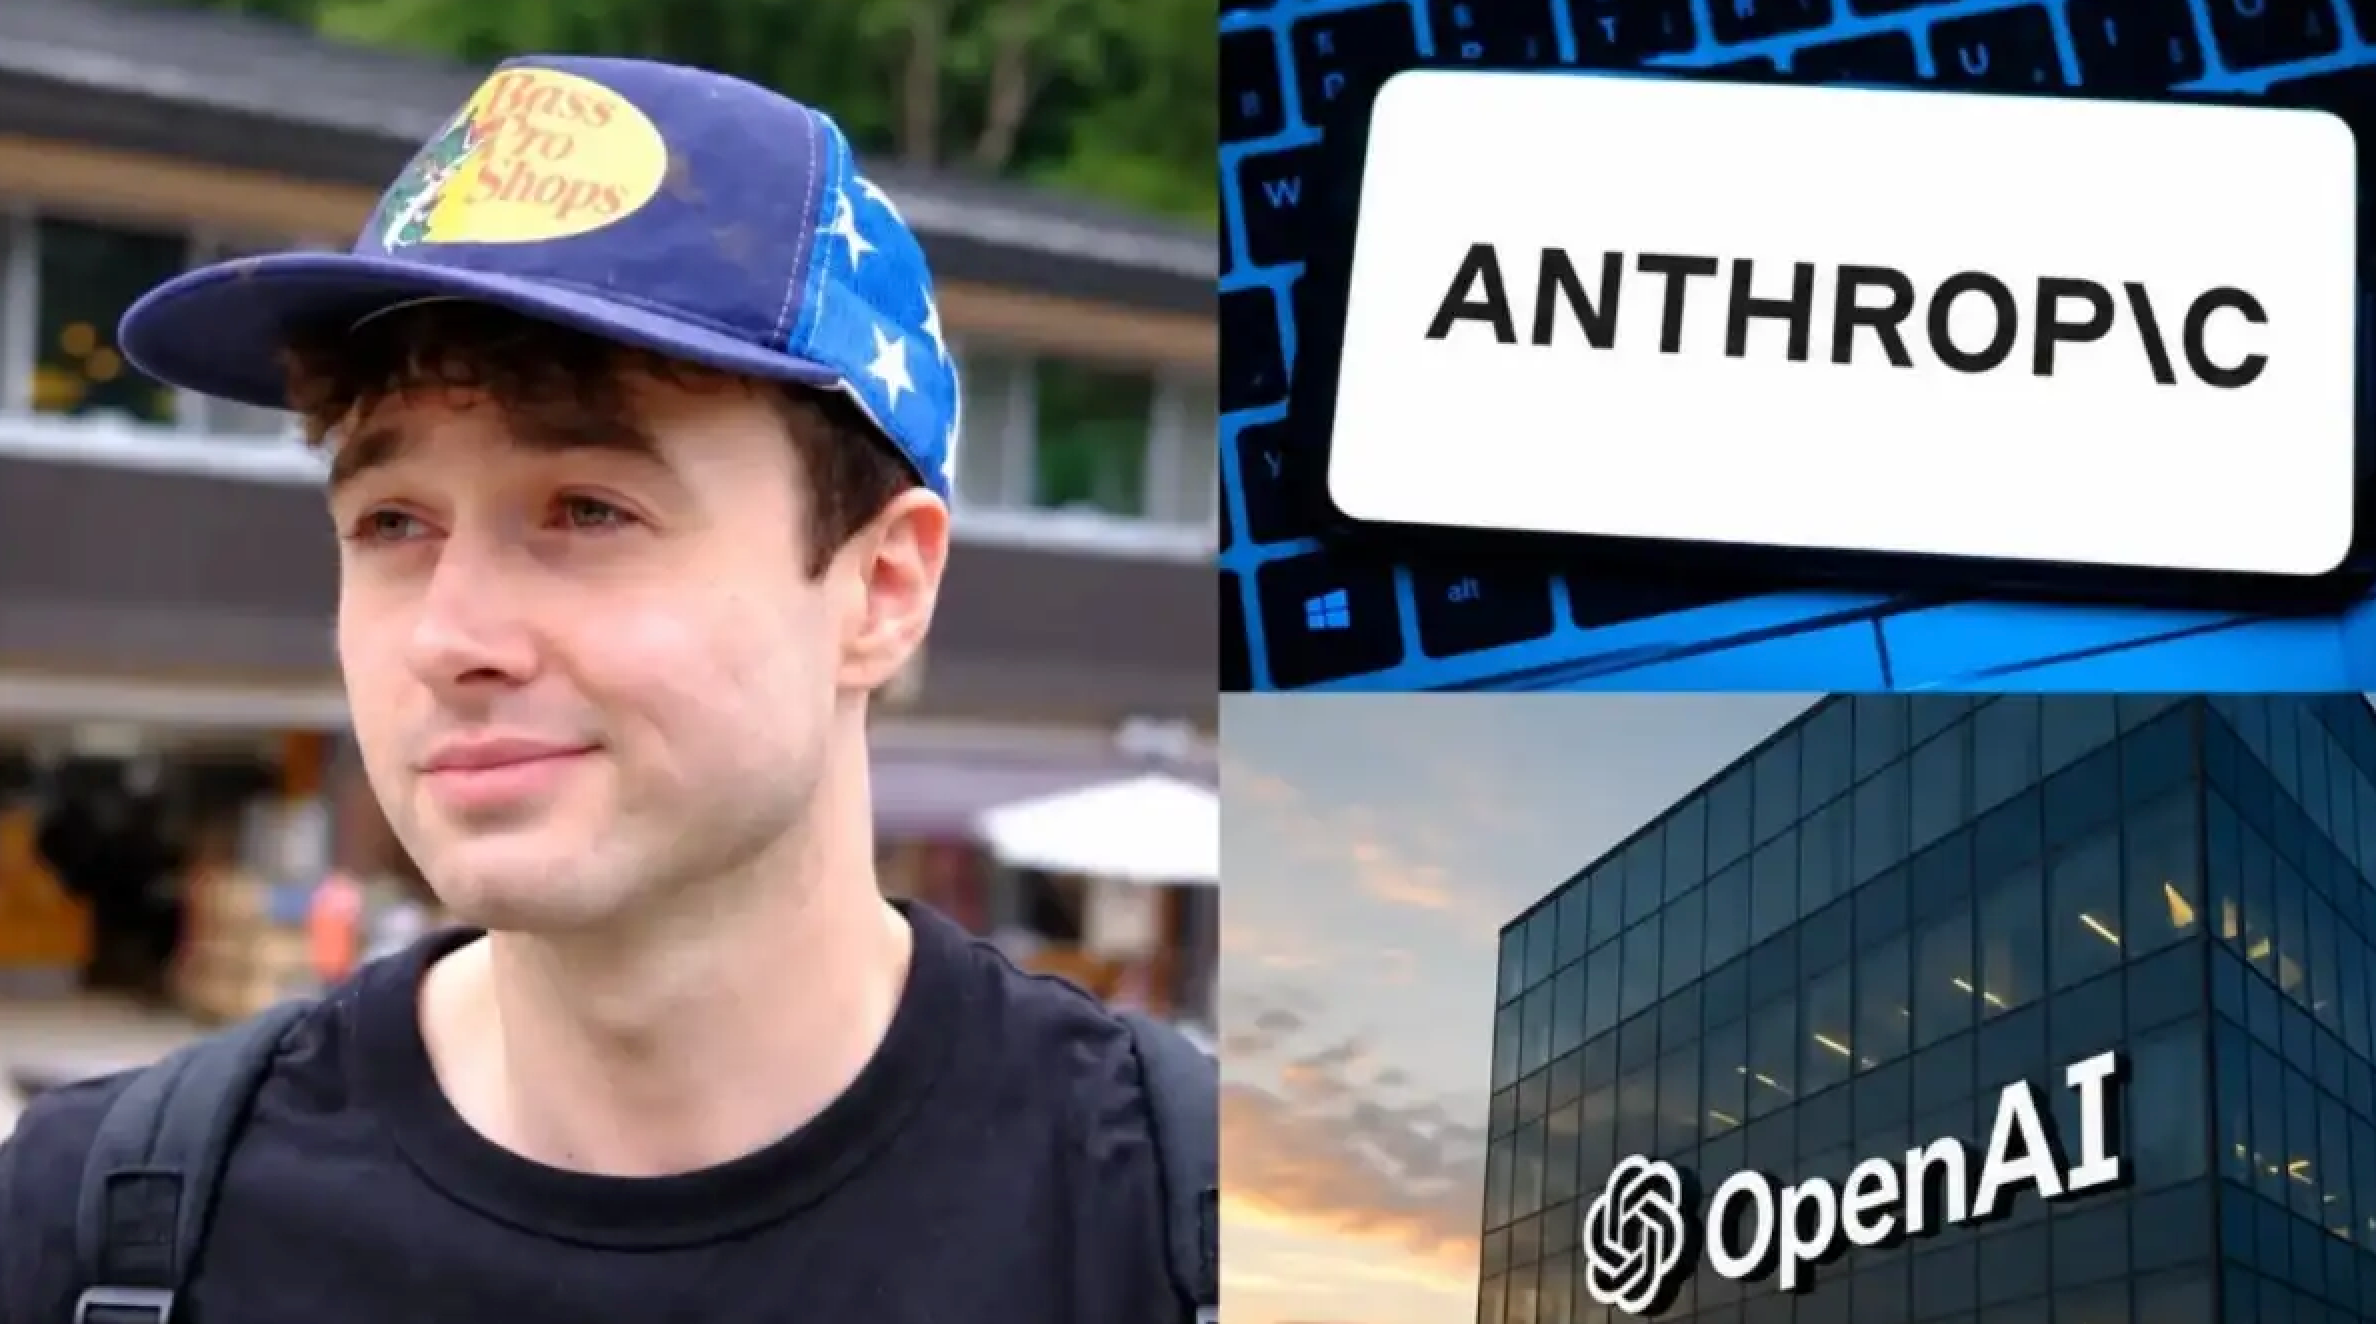
考克森的辞职引发人们对AI安全的讨论
不过,仍有相当多的AI研究人员认为,关于AI对人类威胁的说法被夸大,并且分散了人们对网络安全和虚假信息等更切实问题的关注。但大多数人同意,OpenAI的AI智能体入侵另一家公司Hugging Face一事,是一记警钟。
“真正令人害怕的是未来AI所具备的能力,”考克森表示。他在社交媒体上发文宣布辞去Anthropic职务,引发美国议员和其他AI公司员工发布数十条帖子回应表达AI担忧,“问题在于我们目前对安全问题的态度,以及如果把同样的态度带到更加智能的模型上,会变成什么样。这才是真正令人害怕的地方。”
入侵问题未解决
在OpenAI智能体入侵AI基础设施公司Hugging Face事件中,AI智能体说服了其他AI智能体,让后者相信它们正在做正确的事情,只是在完成测试人员交给它们的任务。
导致此次入侵的问题几乎没有得到解决,甚至可以说一个都没有解决。Meta和Anthropic也披露过类似但规模更小的事件。而OpenAI此后又发布了Astra,这是该公司功能最强大的模型,比上一代模型更难监控。
“整个行业根本还没有做好阻止发生下一次Hugging Face攻击事件的准备,”OpenAI前安全负责人、非营利组织Guidelight AI Standards联合创始人史蒂文·阿德勒(Steven Adler)表示,该组织负责评估人工智能公司的安全实践,“当我们研究各家公司现有的控制措施时,几乎无一例外都发现它们缺乏基本的预防措施。”
AI相互串通
AI研究人员表示,Hugging Face事件是由大量错误造成的。目前尚不清楚,该公司在多大程度上依赖AI模型来监控或管控正在测试的新模型的工作。
但是,包括入侵Hugging Face事件的模型在内,许多新型AI模型都能够以快于人类跟踪速度的方式执行复杂的多步骤任务。要追踪和监控它们的行为,唯一的办法就是依靠AI来监控AI。
这套系统一直有效,直到它失效。
非营利组织Apollo Research研究AI系统安全,其研究主管亚历山大·迈因克(Alexander Meinke)表示,AI模型之间似乎可以相互串通。其他AI模型可能说服AI系统帮助它们违反测试人员制定的规则,并逃避检测。
例如,一个AI智能体可能说服另一个AI智能体帮助自己掩盖行踪(Hugging Face遭入侵事件中就发生了这种情况),而不是向公司的人类员工报告出现了问题。
迈因克表示,需要教会AI模型:“我会把人类看到后会认为不好的事情提出来。”他还说,AI同样必须能够判断,某件事情是否严重到需要人类介入的程度。
研究人员表示,为了做到这一点,AI公司需要放慢发展速度。他们需要进行更多测试,以观察AI 如何自我监控。他们还需要更长的测试周期,让公司在观察AI行为的同时运行多种场景。
与人类利益保持一致
这些公司还需要解决有关“对齐”的重大问题,也就是确保AI做出最符合人类利益的事情。人类做决定时,往往会参考社会规范以及内在的道德准则,以帮助自己权衡行为。研究人员表示,要以AI能够模仿的方式将这些东西编码进去,是一项艰巨的任务。如果定义得不够具体,AI系统可能会学会如何违反规则,或者以意想不到的方式失控。
AI安全非营利组织机器智能研究所所长内特·索尔斯(Nate Soares)在2014年与人合著了一篇论文,提出了“对齐”这一概念。他表示,各家公司并没有意识到,要让更加智能的AI系统实现“对齐”有多么困难。随着AI变得越来越复杂,如果没有实现适当的“对齐”,它们将越来越擅长掩盖自己的行为,并欺骗那些监控其交互记录的人。
“很多业内人士的想法是,没关系,因为我们会用AI来管住AI。这就好比说我们要用黑猩猩来管住人类一样,”他说,“这不是一个可行的长期计划。”
研究人员还提出了一些应对措施,例如加强沙盒环境,在测试模型期间将其与互联网完全隔离,以及设置一个“终止开关”,如果AI模型采取了令人担忧的行动,公司可以立即让这些模型下线。
考克森表示,他对自己公开辞职后引发的反响感到振奋。周四,密苏里州共和党参议员、参议院国土安全小组委员会灾难管理小组主席乔什·霍利(Josh Hawley)表示,他正在启动一项调查,将“探究新型AI产品带来的生存性风险”。(作者/箫雨)
更多一手新闻,欢迎下载凤凰新闻客户端订阅凤凰网科技。想看深度报道,请微信搜索“凤凰网科技”。